Ollama-Grundkonzepte
Ollama ist ein lokalisiertes Machine-Learning-Framework, das mehrere Aufgaben der Verarbeitung natürlicher Sprache (NLP) unterstützt, mit Schwerpunkt auf Modellladen, Inferenz und Generierungsaufgaben.
Mit Ollama können Benutzer bequem mit großen vorab trainierten, lokal bereitgestellten Modellen interagieren.
1. Modell
In Ollama sind Modelle die Kernkomponente. Sie sind vorab trainierte Machine-Learning-Modelle, die verschiedene Aufgaben ausführen können, wie Textgenerierung, Textzusammenfassung, Sentimentanalyse, Dialoggenerierung und mehr.
Ollama unterstützt eine Vielzahl beliebter vorab trainierter Modelle. Zu den gängigen Modellen gehören:
- deepseek-v3: Ein großes Sprachmodell von DeepSeek, das speziell für Textgenerierungsaufgaben verwendet wird.
- LLama2: Ein großes Sprachmodell von Meta, das speziell für Textgenerierungsaufgaben verwendet wird.
- GPT: Die GPT-Serienmodelle von OpenAI, geeignet für eine Vielzahl von Aufgaben wie Dialoggenerierung und Textschlussfolgerung.
- BERT: Vorab trainierte Modelle, die für Satzverständnis und Frage-Antwort-Systeme verwendet werden.
- Andere benutzerdefinierte Modelle: Benutzer können ihre eigenen benutzerdefinierten Modelle hochladen und Ollama für die Inferenz verwenden.
Hauptfunktionen des Modells:
- Inferenz: Erzeugt Ausgabeergebnisse basierend auf der Benutzereingabe.
- Fine-Tuning: Benutzer können mit ihren eigenen Daten auf bestehenden Modellen aufbauend trainieren und so das Modell an spezifische Aufgaben oder Domänen anpassen.
Modelle sind typischerweise neuronale Netze, die aus einer großen Anzahl von Parametern bestehen. Durch Training mit großen Mengen an Textdaten können sie Sprachmuster erlernen und effiziente Inferenz durchführen.
Von Ollama unterstützte Modelle sind abrufbar unter:https://ollama.com/library
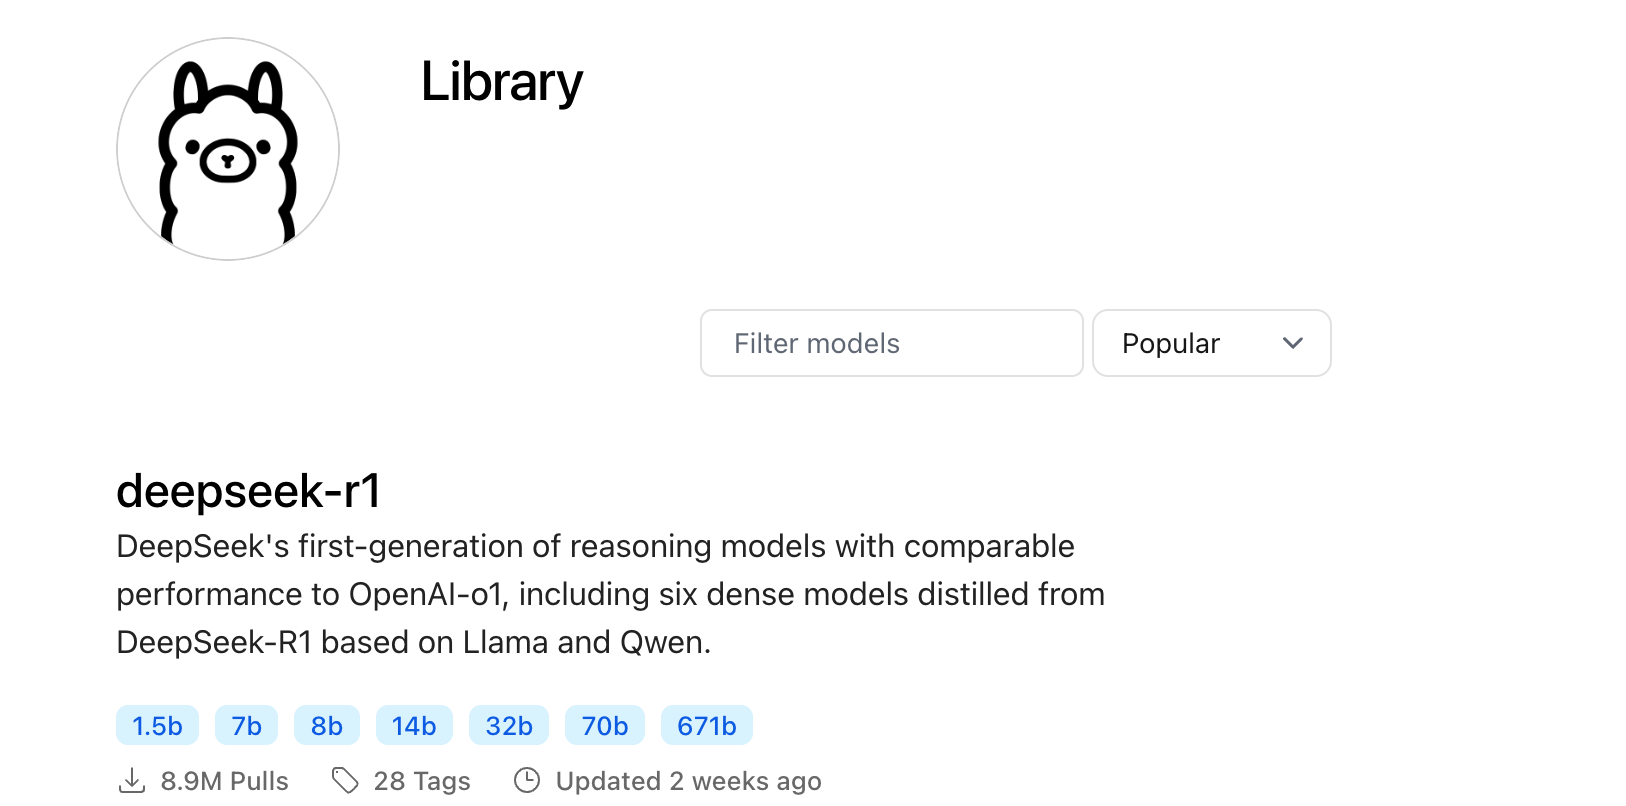
Klicken Sie auf ein Modell, um den Download-Befehl anzuzeigen:
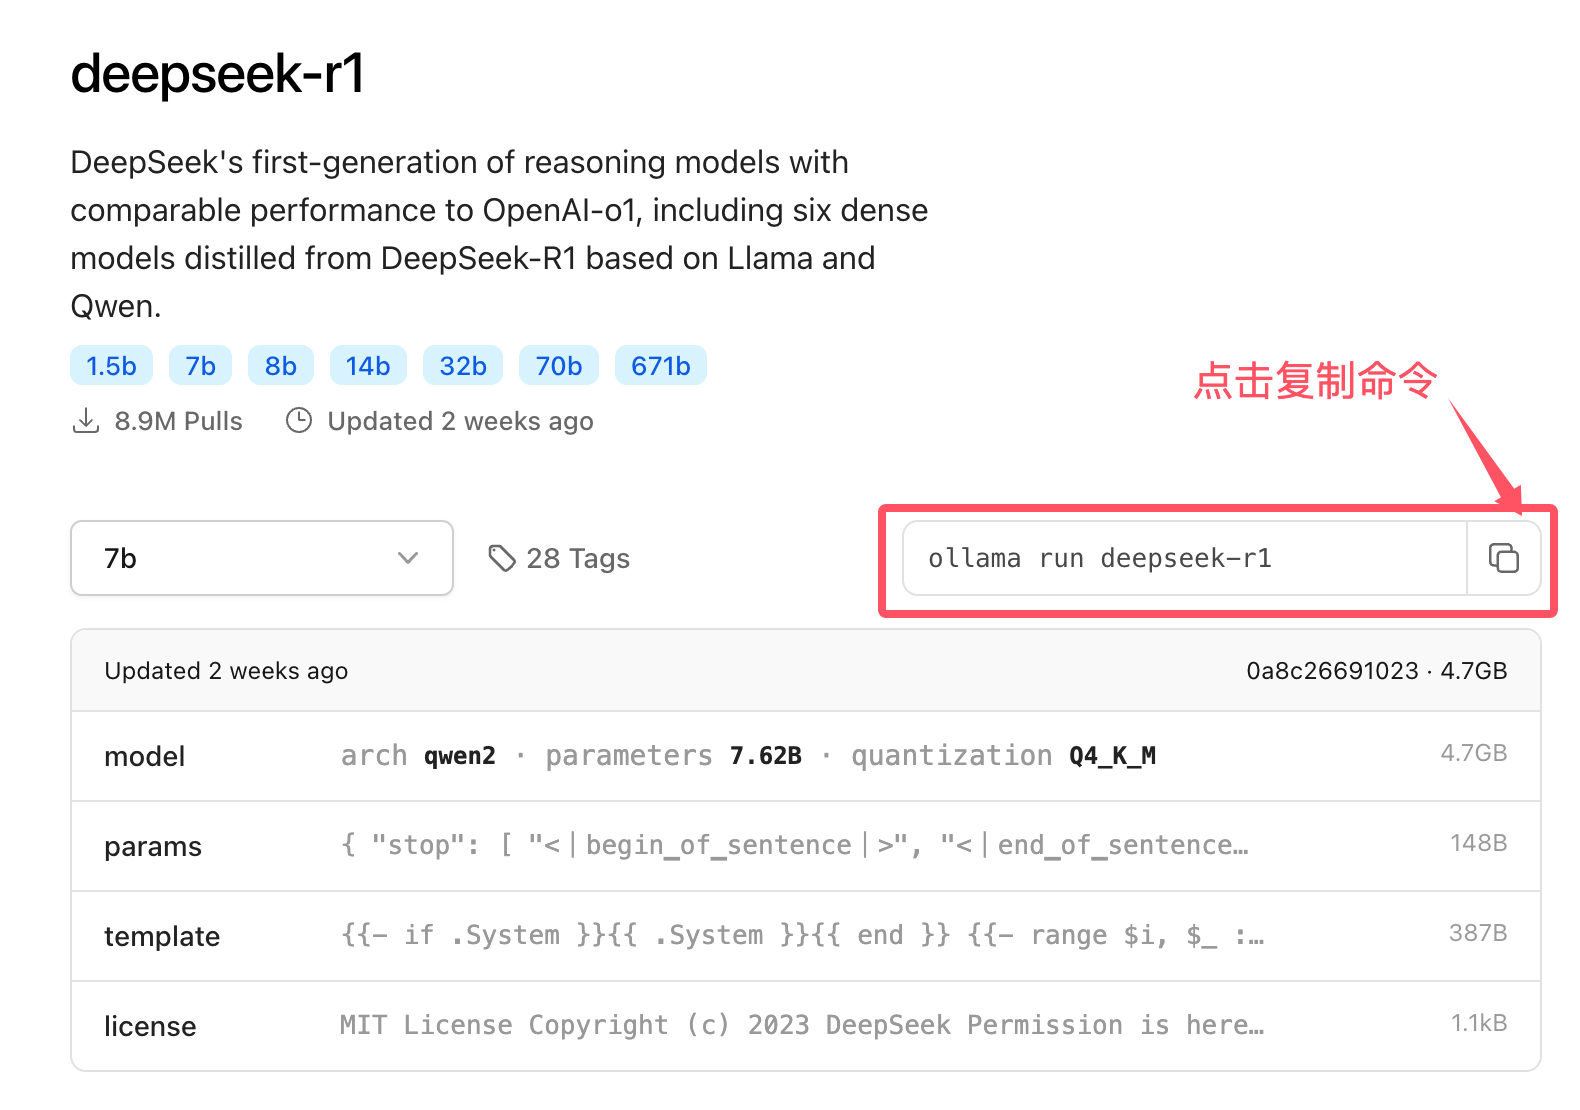
Die folgende Tabelle listet Download-Befehle für einige Modelle auf:
| Modell | Parameters | Size | Download-Befehl |
|---|---|---|---|
| Llama 3.3 | 70B | 43GB | ollama run llama3.3 |
| Llama 3.2 | 3B | 2.0GB | ollama run llama3.2 |
| Llama 3.2 | 1B | 1.3GB | ollama run llama3.2:1b |
| Llama 3.2 Vision | 11B | 7.9GB | ollama run llama3.2-vision |
| Llama 3.2 Vision | 90B | 55GB | ollama run llama3.2-vision:90b |
| Llama 3.1 | 8B | 4.7GB | ollama run llama3.1 |
| Llama 3.1 | 405B | 231GB | ollama run llama3.1:405b |
| Phi 4 | 14B | 9.1GB | ollama run phi4 |
| Phi 3 Mini | 3.8B | 2.3GB | ollama run phi3 |
| Gemma 2 | 2B | 1.6GB | ollama run gemma2:2b |
| Gemma 2 | 9B | 5.5GB | ollama run gemma2 |
| Gemma 2 | 27B | 16GB | ollama run gemma2:27b |
| Mistral | 7B | 4.1GB | ollama run mistral |
| Moondream 2 | 1.4B | 829MB | ollama run moondream |
| Neural Chat | 7B | 4.1GB | ollama run neural-chat |
| Starling | 7B | 4.1GB | ollama run starling-lm |
| Code Llama | 7B | 3.8GB | ollama run codellama |
| Llama 2 Uncensored | 7B | 3.8GB | ollama run llama2-uncensored |
| LLaVA | 7B | 4.5GB | ollama run llava |
| Solar | 10.7B | 6.1GB | ollama run solar |
2. Aufgabe
Ollama unterstützt eine Vielzahl von NLP-Aufgaben. Jede Aufgabe entspricht unterschiedlichen Anwendungsszenarien des Modells, wobei sie hauptsächlich die folgenden umfassen, aber nicht darauf beschränkt sind:
- Chat-Generierung: Erzeugt natürliche Konversationsantworten durch Interaktion mit Benutzern.
- Textgenerierung: Erzeugt natürlichen Sprachtext basierend auf einer gegebenen Eingabeaufforderung, z. B. das Schreiben von Artikeln oder das Generieren von Geschichten.
- Sentimentanalyse: Analysiert die Stimmung bzw. Ausrichtung eines gegebenen Textes (z. B. positiv, negativ, neutral).
- Textzusammenfassung: Komprimiert langen Text zu einer prägnanten Zusammenfassung.
- Übersetzung: Übersetzt Text von einer Sprache in eine andere.
Über das Befehlszeilentool können Benutzer verschiedene Aufgaben angeben und verschiedene Modelle laden, um bestimmte Aufgaben zu erledigen.
3. Inferenz
Inferenz bezeichnet den Prozess, Eingaben auf einem trainierten Modell zu verarbeiten und Ausgaben zu generieren.
Ollama bietet ein benutzerfreundliches Kommandozeilen-Tool oder eine API, mit der Benutzer dem Modell schnell Eingaben übermitteln und Ergebnisse erhalten können.
Inferenz ist eine der Hauptfunktionen von Ollama und der Kern der Interaktion mit Modellen.
Inferenzprozess:
- Eingabe: Der Benutzer stellt dem Modell eine Texteingabe bereit, die eine Frage, ein Prompt oder Gesprächsinhalt sein kann.
- Modellverarbeitung: Das Modell verwendet sein integriertes neuronales Netzwerk, um basierend auf der Eingabe eine passende Ausgabe zu generieren.
- Ausgabe: Das Modell gibt den generierten Textinhalt zurück; dieser kann eine Antwort, ein generierter Artikel, übersetzter Text usw. sein.
Ollama interagiert über API oder CLI mit lokalen Modellen, sodass Benutzer Inferenzaufgaben einfach durchführen können.
4. Feinabstimmung
Feinabstimmung bezeichnet das weitere Training eines vortrainierten Modells anhand spezifischer Domänendaten, damit das Modell bei bestimmten Aufgaben oder Domänen bessere Leistungen erbringt.
Ollama unterstützt die Feinabstimmung. Benutzer können eigene Datensätze verwenden, um vortrainierte Modelle feinabzustimmen und die Modellausgabe anzupassen.
Feinabstimmungsprozess:
- Datensatz vorbereiten: Der Benutzer bereitet einen Datensatz für eine bestimmte Domäne vor. Das Datenformat ist üblicherweise ein Textdatei- oder JSON-Format.
- Vortrainiertes Modell laden: Wählen Sie ein vortrainiertes Modell, das für die Feinabstimmung geeignet ist, wie Llama2- oder GPT-Modelle.
- Trainieren: Trainieren Sie das Modell mit dem spezifischen Datensatz des Benutzers, damit es sich besser an die Zielaufgabe anpassen kann.
- Speichern und bereitstellen: Nach Abschluss des Trainings kann das feinabgestimmte Modell gespeichert und für die zukünftige Verwendung bereitgestellt werden.
Feinabstimmung hilft dem Modell, genauer und effizienter zu werden, wenn es mit domänenspezifischen Problemen umgeht.
Andere Erweiterungen