Введение в Ollama
Ollama — это открытая платформа больших языковых моделей (LLM), позволяющая пользователям легко запускать, управлять большими языковыми моделями и взаимодействовать с ними локально.
Ollama предоставляет простой способ загрузки и использования различных предварительно обученных языковых моделей, поддерживая множество задач обработки естественного языка, таких как генерация текста, перевод, написание кода и ответы на вопросы.
Особенность Ollama в том, что она не только предоставляет готовые модели и наборы инструментов, но и предлагает удобные интерфейсы и API, что позволяет быстро реализовывать задачи от генерации текста и диалоговых систем до семантического анализа.
В отличие от других фреймворков NLP, Ollama стремится упростить рабочие процессы пользователей, делая машинное обучение областью, доступной не только разработчикам с глубокой технической подготовкой.
Ollama поддерживает несколько вариантов аппаратного ускорения, включая вывод только на CPU и различные базовые вычислительные архитектуры (например, Apple Silicon), что позволяет лучше использовать разные типы аппаратных ресурсов.

Ollama — это локальная среда выполнения моделей, состоящая из четырёх частей.
| Компонент | Описание | Где |
|---|---|---|
| Инструмент командной строки | Точка входа для всех повседневных операций, таких как run, pull, list | Команда ollama в системном PATH |
| Фоновый сервис | Работает постоянно, отвечает за загрузку моделей и инференс, а также предоставляет REST API наружу | Локальный порт 11434 |
| Библиотека моделей | Официальные каналы распространения различных моделей с открытым исходным кодом, классифицированные по тегам возможностей | ollama.com/library |
| Локальное хранилище | Загруженные веса и конфигурации моделей | Папка .ollama в каталоге пользователя |
Новая версия также предоставляет две более удобные точки входа: ввод ollama напрямую открывает интерактивное меню, а использование ollama launch подключает локальные модели к таким инструментам, как Claude Code и VS Code, в один клик.
Основные возможности и характеристики
-
Поддержка нескольких предобученных языковых моделей
Ollama предоставляет множество готовых предобученных моделей, включая распространённые большие языковые модели, такие как GPT и BERT. Пользователи могут легко загружать и использовать эти модели для таких задач, как генерация текста, анализ тональности и ответы на вопросы. -
Простая интеграция и использование
Ollama предоставляет инструмент командной строки (CLI) и Python SDK, что упрощает интеграцию с другими проектами и сервисами. Разработчикам не нужно беспокоиться о сложных зависимостях или конфигурациях, и они могут быстро интегрировать Ollama в существующие приложения. -
Локальное развёртывание и офлайн-использование
В отличие от некоторых облачных сервисов NLP, Ollama позволяет разработчикам запускать модели в локальных вычислительных средах. Это означает, что можно устранить зависимость от внешних серверов, обеспечить конфиденциальность данных, а для запросов с высокой конкурентностью офлайн-развёртывание может обеспечить меньшую задержку и большую управляемость. -
Поддержка тонкой настройки и кастомизации моделей
Пользователи могут не только использовать предобученные модели, предоставляемые Ollama, но и дообучать модели на их основе. В соответствии со своими конкретными потребностями разработчики могут переобучать модели на собственных собранных данных, чтобы оптимизировать производительность и точность модели. -
Оптимизация производительности
Ollama ориентирована на производительность, предоставляет эффективный механизм инференса, поддерживает пакетную обработку и эффективно управляет памятью и вычислительными ресурсами. Это позволяет ей оставаться эффективной при обработке крупномасштабных данных. -
Кроссплатформенная поддержка
Ollama поддерживает работу в нескольких операционных системах, включая Windows, macOS и Linux. Это обеспечивает единообразный опыт независимо от того, отлаживают ли разработчики в локальной среде или предприятия развёртывают в production. -
Открытый исходный код и поддержка сообщества
Ollama — это проект с открытым исходным кодом, что означает, что разработчики могут просматривать исходный код, изменять и оптимизировать его, а также вносить вклад в проект. Кроме того, у Ollama есть активное сообщество, где разработчики могут получать помощь и обмениваться опытом с другими.
Сценарии применения
-
Создание контента:
Помогает писателям, журналистам и маркетологам быстро создавать высококачественный контент, например посты в блогах, рекламные тексты и многое другое. -
Помощь в программировании::
Помогает разработчикам генерировать код, отлаживать программы или оптимизировать структуры кода. -
Образование и исследования:
Помогает студентам и исследователям в обучении, написании текстов и исследованиях, например создавать аннотации к статьям или отвечать на вопросы. -
Межъязыковая коммуникация:
Предоставляет высококачественные возможности перевода, помогая пользователям преодолевать языковые барьеры. -
Личный помощник:
Выступает в роли интеллектуального помощника, помогая пользователям выполнять повседневные задачи, например писать электронные письма, создавать списки дел и многое другое.
Почему стоит запускать большие модели локально
Запуск локально — это не ностальгия; это основано на четырёх веских причинах.
Конфиденциальность: Данные никогда не покидают устройство. Для контента, который не может покинуть локальную машину, например черновиков договоров, медицинских записей и приватного кода, всегда приходится взвешивать риски перед использованием облачных API, тогда как локальный инференс естественным образом избегает этой проблемы.
Стоимость: Оплата за каждый токен отсутствует. Загрузка модели стоит только дискового пространства и электроэнергии единоразово, а предельные затраты приближаются к нулю при интенсивном использовании, что особенно удобно для сценариев, требующих пакетной обработки текста.
Офлайн: Нет зависимости от сети. В средах интранета, серверных или на самолётах, пока устройство есть, модель есть; это жёсткое требование для развёртывания на объекте и регионов с плохим подключением.
Управляемость: Версии и поведение предсказуемы. Локальные модели не обновляются тихо и не меняют своё поведение; форматы вывода, проверенные сегодня, не изменятся завтра. Для production-систем это важнее, чем быть «мощнее».
Конечно, если честно: потолок возможностей локальных open-source-моделей в настоящее время всё ещё ниже, чем у облачных флагманских моделей. Выбор локального решения — это про «достаточно хорошее, управляемое и дешёвое», а не «всесильное».
Отличия от облачных API и применимые сценарии
Если поставить оба подхода рядом, критерии выбора становятся ясны.
| Измерение | Ollama локально | Облачный API (OpenAI, Claude и т. д.) |
|---|---|---|
| Расположение данных | Никогда не покидает локальную машину | Загружается на серверы провайдера |
| Источник вычислений | Ваш собственный CPU / GPU | Дата-центр провайдера |
| Модель оплаты | Однократная загрузка, бесплатное использование | Непрерывная оплата за токены |
| Мощность модели | Ограничена локальным оборудованием | Доступны лучшие флагманские модели |
| Доступность офлайн | Полностью доступно | Недоступно |
| Стоимость начала работы | Установите ПО один раз, настройте оборудование один раз | Готово к использованию после регистрации, но нужно управлять ключами и счетами |
Применимые сценарии также становятся понятны: выбирайте локальный вариант для конфиденциальных данных, высокочастотных вызовов, офлайн-сред и проверки при обучении и разработке; выбирайте облачные API, когда нужны возможности моделей топового уровня, пиковая эластичная нагрузка или у вас нет собственного GPU.
Эти два подхода не враги; зрелые продукты часто используют гибридную архитектуру: повседневные запросы обрабатываются локально, а несколько сложных задач перенаправляются в облако.
Сравнение с другими локальными решениями
Запуск больших моделей локально не ограничивается Ollama; у каждого распространённого решения своя аудитория.
| Решение | Позиционирование | Простота начала работы | Целевая аудитория |
|---|---|---|---|
| Ollama | Среда выполнения, запускающая модели одной командой + локальный API-сервис | Низкая | Большинство разработчиков, команды, которым нужна быстрая интеграция |
| llama.cpp | Сам высокопроизводительный движок вывода, с множеством параметров и детальным контролем | Высокая | Пользователи, которые хотят углубиться в детали инференса и настроить развёртывание |
| LM Studio | Настольное приложение с графическим интерфейсом, со встроенным просмотром и загрузкой моделей | Низкая | Пользователи, предпочитающие графический интерфейс и не желающие использовать командную строку |
| vLLM | Высокопроизводительный инференс-сервис промышленного уровня для GPU-серверов | Высокая | Команды с высоконагруженными онлайн-сервисами и большими вычислительными ресурсами |
| GPT4All | Лёгкое настольное приложение, сосредоточенное на локальном диалоге с документами | Низкая | Обычные пользователи без технической подготовки |
Их связь стоит упомянуть: лежащая в основе способность Ollama к инференсу исходит из llama.cpp, что можно понимать как «простую в использовании обёртку + сервис-ориентированность + экосистему библиотеки моделей», построенную поверх llama.cpp.
Это руководство выбирает Ollama в качестве основной линии из-за её баланса: минимум команд, полное покрытие трёх платформ и наиболее полный API и экосистема инструментов. Сравнение основано на публичной информации и состоянии проектов по состоянию на август 2026 года; все решения быстро развиваются.
Локальные модели против Ollama Cloud
Предыдущие сравнения были посвящены «облакам других провайдеров». Сама Ollama также предлагает облачное решение, которое дополняет три способа использования больших моделей.

Опыт использования Ollama Cloud почти такой же, как локально: добавьте суффикс `:cloud` к имени модели, войдите в свою учётную запись и запускайте её напрямую. Локальные команды, API и интеграции с инструментами работают как есть, за исключением того, что инференс прозрачно перенаправляется на серверы Ollama.
Примеры
ollama signin
# Запускайте облачные модели как локальные, без необходимости скачивать веса
ollama run qwen3.5:cloud
Его ценность проявляется в двух сценариях: сверхбольшие модели, с которыми не справится ваша локальная вычислительная мощность, и «проверка, стоит ли более крупная модель того» перед покупкой нового компьютера.
У облачных моделей есть механизм вывода из эксплуатации: официальная команда периодически снимает с эксплуатации старые облачные модели и объявляет о заменах. Автоматизированным рабочим процессам, которые зависят от них, нужно следить за уведомлениями; локальные модели навсегда остаются на вашем диске, и это их не затрагивает. Эта тема полностью раскрыта в главе «Гибридное облачное развёртывание».
Требования к оборудованию и ожидания
И последнее: оцените собственную машину. Ollama на удивление нетребовательна к оборудованию — она может работать на одном только CPU, правда, скорость при этом отличается на порядок.
С дискретной GPU (NVIDIA, AMD) или чипом Apple Silicon инференс ускоряется с помощью GPU, а скорость генерации обычно в несколько раз, а то и в десятки раз выше, чем на чистом CPU.
Размер окна контекста по умолчанию автоматически задаётся Ollama по уровням в зависимости от VRAM:
| Объём VRAM | Длина контекста по умолчанию |
|---|---|
| Менее 24GiB | 4K |
| 24 ~ 48GiB | 32K |
| 48GiB и выше | 256K |
Теперь посмотрите на ожидаемое соответствие между масштабом параметров и устройством (на примере семейства qwen3.5):https://ollama.com/library/qwen3.5):
| Характеристики модели | Размер загрузки | Рекомендуемая конфигурация | Ожидаемый опыт использования |
|---|---|---|---|
| qwen3.5:latest | Около 6.6GB | 16GB RAM или 8GB VRAM | Конфигурация по умолчанию, сбалансированное качество и скорость |
| qwen3.5:0.8b | Около 1.0GB | 8GB RAM достаточно | Среды для проверки, лёгкие разговоры |
| qwen3.5:4b | Около 3.4GB | 16GB RAM | Золотая середина для повседневного использования |
| qwen3.5:9b эквивалентен qwen3.5:latest | Около 6.6GB | 16GB RAM или 8GB VRAM | Конфигурация по умолчанию, сбалансированное качество и скорость |
| qwen3.5:27b | Около 17GB | 24GB VRAM | Ресурсоёмкие задачи, такие как длинные документы и код |
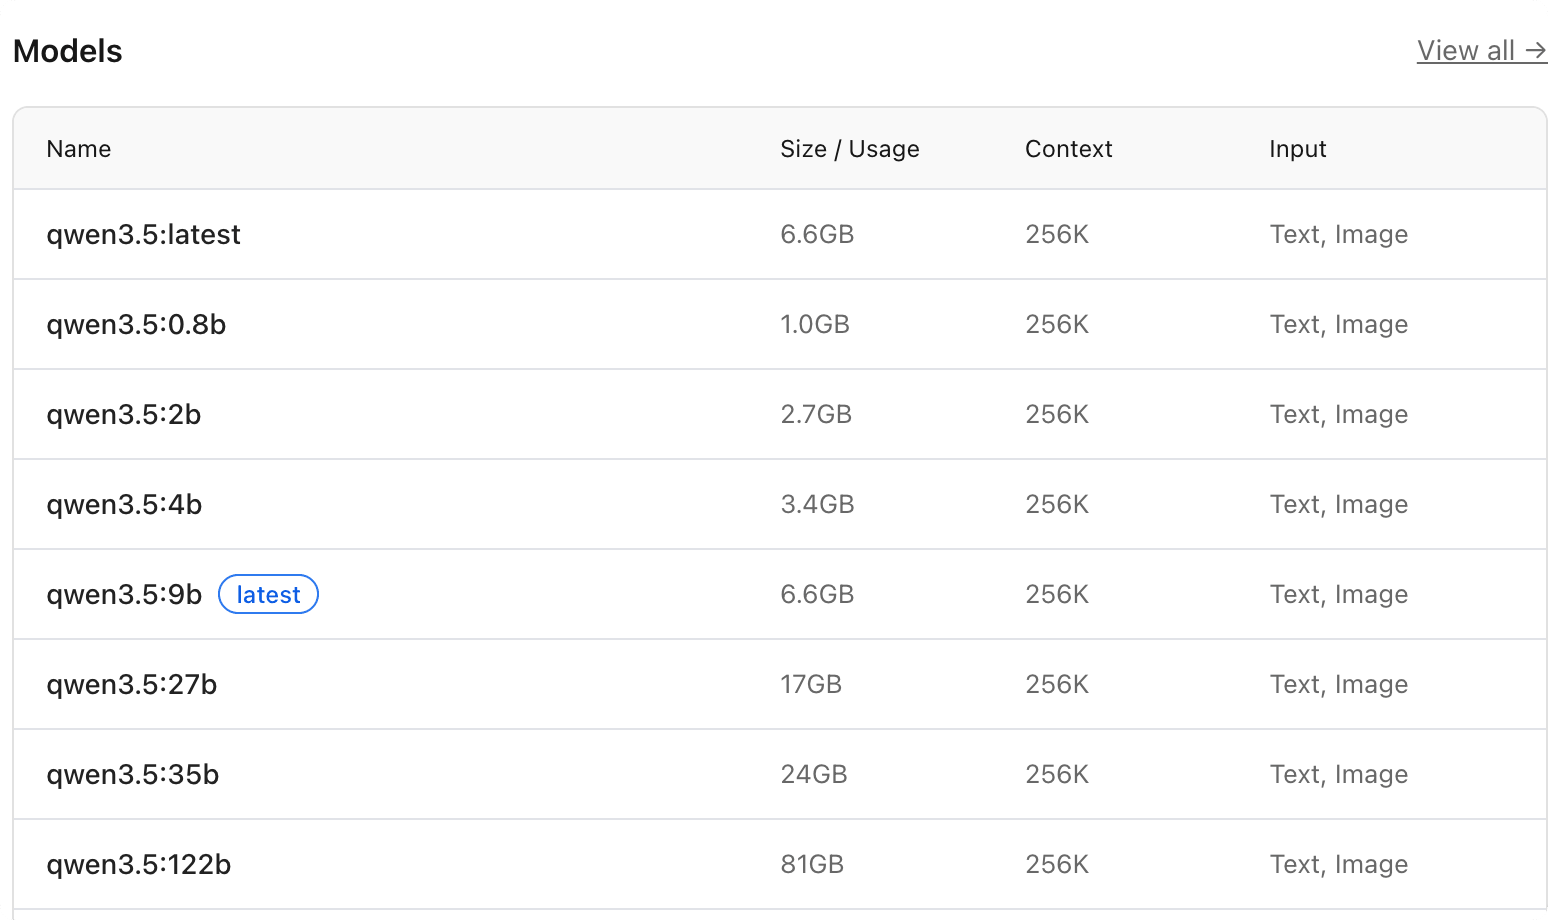
После запуска модели используйте командуollama ps, чтобы проверить столбец PROCESSOR и убедиться, действительно ли модель полностью работает на GPU. Этот шаг проверки будет неоднократно использоваться в главе об управлении моделями.
Другие расширенияНе расстраивайтесь, если ваша конфигурация действительно ограничена: спецификации 0.8b достаточно, чтобы пройти подавляющее большинство демонстраций команд в этом руководстве; а когда вам действительно понадобится более крупная модель, есть маршрут `:cloud`, не требующий оборудования.