Основные понятия Ollama
Ollama — это локализованный фреймворк машинного обучения, который поддерживает множество задач обработки естественного языка (NLP) и ориентирован на загрузку моделей, вывод и генерацию.
С Ollama пользователи могут удобно взаимодействовать с большими предварительно обученными моделями, развёрнутыми локально.
1. Модель
В Ollama модели являются основным компонентом. Это предварительно обученные модели машинного обучения, которые могут выполнять различные задачи, такие как генерация текста, суммирование текста, анализ тональности, генерация диалогов и многое другое.
Ollama поддерживает множество популярных предварительно обученных моделей. К распространённым моделям относятся:
- deepseek-v3: Большая языковая модель, предоставленная DeepSeek, специально используемая для задач генерации текста.
- LLama2: Большая языковая модель, предоставленная Meta, специально используемая для задач генерации текста.
- GPT: Модели серии GPT от OpenAI, подходящие для широкого круга задач, таких как генерация диалогов и текстовые рассуждения.
- BERT: Предварительно обученные модели, используемые для понимания предложений и вопросно-ответных систем.
- Другие пользовательские модели: Пользователи могут загружать свои собственные пользовательские модели и использовать Ollama для инференса.
Основные функции модели:
- Инференс: Генерирует выходные результаты на основе пользовательского ввода.
- Тонкая настройка: Пользователи могут обучать поверх существующих моделей, используя свои данные, тем самым настраивая модель под конкретные задачи или предметные области.
Модели обычно представляют собой нейронные сети, состоящие из большого числа параметров. Обучение на больших объёмах текстовых данных позволяет им изучать языковые закономерности и выполнять эффективный инференс.
Модели, поддерживаемые Ollama, можно найти по адресу:https://ollama.com/library
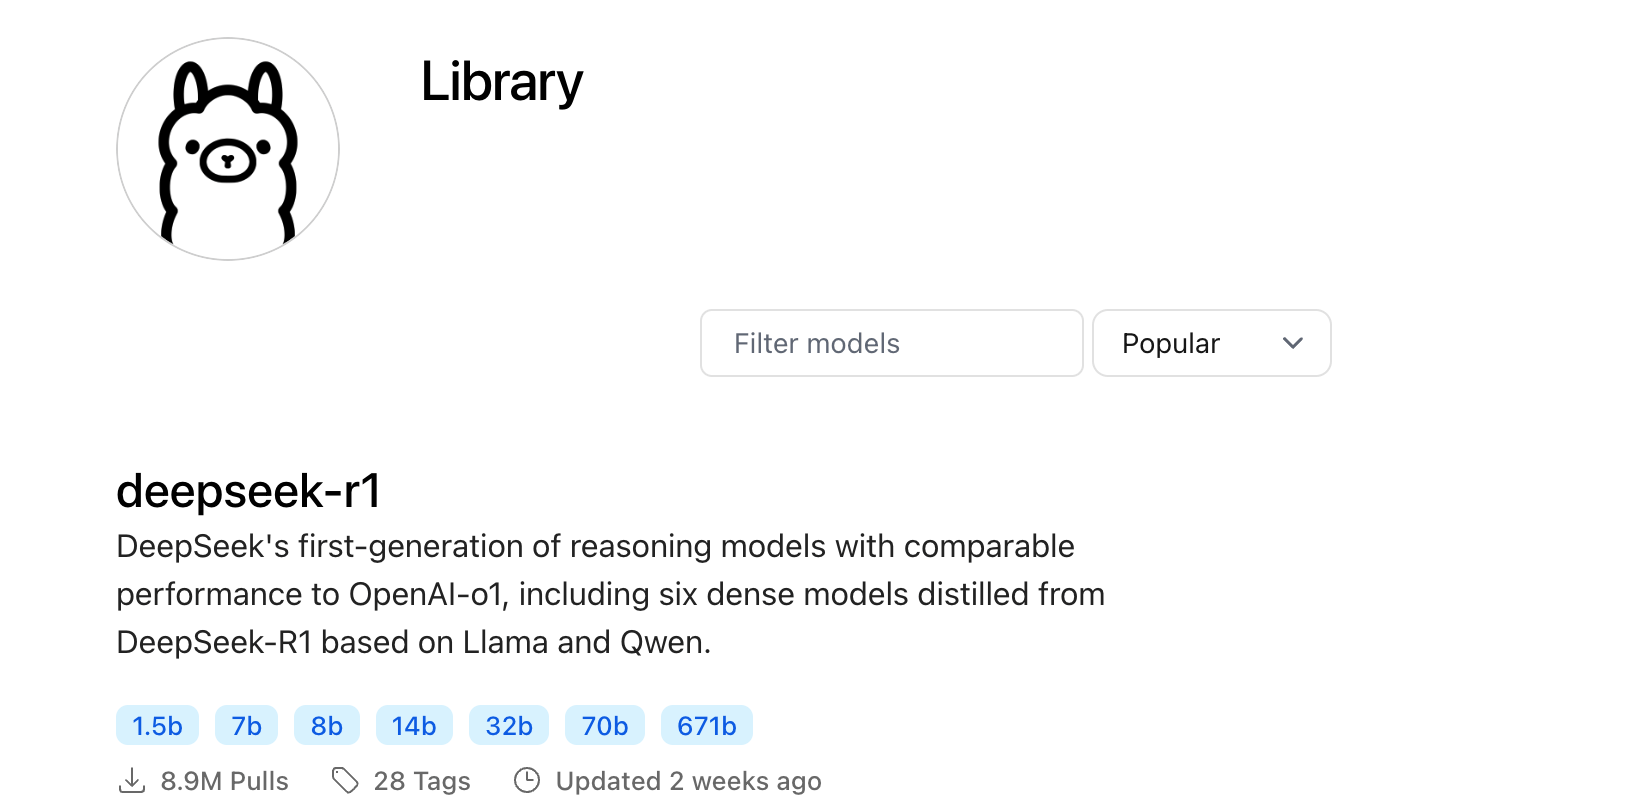
Нажмите на модель, чтобы просмотреть команду загрузки:
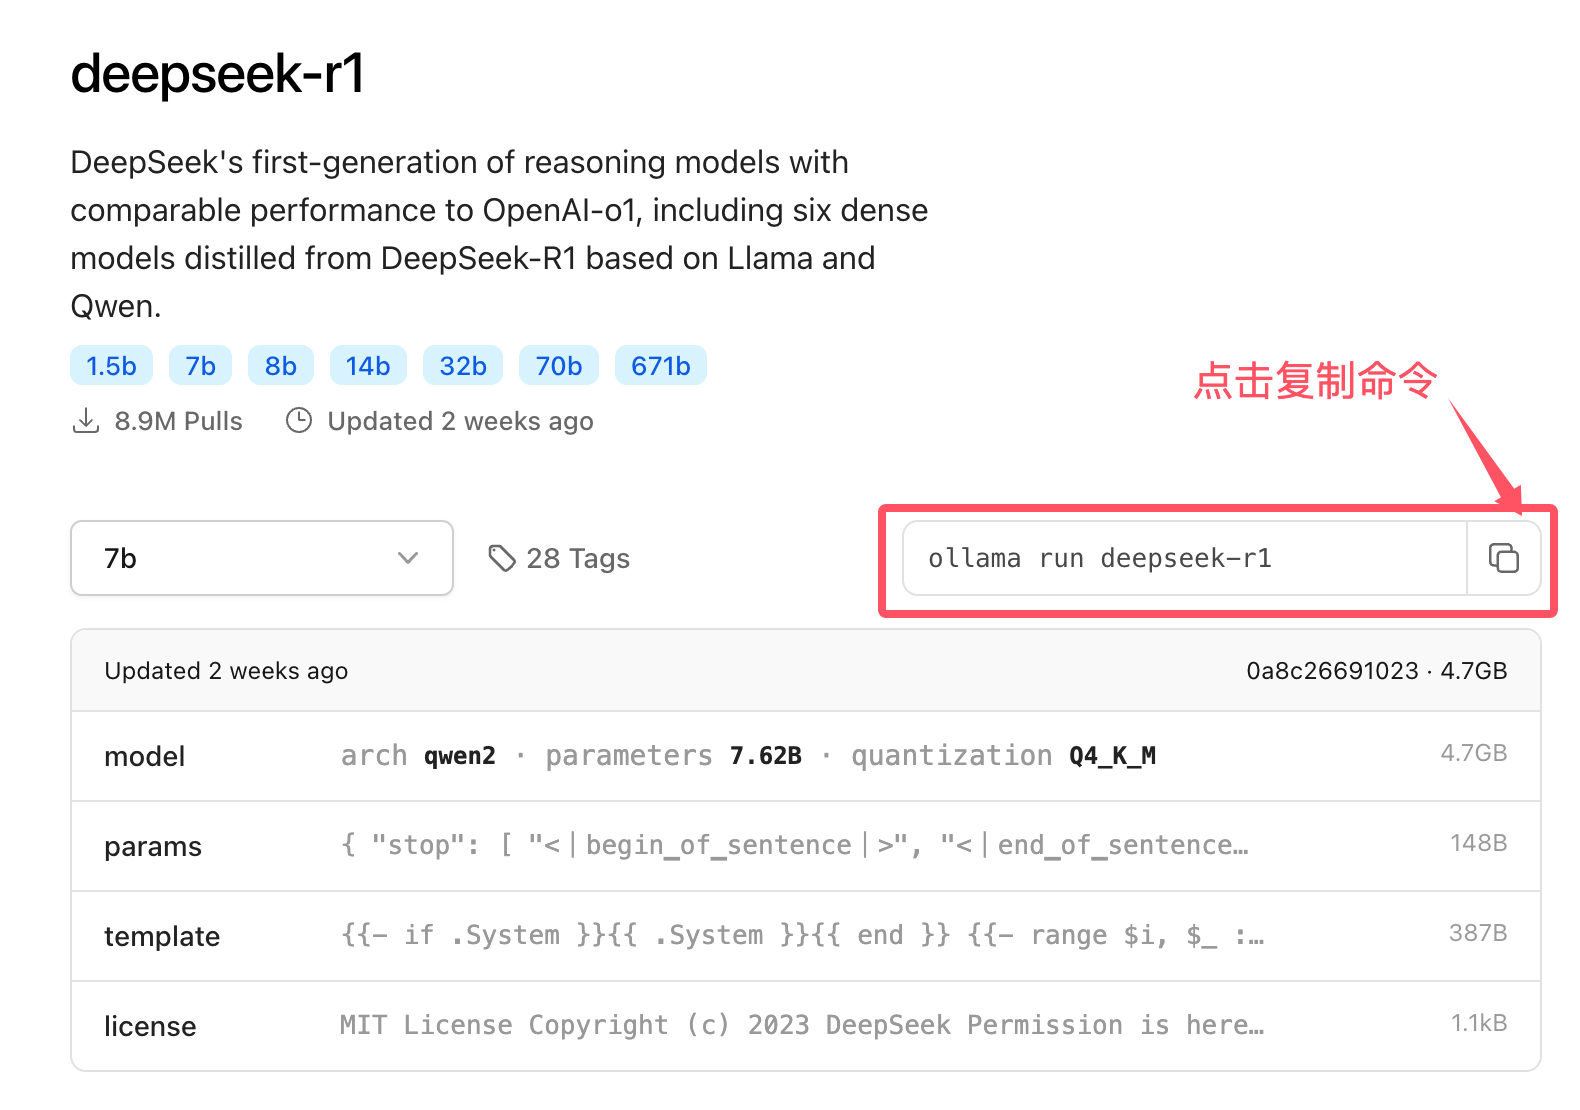
В следующей таблице перечислены команды загрузки для некоторых моделей:
| Модель | Parameters | Size | Команда загрузки |
|---|---|---|---|
| Llama 3.3 | 70B | 43GB | ollama run llama3.3 |
| Llama 3.2 | 3B | 2.0GB | ollama run llama3.2 |
| Llama 3.2 | 1B | 1.3GB | ollama run llama3.2:1b |
| Llama 3.2 Vision | 11B | 7.9GB | ollama run llama3.2-vision |
| Llama 3.2 Vision | 90B | 55GB | ollama run llama3.2-vision:90b |
| Llama 3.1 | 8B | 4.7GB | ollama run llama3.1 |
| Llama 3.1 | 405B | 231GB | ollama run llama3.1:405b |
| Phi 4 | 14B | 9.1GB | ollama run phi4 |
| Phi 3 Mini | 3.8B | 2.3GB | ollama run phi3 |
| Gemma 2 | 2B | 1.6GB | ollama run gemma2:2b |
| Gemma 2 | 9B | 5.5GB | ollama run gemma2 |
| Gemma 2 | 27B | 16GB | ollama run gemma2:27b |
| Mistral | 7B | 4.1GB | ollama run mistral |
| Moondream 2 | 1.4B | 829MB | ollama run moondream |
| Neural Chat | 7B | 4.1GB | ollama run neural-chat |
| Starling | 7B | 4.1GB | ollama run starling-lm |
| Code Llama | 7B | 3.8GB | ollama run codellama |
| Llama 2 Uncensored | 7B | 3.8GB | ollama run llama2-uncensored |
| LLaVA | 7B | 4.5GB | ollama run llava |
| Solar | 10.7B | 6.1GB | ollama run solar |
2. Задача
Ollama поддерживает разнообразные задачи NLP. Каждая задача соответствует различным сценариям применения модели, включая, помимо прочего, следующие:
- Генерация диалога: Генерирует естественные разговорные ответы при взаимодействии с пользователями.
- Генерация текста: Генерирует текст на естественном языке на основе заданного промпта, например для написания статей или генерации историй.
- Анализ тональности: Анализирует тональность заданного текста (например, положительная, отрицательная, нейтральная).
- Суммаризация текста: Сжимает длинный текст в краткое резюме.
- Перевод: Переводит текст с одного языка на другой.
С помощью инструмента командной строки пользователи могут указывать различные задачи и загружать разные модели для выполнения конкретных задач.
3. Инференс
Инференс — это процесс обработки входных данных на обученной модели и генерации выходных данных.
Ollama предоставляет простой в использовании инструмент командной строки или API, позволяющий пользователям быстро подавать входные данные в модель и получать результаты.
Инференс — одна из основных функций Ollama и основа взаимодействия с моделями.
Процесс инференса:
- Вход: Пользователь передаёт модели текстовый ввод, который может быть вопросом, подсказкой или содержимым диалога.
- Обработка моделью: Модель использует свою встроенную нейронную сеть для генерации соответствующего вывода на основе входных данных.
- Вывод: Модель возвращает сгенерированное текстовое содержимое, которое может быть ответом, сгенерированной статьёй, переведённым текстом и т. д.
Ollama взаимодействует с локальными моделями через API или CLI, позволяя пользователям легко выполнять задачи инференса.
4. Тонкая настройка
Тонкая настройка — это дальнейшее обучение предварительно обученной модели на данных конкретной предметной области, чтобы модель лучше работала на конкретных задачах или в конкретных областях.
Ollama поддерживает тонкую настройку. Пользователи могут использовать собственные наборы данных для тонкой настройки предварительно обученных моделей, чтобы настроить вывод модели.
Процесс тонкой настройки:
- Подготовка набора данных: пользователь готовит набор данных для конкретной предметной области. Формат данных обычно — текстовый файл или формат JSON.
- Загрузка предварительно обученной модели: выберите предварительно обученную модель, подходящую для тонкой настройки, например Llama2 или модели GPT.
- Обучение: обучите модель на конкретном наборе данных пользователя, чтобы она лучше адаптировалась к целевой задаче.
- Сохранение и развёртывание: после завершения обучения тонко настроенную модель можно сохранить и развернуть для дальнейшего использования.
Тонкая настройка помогает модели стать точнее и эффективнее при решении задач конкретной предметной области.
Другие расширения