Преобразование данных в R
Объединение датафреймов
Язык R объединяет датафреймы с помощью функцииmerge().
Формат синтаксиса функции merge() следующий:
# S3 方法
merge(x, y, …)

# data.frame 的 S3 方法
merge(x, y, by = intersect(names(x), names(y)),
      by.x = by, by.y = by, all = FALSE, all.x = all, all.y = all,
      sort = TRUE, suffixes = c(".x",".y"), no.dups = TRUE,
      incomparables = NULL, …)
Описание общих параметров:
- x, y: фреймы данных.
- by, by.x, by.y: указывают имена совпадающих столбцов в двух фреймах данных. По умолчанию используются одинаковые имена столбцов в двух фреймах данных.
- all: логическое значение; all = L — это сокращение для all.x = L и all.y = L, где L может быть TRUE или FALSE.
- all.x: логическое значение, по умолчанию FALSE. Если TRUE, отображать совпадающие строки в x, даже если в y нет соответствующих совпадающих строк; строки в y без совпадений представляются как NA.
- all.y: логическое значение, по умолчанию FALSE. Если TRUE, отображать совпадающие строки в y, даже если в x нет соответствующих совпадающих строк; строки в x без совпадений представляются как NA.
- sort: логическое значение, сортировать ли столбцы.
Функция merge() очень похожа на функциональность JOIN в SQL:
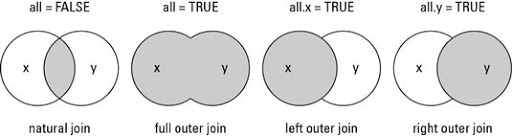
- Естественное соединение или INNER JOIN: если в таблицах есть хотя бы одно совпадение, возвращает строки
- Левое внешнее соединение или LEFT JOIN: возвращает все строки из левой таблицы, даже если в правой таблице нет совпадений.
- Правое внешнее соединение или RIGHT JOIN: возвращает все строки из правой таблицы, даже если в левой таблице нет совпадений.
- Полное внешнее соединение или FULL JOIN: возвращает строки, если есть совпадение в одной из таблиц.
Пример
df1 = data.frame(SiteId = c(1:6), Site = c("Google","Example","Taobao","Facebook","Zhihu","Weibo"))
# датафрейм 2
df2 = data.frame(SiteId = c(2, 4, 6, 7, 8), Country = c("CN","USA","CN","USA","IN"))
# INNER JOIN
df1 = merge(x=df1,y=df2,by="SiteId")
print("----- INNER JOIN -----")
print(df1)
# FULL JOIN
df2 = merge(x=df1,y=df2,by="SiteId",all=TRUE)
print("----- FULL JOIN -----")
print(df2)
# LEFT JOIN
df3 = merge(x=df1,y=df2,by="SiteId",all.x=TRUE)
print("----- LEFT JOIN -----")
print(df3)
# RIGHT JOIN
df4 = merge(x=df1,y=df2,by="SiteId",all.y=TRUE)
print("----- RIGHT JOIN -----")
print(df4)
Выполнение приведённого выше кода выводит следующий результат:
[1] "----- INNER JOIN -----"
  SiteId     Site Country
1      2   Example      CN
2      4 Facebook     USA
3      6    Weibo      CN
[1] "----- FULL JOIN -----"
  SiteId     Site Country.x Country.y
1      2   Example        CN        CN
2      4 Facebook       USA       USA
3      6    Weibo        CN        CN
4      7     <NA>      <NA>       USA
5      8     <NA>      <NA>        IN
[1] "----- LEFT JOIN -----"
  SiteId   Site.x Country   Site.y Country.x Country.y
1      2   Example      CN   Example        CN        CN
2      4 Facebook     USA Facebook       USA       USA
3      6    Weibo      CN    Weibo        CN        CN
[1] "----- RIGHT JOIN -----"
  SiteId   Site.x Country   Site.y Country.x Country.y
1      2   Example      CN   Example        CN        CN
2      4 Facebook     USA Facebook       USA       USA
3      6    Weibo      CN    Weibo        CN        CN
4      7     <NA>    <NA>     <NA>      <NA>       USA
5      8     <NA>    <NA>     <NA>      <NA>        IN
Агрегация и разделение данных
Язык R использует функцииmelt()иcast()для агрегирования и разделения данных.
- melt(): преобразует данные в широком формате в данные в длинном формате.
- cast(): преобразует данные в длинном формате в данные в широком формате.
Следующая диаграмма наглядно показывает работу функций melt() и cast() (следующие примеры подробно объяснят):

melt() собирает каждый столбец набора данных в один столбец. Формат синтаксиса функции:
melt(data, ..., na.rm = FALSE, value.name = "value")
Описание параметра:
- data: набор данных.
- ...: дополнительные аргументы, передаваемые в другие методы или из них.
- na.rm: удалять ли значения NA из набора данных.
- value.name: имя переменной, используемое для хранения значений.
Перед выполнением следующих операций мы сначала устанавливаем пакеты зависимостей:
# 安装库,MASS 包含很多统计相关的函数,工具和数据集
install.packages("MASS", repos = "https://mirrors.ustc.edu.cn/CRAN/")

#  melt() 和 cast() 函数需要对库
install.packages("reshape2", repos = "https://mirrors.ustc.edu.cn/CRAN/")
install.packages("reshape", repos = "https://mirrors.ustc.edu.cn/CRAN/")
Пример теста:
Пример
library(MASS)
library(reshape2)
library(reshape)
# Создать датафрейм
id<- c(1, 1, 2, 2)
time <- c(1, 2, 1, 2)
x1 <- c(5, 3, 6, 2)
x2 <- c(6, 5, 1, 4)
mydata <- data.frame(id, time, x1, x2)
# Исходный датафрейм
cat("Исходный датафрейм:\n")
print(mydata)
# Агрегировать
md <- melt(mydata, id = c("id","time"))
cat("\nПосле агрегации:\n")
print(md)
Выполнение приведённого выше кода выводит следующий результат:
原始数据框:
id time x1 x2
1  1    1  5  6
2  1    2  3  5
3  2    1  6  1
4  2    2  2  4

整合后:
id time variable value
1  1    1       x1     5
2  1    2       x1     3
3  2    1       x1     6
4  2    2       x1     2
5  1    1       x2     6
6  1    2       x2     5
7  2    1       x2     1
8  2    2       x2     4
Функция cast используется для восстановления объединённого датафрейма; dcast() возвращает датафрейм, а acast() возвращает вектор/матрицу/массив.
Синтаксис функции cast() имеет следующий вид:
dcast(
  data,
  formula,
  fun.aggregate = NULL,
  ...,
  margins = NULL,
  subset = NULL,
  fill = NULL,
  drop = TRUE,
  value.var = guess_value(data)
)
acast(
  data,
  formula,
  fun.aggregate = NULL,
  ...,
  margins = NULL,
  subset = NULL,
  fill = NULL,
  drop = TRUE,
  value.var = guess_value(data)
)
Описание параметра:
- data: объединённый датафрейм.
- formula: формат переформированных данных, аналогичный формату x ~ y, где x — метка строки, а y — метка столбца.
- fun.aggregate: агрегирующая функция, используемая для обработки значений value.
- margins: вектор имён переменных (может включать "grand_col" и "grand_row"), используемый для вычисления маргиналов; установите TRUE, чтобы вычислить все маргиналы.
- subset: отфильтровать результат по условиям, формат аналогиченsubset = .(variable=="length")。
- drop: следует ли сохранять значение по умолчанию.
- value.var: далее указывается поле, которое нужно обработать.
Пример
library(MASS)
library(reshape2)
library(reshape)
# Создать датафрейм
id<- c(1, 1, 2, 2)
time <- c(1, 2, 1, 2)
x1 <- c(5, 3, 6, 2)
x2 <- c(6, 5, 1, 4)
mydata <- data.frame(id, time, x1, x2)
# Агрегировать
md <- melt(mydata, id = c("id","time"))
# Вывести переформированный набор данных с помощью функции cast()
cast.data <- cast(md, id~variable, mean)
print(cast.data)
cat("\n")
time.cast <- cast(md, time~variable, mean)
print(time.cast)
cat("\n")
id.time <- cast(md, id~time, mean)
print(id.time)
cat("\n")
id.time.cast <- cast(md, id+time~variable)
print(id.time.cast)
cat("\n")
id.variable.time <- cast(md, id+variable~time)
print(id.variable.time)
cat("\n")
id.variable.time2 <- cast(md, id~variable+time)
print(id.variable.time2)
Выполнение приведённого выше кода выводит следующий результат:
id x1  x2
1  1  4 5.5
2  2  4 2.5

  time  x1  x2
1    1 5.5 3.5
2    2 2.5 4.5

  id   1 2
1  1 5.5 4
2  2 3.5 3

  id time x1 x2
1  1    1  5  6
2  1    2  3  5
3  2    1  6  1
4  2    2  2  4

  id variable 1 2
1  1       x1 5 3
2  1       x2 6 5
3  2       x1 6 2
4  2       x2 1 4

  id x1_1 x1_2 x2_1 x2_2
1  1    5    3    6    5
2  2    6    2    1    4
Другие расширения