Restructuration des données R
Fusionner les data frames
Le langage R fusionne les data frames en utilisant la fonctionmerge().
Le format de syntaxe de la fonction merge() est le suivant :
# S3 方法
merge(x, y, …)

# data.frame 的 S3 方法
merge(x, y, by = intersect(names(x), names(y)),
      by.x = by, by.y = by, all = FALSE, all.x = all, all.y = all,
      sort = TRUE, suffixes = c(".x",".y"), no.dups = TRUE,
      incomparables = NULL, …)
Description des paramètres courants :
- x, y : tableaux de données.
- by, by.x, by.y : permettent de spécifier les noms des colonnes de correspondance dans les deux tableaux de données. Par défaut, les mêmes noms de colonnes dans les deux tableaux de données sont utilisés.
- all : valeur logique ; all = L est un raccourci pour all.x = L et all.y = L, où L peut être TRUE ou FALSE.
- all.x : valeur logique, la valeur par défaut est FALSE. Si TRUE, affiche les lignes correspondantes dans x, même s'il n'y a pas de lignes correspondantes dans y ; les lignes de y sans correspondance sont représentées par NA.
- all.y : valeur logique, la valeur par défaut est FALSE. Si TRUE, affiche les lignes correspondantes dans y, même s'il n'y a pas de lignes correspondantes dans x ; les lignes de x sans correspondance sont représentées par NA.
- sort : valeur logique, indique si les colonnes doivent être triées.
La fonction merge() est très similaire à la fonctionnalité JOIN de SQL :
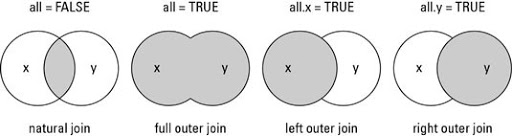
- Jointure naturelle ou INNER JOIN: s'il y a au moins une correspondance dans les tables, renvoie les lignes
- Jointure externe gauche ou LEFT JOIN: renvoie toutes les lignes de la table de gauche même s'il n'y a pas de correspondances dans la table de droite.
- Jointure externe droite ou RIGHT JOIN: renvoie toutes les lignes de la table de droite même s'il n'y a pas de correspondances dans la table de gauche.
- Jointure externe complète ou FULL JOIN: renvoie les lignes tant qu'il y a une correspondance dans l'une des tables.
Exemple
df1 = data.frame(SiteId = c(1:6), Site = c("Google","Example","Taobao","Facebook","Zhihu","Weibo"))
# tableau de données 2
df2 = data.frame(SiteId = c(2, 4, 6, 7, 8), Country = c("CN","USA","CN","USA","IN"))
# INNER JOIN
df1 = merge(x=df1,y=df2,by="SiteId")
print("----- INNER JOIN -----")
print(df1)
# FULL JOIN
df2 = merge(x=df1,y=df2,by="SiteId",all=TRUE)
print("----- FULL JOIN -----")
print(df2)
# LEFT JOIN
df3 = merge(x=df1,y=df2,by="SiteId",all.x=TRUE)
print("----- LEFT JOIN -----")
print(df3)
# RIGHT JOIN
df4 = merge(x=df1,y=df2,by="SiteId",all.y=TRUE)
print("----- RIGHT JOIN -----")
print(df4)
L'exécution du code ci-dessus produit le résultat suivant :
[1] "----- INNER JOIN -----"
  SiteId     Site Country
1      2   Example      CN
2      4 Facebook     USA
3      6    Weibo      CN
[1] "----- FULL JOIN -----"
  SiteId     Site Country.x Country.y
1      2   Example        CN        CN
2      4 Facebook       USA       USA
3      6    Weibo        CN        CN
4      7     <NA>      <NA>       USA
5      8     <NA>      <NA>        IN
[1] "----- LEFT JOIN -----"
  SiteId   Site.x Country   Site.y Country.x Country.y
1      2   Example      CN   Example        CN        CN
2      4 Facebook     USA Facebook       USA       USA
3      6    Weibo      CN    Weibo        CN        CN
[1] "----- RIGHT JOIN -----"
  SiteId   Site.x Country   Site.y Country.x Country.y
1      2   Example      CN   Example        CN        CN
2      4 Facebook     USA Facebook       USA       USA
3      6    Weibo      CN    Weibo        CN        CN
4      7     <NA>    <NA>     <NA>      <NA>       USA
5      8     <NA>    <NA>     <NA>      <NA>        IN
Agrégation et fractionnement des données
Le langage R utilise les fonctionsmelt()etcast()pour agréger et fractionner les données.
- melt() : convertit les données au format large en données au format long.
- cast() : convertit les données au format long en données au format large.
Le diagramme suivant montre clairement le fonctionnement des fonctions melt() et cast() (les exemples suivants expliqueront en détail) :
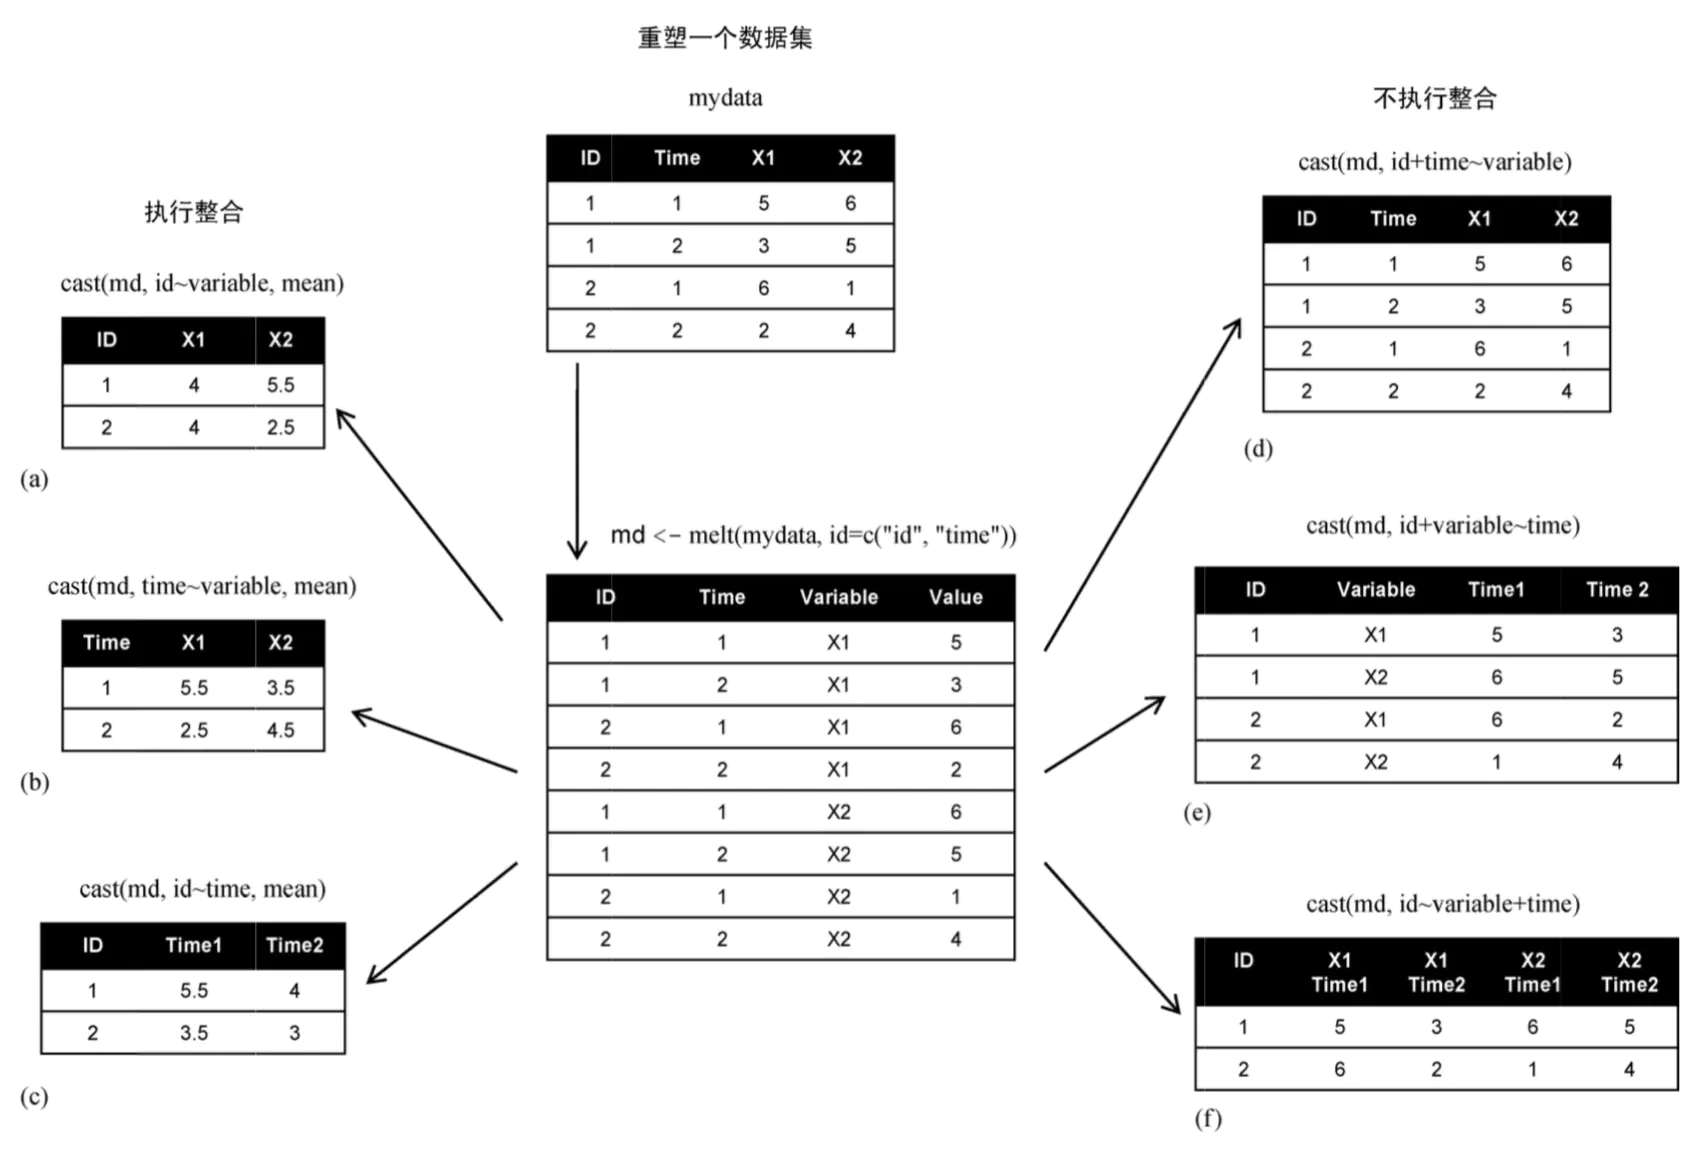
melt() empile chaque colonne du jeu de données dans une seule colonne. Le format de syntaxe de la fonction est :
melt(data, ..., na.rm = FALSE, value.name = "value")
Description du paramètre :
- data : jeu de données.
- ... : arguments supplémentaires transmis à ou depuis d'autres méthodes.
- na.rm : indique s'il faut supprimer les valeurs NA du jeu de données.
- value.name : nom de variable utilisé pour stocker les valeurs.
Avant d'effectuer les opérations suivantes, nous installons d'abord les paquets de dépendances :
# 安装库,MASS 包含很多统计相关的函数,工具和数据集
install.packages("MASS", repos = "https://mirrors.ustc.edu.cn/CRAN/")

#  melt() 和 cast() 函数需要对库
install.packages("reshape2", repos = "https://mirrors.ustc.edu.cn/CRAN/")
install.packages("reshape", repos = "https://mirrors.ustc.edu.cn/CRAN/")
Exemple de test :
Exemple
library(MASS)
library(reshape2)
library(reshape)
# Créer un tableau de données
id<- c(1, 1, 2, 2)
time <- c(1, 2, 1, 2)
x1 <- c(5, 3, 6, 2)
x2 <- c(6, 5, 1, 4)
mydata <- data.frame(id, time, x1, x2)
# Tableau de données d'origine
cat("Tableau de données d'origine :\n")
print(mydata)
# Agréger
md <- melt(mydata, id = c("id","time"))
cat("\nAprès agrégation :\n")
print(md)
L'exécution du code ci-dessus produit le résultat suivant :
原始数据框:
id time x1 x2
1  1    1  5  6
2  1    2  3  5
3  2    1  6  1
4  2    2  2  4

整合后:
id time variable value
1  1    1       x1     5
2  1    2       x1     3
3  2    1       x1     6
4  2    2       x1     2
5  1    1       x2     6
6  1    2       x2     5
7  2    1       x2     1
8  2    2       x2     4
La fonction cast est utilisée pour restaurer le tableau de données fusionné ; dcast() renvoie un tableau de données, et acast() renvoie un vecteur/matrice/tableau.
Le format syntaxique de la fonction cast() est :
dcast(
  data,
  formula,
  fun.aggregate = NULL,
  ...,
  margins = NULL,
  subset = NULL,
  fill = NULL,
  drop = TRUE,
  value.var = guess_value(data)
)
acast(
  data,
  formula,
  fun.aggregate = NULL,
  ...,
  margins = NULL,
  subset = NULL,
  fill = NULL,
  drop = TRUE,
  value.var = guess_value(data)
)
Description du paramètre :
- data : le data frame fusionné.
- formula : le format des données remodelées, similaire au format x ~ y, où x est l'étiquette de ligne et y est l'étiquette de colonne.
- fun.aggregate : fonction d'agrégation, utilisée pour traiter les valeurs de value.
- margins : un vecteur de noms de variables (peut inclure \"grand_col\" et \"grand_row\"), utilisé pour calculer les marges ; définir à TRUE pour calculer toutes les marges.
- subset : filtrer le résultat selon des conditions, avec un format similaire àsubset = .(variable=="length")。
- drop : indique s'il faut conserver la valeur par défaut.
- value.var : suivi du champ à traiter.
Exemple
library(MASS)
library(reshape2)
library(reshape)
# Créer un tableau de données
id<- c(1, 1, 2, 2)
time <- c(1, 2, 1, 2)
x1 <- c(5, 3, 6, 2)
x2 <- c(6, 5, 1, 4)
mydata <- data.frame(id, time, x1, x2)
# Agréger
md <- melt(mydata, id = c("id","time"))
# Afficher le jeu de données recasté à l'aide de la fonction cast()
cast.data <- cast(md, id~variable, mean)
print(cast.data)
cat("\n")
time.cast <- cast(md, time~variable, mean)
print(time.cast)
cat("\n")
id.time <- cast(md, id~time, mean)
print(id.time)
cat("\n")
id.time.cast <- cast(md, id+time~variable)
print(id.time.cast)
cat("\n")
id.variable.time <- cast(md, id+variable~time)
print(id.variable.time)
cat("\n")
id.variable.time2 <- cast(md, id~variable+time)
print(id.variable.time2)
L'exécution du code ci-dessus produit le résultat suivant :
id x1  x2
1  1  4 5.5
2  2  4 2.5

  time  x1  x2
1    1 5.5 3.5
2    2 2.5 4.5

  id   1 2
1  1 5.5 4
2  2 3.5 3

  id time x1 x2
1  1    1  5  6
2  1    2  3  5
3  2    1  6  1
4  2    2  2  4

  id variable 1 2
1  1       x1 5 3
2  1       x2 6 5
3  2       x1 6 2
4  2       x2 1 4

  id x1_1 x1_2 x2_1 x2_2
1  1    5    3    6    5
2  2    6    2    1    4
Autres extensions