Remodelación de datos en R
Combinar marcos de datos
El lenguaje R, para combinar marcos de datos, utilizamerge()funciones.
La sintaxis de la función merge() es la siguiente:
# S3 方法
merge(x, y, …)

# data.frame 的 S3 方法
merge(x, y, by = intersect(names(x), names(y)),
      by.x = by, by.y = by, all = FALSE, all.x = all, all.y = all,
      sort = TRUE, suffixes = c(".x",".y"), no.dups = TRUE,
      incomparables = NULL, …)
Descripción de los parámetros comunes:
- x, y: marcos de datos
- by, by.x, by.y: especifican los nombres de las columnas que coinciden en los dos marcos de datos; de forma predeterminada, se usan los nombres de columna idénticos en ambos marcos de datos.
- all: valor lógico; all = L es una abreviatura de all.x = L y all.y = L, donde L puede ser TRUE o FALSE.
- all.x: valor lógico, por defecto FALSE. Si es TRUE, muestra las filas coincidentes de x, incluso si no hay coincidencias correspondientes en y; las filas sin coincidencia en y se representan con NA.
- all.y: valor lógico, por defecto FALSE. Si es TRUE, muestra las filas coincidentes de y, incluso si no hay coincidencias correspondientes en x; las filas sin coincidencia en x se representan con NA.
- sort: valor lógico, indica si se ordenan las columnas.
La función merge() es muy similar a la funcionalidad JOIN de SQL:
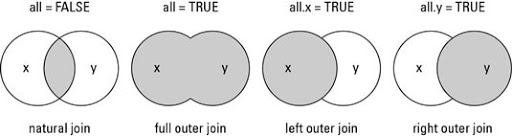
- Natural join o INNER JOIN: si hay al menos una coincidencia en las tablas, devuelve las filas
- Left outer join o LEFT JOIN: devuelve todas las filas de la tabla izquierda incluso si no hay coincidencias en la tabla derecha
- Right outer join o RIGHT JOIN: devuelve todas las filas de la tabla derecha incluso si no hay coincidencias en la tabla izquierda
- Full outer join o FULL JOIN: devuelve filas siempre que haya una coincidencia en una de las tablas
Ejemplo
df1 = data.frame(SiteId = c(1:6), Site = c("Google","Ejemplo","Taobao","Facebook","Zhihu","Weibo"))
# data frame 2
df2 = data.frame(SiteId = c(2, 4, 6, 7, 8), Country = c("CN","USA","CN","USA","IN"))
# INNER JOIN
df1 = merge(x=df1,y=df2,by="SiteId")
print("----- INNER JOIN -----")
print(df1)
# FULL JOIN
df2 = merge(x=df1,y=df2,by="SiteId",all=TRUE)
print("----- FULL JOIN -----")
print(df2)
# LEFT JOIN
df3 = merge(x=df1,y=df2,by="SiteId",all.x=TRUE)
print("----- LEFT JOIN -----")
print(df3)
# RIGHT JOIN
df4 = merge(x=df1,y=df2,by="SiteId",all.y=TRUE)
print("----- RIGHT JOIN -----")
print(df4)
El resultado de ejecutar el código anterior es:
[1] "----- INNER JOIN -----"
  SiteId     Site Country
1      2   Ejemplo      CN
2      4 Facebook     USA
3      6    Weibo      CN
[1] "----- FULL JOIN -----"
  SiteId     Site Country.x Country.y
1      2   Ejemplo        CN        CN
2      4 Facebook       USA       USA
3      6    Weibo        CN        CN
4      7     <NA>      <NA>       USA
5      8     <NA>      <NA>        IN
[1] "----- LEFT JOIN -----"
  SiteId   Site.x Country   Site.y Country.x Country.y
1      2   Ejemplo      CN   Ejemplo        CN        CN
2      4 Facebook     USA Facebook       USA       USA
3      6    Weibo      CN    Weibo        CN        CN
[1] "----- RIGHT JOIN -----"
  SiteId   Site.x Country   Site.y Country.x Country.y
1      2   Ejemplo      CN   Ejemplo        CN        CN
2      4 Facebook     USA Facebook       USA       USA
3      6    Weibo      CN    Weibo        CN        CN
4      7     <NA>    <NA>     <NA>      <NA>       USA
5      8     <NA>    <NA>     <NA>      <NA>        IN
Integración y división de datos
El lenguaje R utilizamelt()ycast()funciones para integrar y dividir los datos.
- melt(): convierte datos en formato ancho a formato largo.
- cast(): convierte datos en formato largo a formato ancho.
La siguiente figura muestra claramente la funcionalidad de melt() y cast() (se detallará en ejemplos posteriores):

La función melt() apila cada columna del conjunto de datos en una sola columna; el formato de la sintaxis de la función es:
melt(data, ..., na.rm = FALSE, value.name = "value")
Descripción de parámetros:
- data: conjunto de datos.
- ...: otros argumentos pasados a otros métodos o provenientes de otros métodos.
- na.rm: indica si se eliminan los valores NA del conjunto de datos.
- value.name: nombre de la variable, utilizado para almacenar los valores.
Antes de realizar las siguientes operaciones, primero instalamos los paquetes de dependencia:
# 安装库,MASS 包含很多统计相关的函数,工具和数据集
install.packages("MASS", repos = "https://mirrors.ustc.edu.cn/CRAN/")

#  melt() 和 cast() 函数需要对库
install.packages("reshape2", repos = "https://mirrors.ustc.edu.cn/CRAN/")
install.packages("reshape", repos = "https://mirrors.ustc.edu.cn/CRAN/")
Ejemplo de prueba:
Ejemplo
library(MASS)
library(reshape2)
library(reshape)
# Crear el marco de datos
id<- c(1, 1, 2, 2)
time <- c(1, 2, 1, 2)
x1 <- c(5, 3, 6, 2)
x2 <- c(6, 5, 1, 4)
mydata <- data.frame(id, time, x1, x2)
# Marco de datos original
cat(Marco de datos original:\n")
print(mydata)
# Integrar
md <- melt(mydata, id = c("id","time"))
cat("\nDespués de integrar:\n")
print(md)
El resultado de ejecutar el código anterior es:
原始数据框:
id time x1 x2
1  1    1  5  6
2  1    2  3  5
3  2    1  6  1
4  2    2  2  4

整合后:
id time variable value
1  1    1       x1     5
2  1    2       x1     3
3  2    1       x1     6
4  2    2       x1     2
5  1    1       x2     6
6  1    2       x2     5
7  2    1       x2     1
8  2    2       x2     4
La función cast se utiliza para restaurar el marco de datos combinado; dcast() devuelve un marco de datos, y acast() devuelve un vector/matriz/array.
El formato de la sintaxis de la función cast() es:
dcast(
  data,
  formula,
  fun.aggregate = NULL,
  ...,
  margins = NULL,
  subset = NULL,
  fill = NULL,
  drop = TRUE,
  value.var = guess_value(data)
)
acast(
  data,
  formula,
  fun.aggregate = NULL,
  ...,
  margins = NULL,
  subset = NULL,
  fill = NULL,
  drop = TRUE,
  value.var = guess_value(data)
)
Descripción de parámetros:
- data: el marco de datos combinado.
- formula: el formato de los datos remodelados, similar al formato x ~ y, donde x es la etiqueta de fila e y es la etiqueta de columna.
- fun.aggregate: función de agregación, utilizada para procesar los valores.
- margins: vector de nombres de variables (puede incluir "grand\_col" y "grand\_row"), utilizado para calcular márgenes; si se establece como TRUE, calcula todos los márgenes.
- subset: filtra condicionalmente los resultados, con un formato similar asubset = .(variable=="length")。
- drop: indica si se conservan los valores predeterminados.
- value.var: seguido del campo que se va a procesar.
Ejemplo
library(MASS)
library(reshape2)
library(reshape)
# Crear el marco de datos
id<- c(1, 1, 2, 2)
time <- c(1, 2, 1, 2)
x1 <- c(5, 3, 6, 2)
x2 <- c(6, 5, 1, 4)
mydata <- data.frame(id, time, x1, x2)
# Integrar
md <- melt(mydata, id = c("id","time"))
# Print recasted dataset using cast() function
cast.data <- cast(md, id~variable, mean)
print(cast.data)
cat("\n")
time.cast <- cast(md, time~variable, mean)
print(time.cast)
cat("\n")
id.time <- cast(md, id~time, mean)
print(id.time)
cat("\n")
id.time.cast <- cast(md, id+time~variable)
print(id.time.cast)
cat("\n")
id.variable.time <- cast(md, id+variable~time)
print(id.variable.time)
cat("\n")
id.variable.time2 <- cast(md, id~variable+time)
print(id.variable.time2)
El resultado de ejecutar el código anterior es:
id x1  x2
1  1  4 5.5
2  2  4 2.5

  time  x1  x2
1    1 5.5 3.5
2    2 2.5 4.5

  id   1 2
1  1 5.5 4
2  2 3.5 3

  id time x1 x2
1  1    1  5  6
2  1    2  3  5
3  2    1  6  1
4  2    2  2  4

  id variable 1 2
1  1       x1 5 3
2  1       x2 6 5
3  2       x1 6 2
4  2       x2 1 4

  id x1_1 x1_2 x2_1 x2_2
1  1    5    3    6    5
2  2    6    2    1    4
Otras extensiones