Algorithmes de graphes avancés
Dans le tutoriel de base précédent, nous avons déjà appris les concepts de base des graphes, les méthodes de représentation et les algorithmes de base tels que la recherche en largeur d'abord (BFS) et la recherche en profondeur d'abord (DFS). Ces algorithmes nous ont aidés à résoudre des problèmes tels que la connexité entre deux points et le parcours de graphe.
Cependant, de nombreux problèmes complexes du monde réel, tels que les recommandations d'amis dans les réseaux sociaux, la planification du plus court chemin dans la navigation cartographique, l'organisation optimale des itinéraires en logistique et distribution, et même le classement des pages web sur Internet, nécessitent tous des algorithmes plus puissants et plus efficaces. Ce sontAlgorithmes de graphes avancésLe défi à résoudre.
Algorithmes de graphes avancésC'est comme un outil professionnel conçu pour résoudre des problèmes complexes spécifiques :
- Flux réseau: résout des problèmes de distribution de flux, tels que le transport et la logistique
- Appariement de graphes bipartis: résout des problèmes d'appariement, tels que l'affectation de tâches et l'appariement matrimonial
- Composantes fortement connexes: analyse de la structure de connexité des graphes
- Tri topologique: résolution de problèmes de dépendances
Cas concret :
- Flux réseau: comme l'optimisation des flux de circulation dans les systèmes de transport urbains
- Appariement de graphes bipartis: comme les systèmes d'appariement matrimonial
- Composantes fortement connexes: comme l'analyse des cercles d'amis dans les réseaux sociaux
- Tri topologique: comme le tri des dépendances entre tâches
| Types de problèmes | Algorithmes généraux | Algorithmes de graphes avancés |
|---|---|---|
| Optimisation des flux | Difficiles à modéliser et à résoudre | Les algorithmes de flot réseau résolvent spécifiquement |
| Problème de couplage | La recherche par force brute est inefficace | Le couplage dans un graphe biparti résout efficacement |
| Analyse de connectivité | Le DFS/BFS de base fournit des informations limitées | Les composantes fortement connexes permettent une analyse approfondie |
| Tri des dépendances | Difficile de gérer des dépendances complexes | Le tri topologique résout parfaitement |
Problème du plus court chemin et algorithme de Dijkstra
Imaginez que vous utilisez une application de cartographie pour planifier un itinéraire de chez vous au bureau. Il existe d'innombrables chemins sur la carte, et chaque chemin a un temps de trajet différent (poids). Votre objectif est de trouverle temps de trajet total le plus courtpour ce chemin, ce qui est le classiqueproblème du plus court chemin à source unique。
Idée centrale de l'algorithme
Algorithme de Dijkstrarésoutles graphes pondérés à poids non négatifsUn algorithme glouton pour le problème du plus court chemin à source unique. Son idée centrale est comme un explorateur prudent :
- Il maintient un ensemble de nœuds avec des "distances les plus courtes connues".
- Chaque fois, choisissez-en un dans la "région inconnue"le nœud actuellement le plus proche du point de départ, puis confirmez sa plus courte distance.
- Utilisez ensuite ce nœud nouvellement confirmé pour mettre à jour la "distance la plus courte estimée" de tous ses voisins.
- Répétez ce processus jusqu'à ce que les distances les plus courtes de tous les nœuds soient confirmées.
Explication détaillée des étapes de l'algorithme
Utilisons un diagramme de flux pour comprendre intuitivement le processus d'exécution de l'algorithme de Dijkstra :
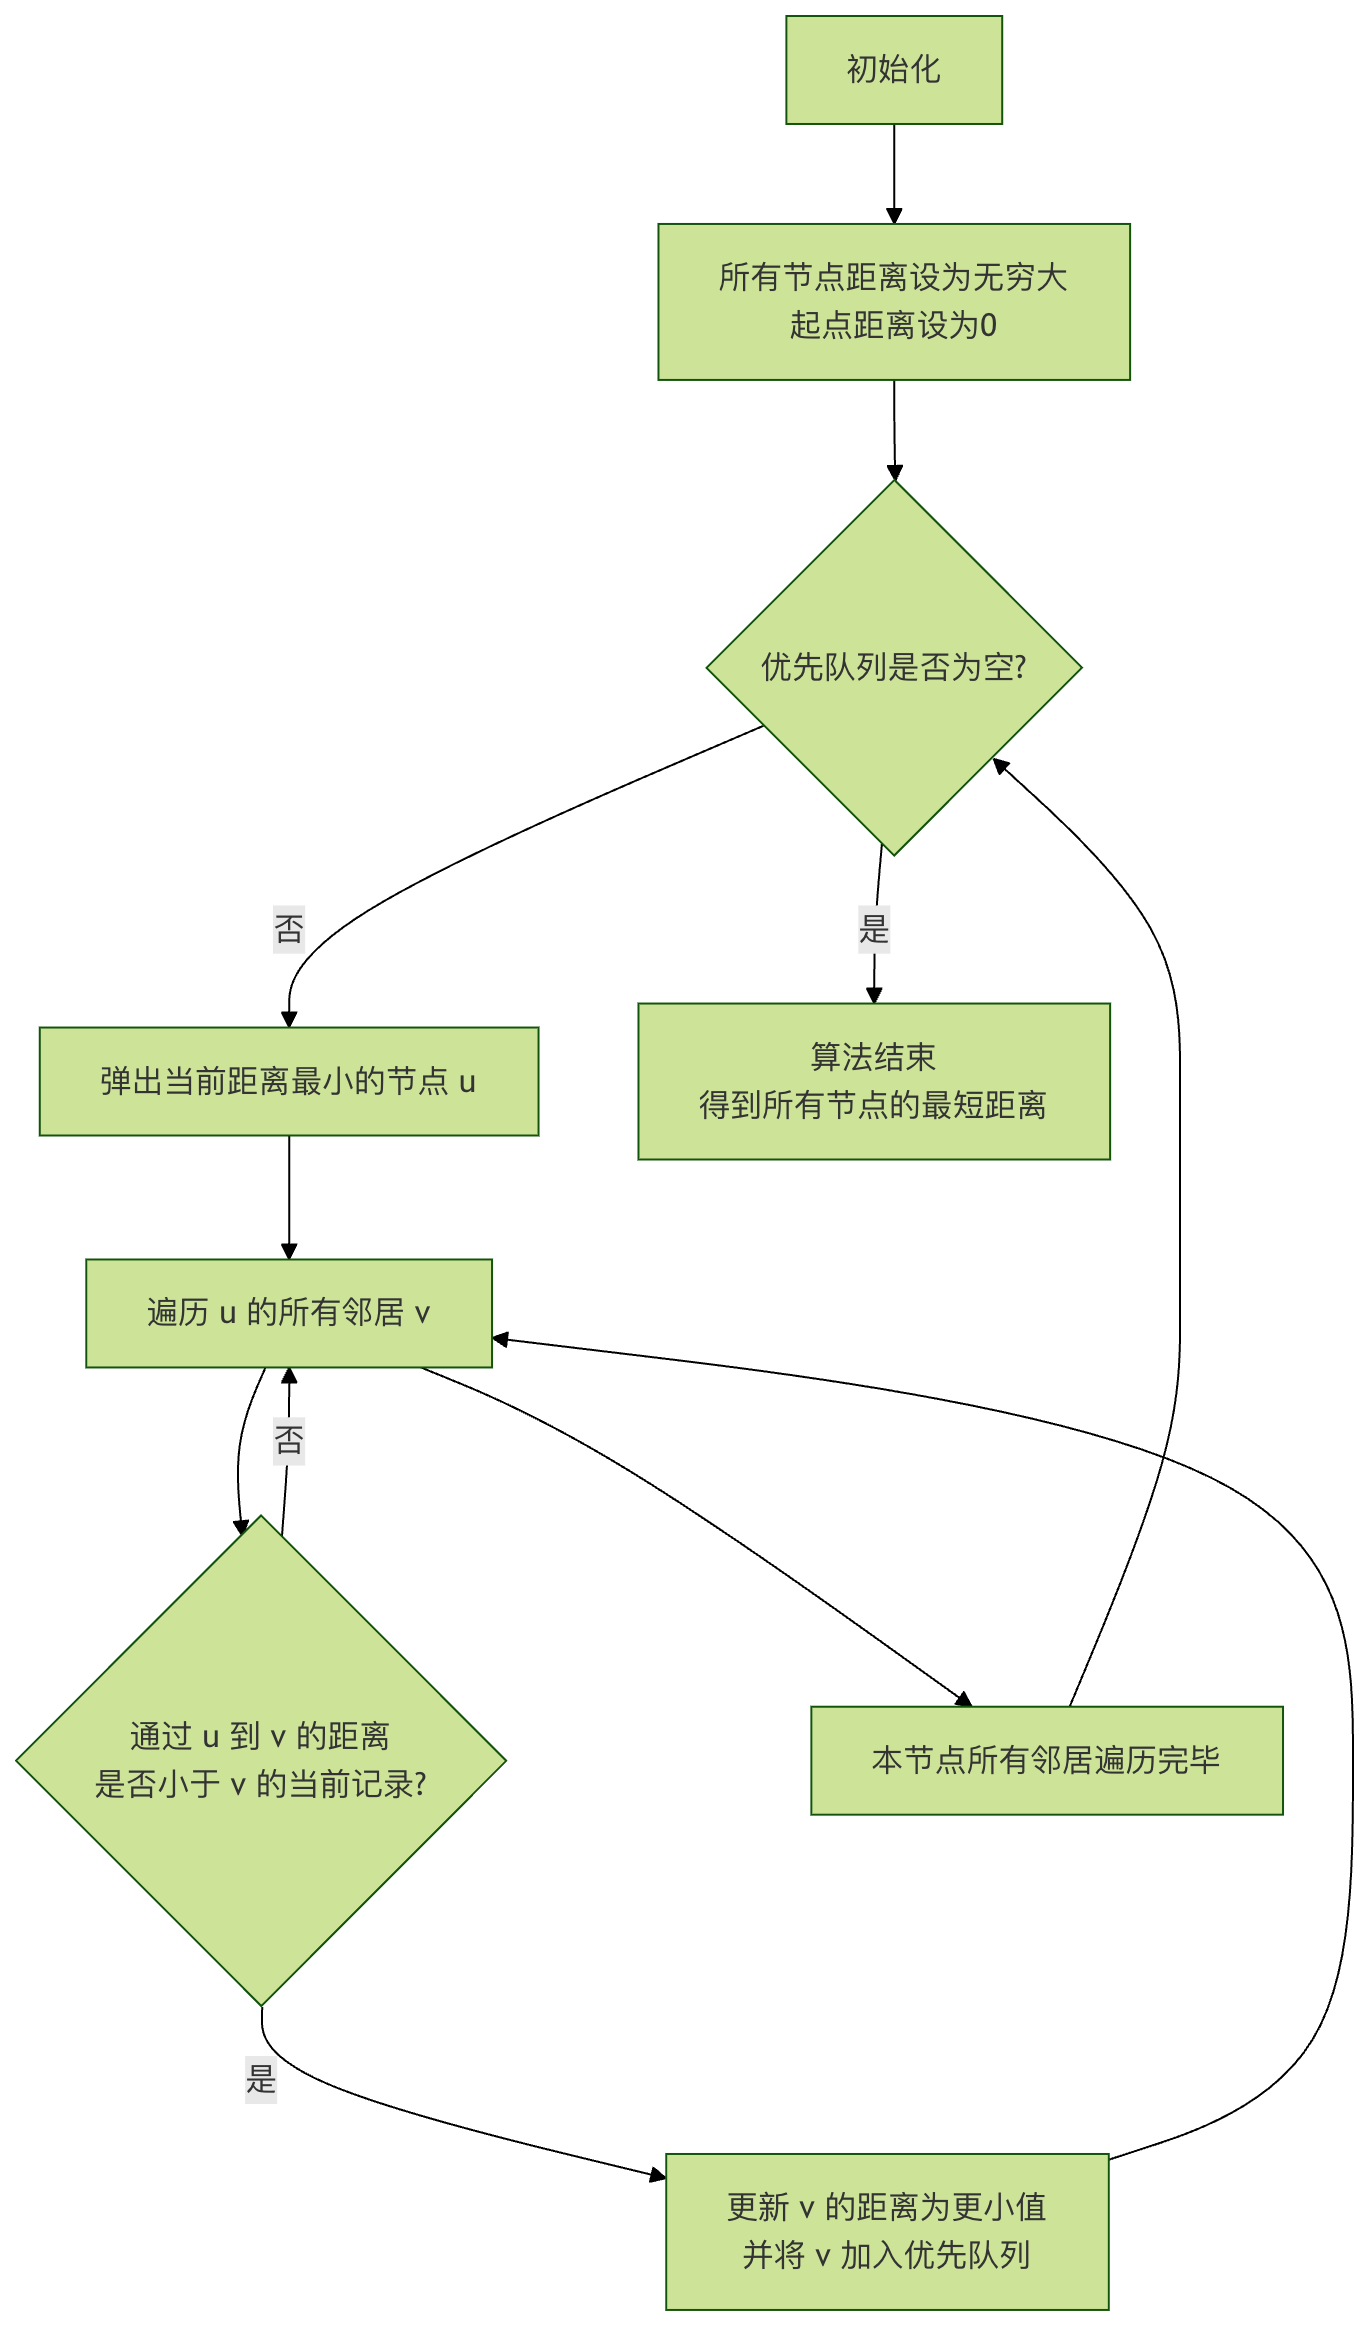
Explication du diagramme de flux: L'algorithme commence par l'initialisation, extrait continuellement de la file de priorité le nœud non traité le plus proche du point de départ, et l'utilise pour relâcher (mettre à jour) les estimations de distance de ses nœuds voisins, jusqu'à ce que la file soit vide, moment auquel tous les plus courts chemins sont déterminés.
Implémentation du code et exemples
Ensuite, nous utilisons Python pour implémenter l'algorithme de Dijkstra. Nous allons utiliserheapqce module de file de priorité (tas-min) pour obtenir efficacement le nœud ayant la distance minimale actuelle.
Exemple
def dijkstra(graph, start):
"""
Utilisez l'algorithme de Dijkstra pour calculer les distances les plus courtes du point de départ start à tous les autres nœuds du graphe.
Paramètres :
graph : Liste d'adjacence représentée sous forme de dictionnaire. Format : {node: [(neighbor1, weight1), (neighbor2, weight2), ...]}
start : Le nœud de départ.
Retourne :
Un dictionnaire contenant les distances les plus courtes de tous les nœuds au point de départ.
"""
# Initialisation : définir la distance la plus courte de tous les nœuds à l'infini
shortest_distances = {node: float('inf') for node in graph}
shortest_distances[start] = 0 # La distance du nœud de départ à lui-même est 0
# Utiliser une file de priorité (tas min), les éléments sont (distance actuelle, nœud)
priority_queue = [(0, start)]
while priority_queue:
current_distance, current_node = heapq.heappop(priority_queue)
# Si la distance extraite est supérieure à la distance enregistrée, il s'agit de données obsolètes ; ignorer
if current_distance > shortest_distances[current_node]:
continue
# Parcourir tous les voisins du nœud actuel
for neighbor, weight in graph[current_node]:
distance = current_distance + weight
# Si un chemin plus court est trouvé, mettre à jour
if distance < shortest_distances[neighbor]:
shortest_distances[neighbor] = distance
heapq.heappush(priority_queue, (distance, neighbor))
return shortest_distances
# --- Exemple de test ---
# Définir un graphe orienté pondéré (node: [(neighbor, weight), ...])
test_graph = {
'A': [('B', 4), ('C', 2)],
'B': [('C', 1), ('D', 5)],
'C': [('B', 1), ('D', 8), ('E', 10)],
'D': [('E', 2)],
'E': []
}
start_node = 'A'
distances = dijkstra(test_graph, start_node)
print(f"Distances les plus courtes du nœud {start_node} à chaque nœud :")
for node, dist in distances.items():
print(f" vers le nœud {node} : {dist}")
Explication du code:
shortest_distancesUn dictionnaire est utilisé pour enregistrer, du nœud de départ à chaque nœud,Confirmation finalela distance la plus courte, avec une valeur initiale de l'infini.priority_queueC'est un tas min (min-heap), qui nous permet toujours de sortir rapidement le nœud actuellement estimé comme le plus proche du nœud de départ.- Dans la boucle principale,
heapq.heappopRetirez le nœud au sommet du tas (le nœud actuellement le plus proche). if current_distance > ... : continueC'est une optimisation clé pour gérer l'existence possible de plusieurs versions obsolètes (valeurs de distance) du même nœud dans le tas.- Lors du parcours des voisins, calculez
distance = current_distance + weight, c'est la "nouvelle distance vers le voisin en passant par le nœud actuel." - Si la nouvelle distance est plus courte, mettez-la à jour
shortest_distancesetPoussez le voisin et sa nouvelle distance dans le taspour un traitement ultérieur.
En exécutant le code ci-dessus, vous obtiendrez la sortie suivante:
从节点 A 出发到各节点的最短距离:
  到节点 A: 0
  到节点 B: 3  # 路径: A -> C -> B
  到节点 C: 2  # 路径: A -> C
  到节点 D: 8  # 路径: A -> C -> B -> D
  到节点 E: 10 # 路径: A -> C -> B -> D -> E
Arbre couvrant minimal et algorithme de Prim
Considérons maintenant un autre problème : vous devez poser un réseau de fibre optique pour un nouveau quartier résidentiel, en reliant toutes les maisons, mais pour réduire les coûts, vous voulez que la longueur totale de fibre utilisée soit la plus courte possible. Étant donné le coût (poids) de la pose de fibre entre chaque paire de maisons, comment choisir les lignes à poser ?
Ce problème nous demande de trouver unsous-graphe reliant tous les nœuds, et ce sous-graphe est un arbre (sans cycle), et le poids total de toutes ses arêtes, c'est-à-dire la somme des poids, est minimisé. Cet arbre est appeléarbre couvrant minimal (MST)。
Idée de l'algorithme de Prim
L'algorithme de Primest un algorithme glouton pour trouver un arbre couvrant minimal (MST). Son fonctionnement ressemble beaucoup à « faire pousser un arbre » :
- Partez de n'importe quel nœud et initialisez l'arbre pour qu'il ne contienne que ce nœud.
- Parmi toutes lesarêtes reliant les nœuds internes et les nœuds externes de l'arbre, parmi les arêtes, choisissez l'arêtede poids minimal.
- Ajoutez cette arête et le nœud qu'elle relienœud externeAjoutez-le à l'arbre.
- Répétez les étapes 2 et 3 jusqu'à ce que tous les nœuds soient inclus dans l'arbre.
Implémentation du code et exemples
L'implémentation de l'algorithme de Prim est très similaire à celle de Dijkstra ; la différence réside dans la définition de la distance.
Dans l'algorithme de Prim, ce que nous maintenons est la distance de chaque nœud àl'arbre couvrant actuel, c'est-à-dire le coût de connexion minimal.
Exemple
def prim_mst(graph):
"""
Utilisez l'algorithme de Prim pour calculer le poids total de l'arbre couvrant minimal (MST) du graphe.
Paramètres :
graph : Liste d'adjacence représentée sous forme de dictionnaire. Format : {node: [(neighbor1, weight1), (neighbor2, weight2), ...]}
On suppose que le graphe est connexe.
Retourne :
Le poids total de l'arbre couvrant minimal.
"""
start_node = list(graph.keys())[0] # Partir de n'importe quel nœud ; ici, prendre le premier
visited = set([start_node]) # Ensemble des nœuds déjà ajoutés à l'arbre couvrant minimal
# File de priorité, stockant (poids de l'arête, nœud voisin)
# Initialisation : ajouter toutes les arêtes du nœud de départ à la file
edges = [(weight, start_node, neighbor) for neighbor, weight in graph[start_node]]
heapq.heapify(edges)
total_weight = 0
while edges:
weight, from_node, to_node = heapq.heappop(edges)
if to_node not in visited:
visited.add(to_node) # Ajouter le nouveau nœud à l'arbre couvrant minimal
total_weight += weight # Accumuler le poids total de l'arbre couvrant minimal
print(f"Ajouter une arête : {from_node} - {to_node}, poids : {weight}") # Afficher les arêtes sélectionnées
# Ajouter à la file toutes les arêtes reliant le nouveau nœud aux nœuds externes
for neighbor, w in graph[to_node]:
if neighbor not in visited:
heapq.heappush(edges, (w, to_node, neighbor))
return total_weight
# --- Exemple de test ---
# Définir un graphe pondéré non orienté (chaque arête apparaît deux fois dans la liste d'adjacence)
test_graph_undirected = {
'A': [('B', 4), ('C', 2)],
'B': [('A', 4), ('C', 1), ('D', 5)],
'C': [('A', 2), ('B', 1), ('D', 8), ('E', 10)],
'D': [('B', 5), ('C', 8), ('E', 2)],
'E': [('C', 10), ('D', 2)]
}
print("Le processus de construction de l'arbre couvrant minimal :")
mst_weight = prim_mst(test_graph_undirected)
print(f"\n"Le poids total de l'arbre couvrant minimal est : {mst_weight}")
Explication du code:
visitedL'ensemble enregistre les nœuds qui appartiennent déjà à l'arbre couvrant minimal.edgesest un tas-min, stockant toutes lesarêtes traversant l'intérieur et l'extérieur de l'arbre couvrant minimalarête (c.-à-d., une extrémité est dansvisited, l'autre extrémité n'y est pas).- Dans la boucle principale, prenez toujours l'arête ayant le plus petit poids dans le tas
(weight, from_node, to_node)。 - Si le nœud connecté par cette arête
to_noden'a pas été visité, alors c'est une arête valide de l'arbre couvrant minimal. Ajoutez-la au résultat, et mettez à jourvisitedettotal_weight。 - Ajoutez le nouveau nœud
to_nodetoutes ses arêtes menant à des nœuds externes sont ajoutées au tas pour le prochain tour de sélection.
Exécutez le code ci-dessus et vous verrez le processus de construction de l'arbre couvrant minimal:
构建最小生成树的过程:
添加边: A - C, 权重: 2
添加边: C - B, 权重: 1
添加边: A - B, 权重: 4  # 注意:这条边连接B和A,但B已在树中,所以会被下一行的if语句跳过,不会添加。
添加边: B - D, 权重: 5
添加边: D - E, 权重: 2

最小生成树的总权重为: 10
(Remarque : dans la sortie réelle, l'arête A - B, parce queto_nodeB est déjà présentvisited, donc elle ne sera pas exécutéeprintinstruction. Le commentaire ci-dessus est fourni à titre explicatif.)Les arêtes finales du MST sont A-C, C-B, B-D, D-E, et le poids total est 2+1+5+2=10.
Tri topologique : gestion des tâches avec dépendances
Lorsque vous devez planifier une série de tâches et que certaines tâches doivent commencer après que d'autres tâches sont terminées (par exemple, mettre des chaussettes doit venir avant de mettre des chaussures), comment déterminer un ordre d'exécution raisonnable ? Les dépendances entre les tâches peuvent être représentées parGraphe orienté acyclique (DAG)pour les représenter, et le processus de recherche d'un ordre d'exécution linéaire réalisable est letri topologique。
Algorithme de Kahn (basé sur le degré entrant)
Algorithme de KahnIl s'agit de l'un des algorithmes les plus intuitifs pour le tri topologique, basé sur le degré entrant (le nombre d'arêtes pointant vers le nœud).
- Trouvez tous les nœuds de degré entrant 0 ; ce sont des tâches qui peuvent être exécutées immédiatement (aucune dépendance préalable).
- Placez ces nœuds dans une file et "retirez"-les du graphe (sortez-les dans le résultat du tri).
- Après avoir "retiré" un nœud, mettez à jour le degré entrant de tous ses voisins (diminuez-le de 1). Si le degré entrant d'un voisin devient 0 par conséquent, ajoutez-le à la file.
- Répétez les étapes 2 et 3 jusqu'à ce que la file d'attente soit vide.
- Si le nombre de nœuds en sortie est égal au nombre total de nœuds du graphe, le tri réussit ; sinon, cela signifie que le graphe contient un cycle et ne peut pas être trié topologiquement.
Implémentation du code et exemples
Exemple
def topological_sort_kahn(graph):
"""
Utilisez l'algorithme de Kahn pour le tri topologique.
Paramètres :
graph: liste d'adjacence représentée sous forme de dictionnaire. Format : {node: [neighbor1, neighbor2, ...]}
Retourne :
Si un tri topologique existe, renvoyez une liste (l'ordre trié) ; sinon renvoyez None (un cycle existe).
"""
# 1. Calculer le degré entrant de tous les nœuds
in_degree = {node: 0 for node in graph}
for node in graph:
for neighbor in graph[node]:
in_degree[neighbor] = in_degree.get(neighbor, 0) + 1
# 2. Initialiser la file d'attente et enfiler tous les nœuds de degré entrant 0
queue = deque([node for node in in_degree if in_degree[node] == 0])
topo_order = []
# 3. Traiter la file d'attente
while queue:
current_node = queue.popleft()
topo_order.append(current_node)
# "Supprimer" le nœud courant et mettre à jour les degrés entrants de ses voisins
for neighbor in graph.get(current_node, []):
in_degree[neighbor] -= 1
if in_degree[neighbor] == 0:
queue.append(neighbor)
# 4. Vérifier si tous les nœuds ont été triés
if len(topo_order) == len(graph):
return topo_order
else:
return None # Un cycle existe dans le graphe
# --- Exemple de test ---
# Définir un graphe orienté des dépendances entre cours
# Par exemple : avant de suivre le cours d'algorithmes (Algo), il faut suivre le cours de structures de données (DS)
course_graph = {
Programmation: [Structures de données, Algorithmes],
Structures de données: [Algorithmes, Bases de données],
Algorithmes: [Apprentissage automatique],
Bases de données: [Conception de systèmes],
Mathématiques: [Apprentissage automatique],
Apprentissage automatique: [],
Conception de systèmes: []
}
print("Graphe des dépendances des cours :")
for course, deps in course_graph.items():
print(f" {course} -> {deps}")
result = topological_sort_kahn(course_graph)
if result:
print(f"\nUn ordre d'apprentissage des cours réalisable (tri topologique) est :")
print(" -> ".join(result))
else:
print("\nLe calendrier des cours comporte des dépendances circulaires et ne peut pas être trié !")
Analyse du code ligne par ligne:
in_degreeUn dictionnaire enregistre le degré entrant de chaque nœud. Parcourir la liste d'adjacence permet de calculer combien d'arêtes pointent vers chaque nœud.- Initialiser la file
queue, ajouter tous les nœuds sans « tâches préalables » (degré entrant 0) à la file. - Dans la boucle principale, retirer des nœuds de la file et les ajouter à la liste de résultats
topo_order, ce qui équivaut à terminer cette tâche. - Parcourir toutes les tâches successeurs (voisins) de cette tâche, en décrémentant leur degré entrant de 1. S'il passe à 0, cela signifie que toutes les tâches préalables de cette tâche ont été terminées, et elle peut être ajoutée à la file pour exécution.
- Enfin, vérifiez la longueur du résultat du tri. Si elle est identique au nombre de nœuds du graphe, cela réussit ; sinon, cela signifie que certains nœuds ont toujours des dépendances préalables (degré entrant non nul), ce qui indique un cycle dans le graphe.
Exécutez le code ci-dessus et vous obtiendrez un ordre d'apprentissage réalisable:
Course dependency graph:
  程序设计 -> ['数据结构', '算法']
  数据结构 -> ['算法', '数据库']
  算法 -> ['机器学习']
  数据库 -> ['系统设计']
  数学 -> ['机器学习']
  机器学习 -> []
  系统设计 -> []

A feasible course learning order (topological sort) is:
程序设计 -> 数学 -> 数据结构 -> 算法 -> 数据库 -> 机器学习 -> 系统设计
Remarque : le résultat du tri topologique peut ne pas être unique. Par exemple, les mathématiques et la programmation sont des nœuds de départ avec un degré entrant 0, et l'un ou l'autre peut venir en premier.
Comparaison des algorithmes et scénarios d'application
Pour vous aider à mieux comprendre et choisir ces algorithmes, le tableau suivant résume leurs caractéristiques clés :
| 算法 | Objectif principal | Types de graphes applicables | Idée centrale | Complexité temporelle (en utilisant une file de priorité) | Scénarios d'application typiques |
|---|---|---|---|---|---|
| Dijkstra | Plus court chemin à source unique | avec des poids non négatifsgraphe orienté/non orienté | Glouton, en étendant à chaque fois le nœud actuellement le plus proche du nœud de départ | O((V+E) log V) | Navigation cartographique, routage réseau |
| Prim | Arbre couvrant de poids minimal (MST) | Graphe non orienté connexe pondéré | Glouton, en intégrant à chaque fois dans l'arbre le nœud le plus proche de l'arbre couvrant actuel | O((V+E) log V) | Câblage réseau, conception de circuits imprimés, analyse de regroupement |
| Kahn (tri topologique) | Ordonnancement et séquencement des tâches | Graphe orienté acyclique (DAG) | En fonction du degré entrant, supprimer de manière répétée les nœuds sans dépendances prérequises | O(V+E) | Planification de cours, dépendances du système de build, ordre de compilation |
Exercices pratiques
Il ne suffit pas de regarder ; il faut pratiquer concrètement pour vraiment maîtriser ! Veuillez essayer de faire les exercices suivants :
Exercice 1 : Corriger l'algorithme de Dijkstra
Le code suivant est censé implémenter l'algorithme de Dijkstra, mais il contient plusieurs bogues. Veuillez les trouver et les corriger.
Exemple
def wrong_dijkstra(graph, start):
dist = {node: float('inf') for node in graph}
dist[start] = 0
pq = [(0, start)]
while pq:
cur_dist, cur_node = pq.pop(0) # Il y a peut-être un problème ici
for neighbor, weight in graph[cur_node]:
if cur_dist + weight < dist[neighbor]:
dist[neighbor] = cur_dist + weight
# Il manque peut-être quelque chose ici
return dist
Exercice 2 : Implémenter l'algorithme de Kruskal
L'algorithme de Prim est une méthode pour trouver un arbre couvrant minimal ; une autre méthode classique estl'algorithme de Kruskal. L'idée est :
- Trier toutes les arêtes du graphe par poids, du plus petit au plus grand.
- Considérez chaque arête dans l'ordre ; si les deux nœuds reliés par cette arêtene sont pas dans la même composante connexe(c'est-à-dire que l'ajouter ne formera pas de cycle), puis ajoutez-la à l'arbre couvrant minimal.
- Répétez l'étape 2 jusqu'à ce que le MST ait V-1 arêtes (V est le nombre de nœuds).
Votre tâche: Essayez d'utiliser la structure de données « Disjoint Set Union (DSU) » pour implémenter l'algorithme de Kruskal, afin de déterminer efficacement si deux nœuds sont connectés.
Exercice 3 : défi avec des données réelles
Supposons que vous ayez unfriendships.jsonLe fichier enregistre des utilisateurs (représentés par des ID) et leurs relations d'amitié dans un réseau social. Chaque relation a un poids d'« intimité ».
[
  {"user_id": 1, "friend_id": 2, "closeness": 5},
  {"user_id": 1, "friend_id": 3, "closeness": 2},
  {"user_id": 2, "friend_id": 3, "closeness": 1},
  {"user_id": 2, "friend_id": 4, "closeness": 6},
  {"user_id": 3, "friend_id": 4, "closeness": 3},
  {"user_id": 4, "friend_id": 5, "closeness": 4}
]
Problème: si le poids d'« intimité » peut être considéré comme une distance (plus la valeur est petite, plus la relation est proche), veuillez calculer à partir de l'utilisateur1de départ, vers tous les autres utilisateurs, le « chemin le plus intime » (c'est-à-dire le chemin dont la somme des poids est la plus petite). Quel algorithme devriez-vous utiliser ? Veuillez écrire du code pour le résoudre.