Продвинутые алгоритмы на графах
В предыдущем базовом руководстве мы уже изучили основные понятия графов, способы представления и базовые алгоритмы, такие как поиск в ширину (BFS) и поиск в глубину (DFS). Эти алгоритмы помогли нам решать задачи, например, связаны ли две точки и обход графа.
Однако многие сложные задачи реального мира, такие как рекомендации друзей в социальных сетях, планирование кратчайшего пути в навигации по картам, оптимальное расположение маршрутов в логистике и доставке и даже ранжирование веб-страниц в интернете, требуют более мощных и эффективных алгоритмов. ЭтоПродвинутые алгоритмы на графахЗадача, которую предстоит решить.
Продвинутые алгоритмы на графахЭто как профессиональный инструмент, предназначенный для решения конкретных сложных задач:
- Сетевой поток: решает задачи распределения потоков, такие как транспортировка и логистика
- Паросочетание в двудольном графе: решает задачи сопоставления, такие как назначение задач и составление брачных пар
- Компоненты сильной связности: анализ структуры связности графов
- Топологическая сортировка: решение задач зависимостей
Пример из реальной жизни:
- Сетевой поток: например, оптимизация транспортных потоков в городских транспортных системах
- Паросочетание в двудольном графе: например, системы составления брачных пар
- Компоненты сильной связности: например, анализ кругов друзей в социальных сетях
- Топологическая сортировка: например, сортировка зависимостей задач
| Типы задач | Общие алгоритмы | Продвинутые алгоритмы на графах |
|---|---|---|
| Оптимизация потоков | Сложно моделировать и решать | Алгоритмы сетевого потока специально решают |
| Задача о паросочетании | Полный перебор неэффективен | Паросочетание в двудольном графе эффективно решает |
| Анализ связности | Базовые DFS/BFS предоставляют ограниченную информацию | Компоненты сильной связности обеспечивают углублённый анализ |
| Сортировка зависимостей | Трудно обрабатывать сложные зависимости | Топологическая сортировка идеально решает |
Задача о кратчайшем пути и алгоритм Дейкстры
Представьте, что вы используете приложение с картой, чтобы спланировать маршрут от дома до офиса. На карте бесчисленное множество путей, и у каждого пути разное время в пути (вес). Ваша цель — найтикратчайшее общее время в путитот путь; это классическаязадача о кратчайшем пути из одной вершины。
Основная идея алгоритма
Алгоритм Дейкстрырешаетвзвешенные графы с неотрицательными весамиЖадный алгоритм для задачи о кратчайшем пути из одной вершины. Его основная идея похожа на осторожного исследователя:
- Он поддерживает множество узлов с "известными кратчайшими расстояниями."
- Каждый раз выбирайте один из "неизвестной области"Узел, ближайший к начальной точкеузел, подтвердите его кратчайшее расстояние.
- Затем используйте этот только что подтверждённый узел, чтобы обновить "оценочное кратчайшее расстояние" всех его соседей.
- Повторяйте этот процесс, пока не будут подтверждены кратчайшие расстояния всех узлов.
Подробное объяснение шагов алгоритма
Давайте воспользуемся блок-схемой, чтобы интуитивно понять процесс выполнения алгоритма Дейкстры:
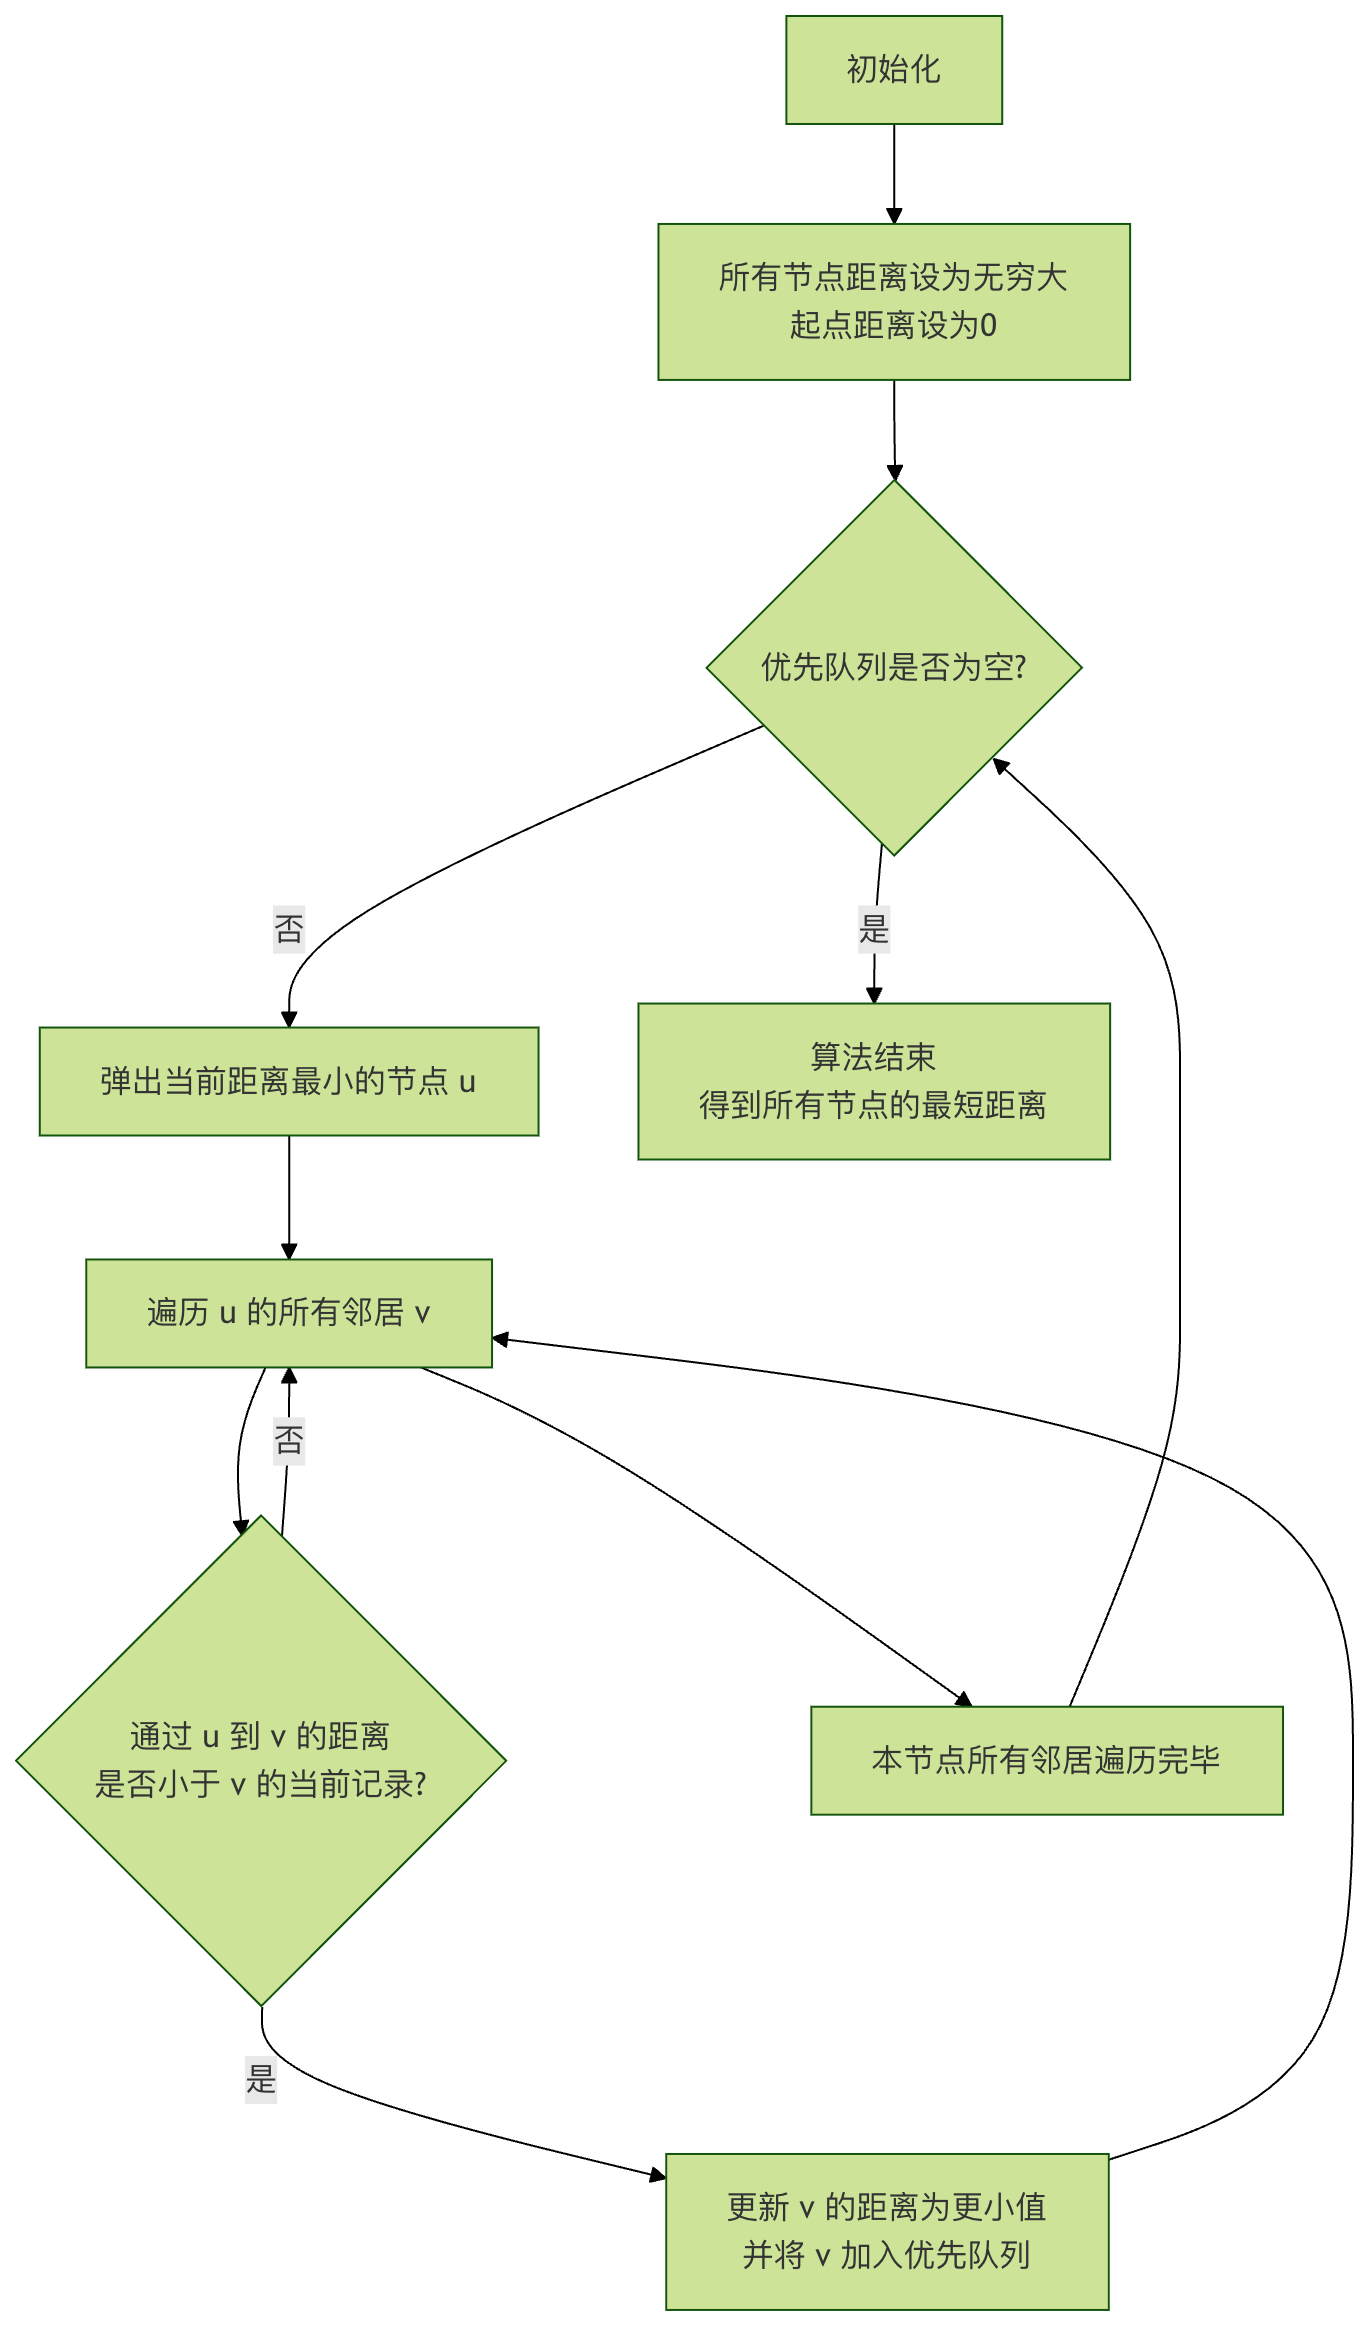
Пояснение к блок-схеме: Алгоритм начинается с инициализации, непрерывно извлекает из очереди с приоритетом необработанный узел, ближайший к начальной точке, и использует его для релаксации (обновления) оценок расстояний до соседних узлов, пока очередь не опустеет, после чего все кратчайшие пути будут определены.
Реализация кода и примеры
Далее мы реализуем алгоритм Дейкстры на Python. Мы будем использоватьheapqэтот модуль очереди с приоритетом (min-heap) для эффективного получения узла с текущим минимальным расстоянием.
Пример
def dijkstra(graph, start):
"""
Используйте алгоритм Дейкстры, чтобы вычислить кратчайшие расстояния от начальной точки start до всех остальных узлов графа.
Параметры:
graph: Список смежности, представленный в виде словаря. Формат: {node: [(neighbor1, weight1), (neighbor2, weight2), ...]}
start: Начальный узел.
Возвращает:
Словарь, содержащий кратчайшие расстояния от всех узлов до начальной точки.
"""
# Инициализация: задать кратчайшее расстояние для всех узлов равным бесконечности
shortest_distances = {node: float('inf') for node in graph}
shortest_distances[start] = 0 # Расстояние от начального узла до самого себя равно 0
# Использовать очередь с приоритетом (min-heap), элементы — (текущее расстояние, узел)
priority_queue = [(0, start)]
while priority_queue:
current_distance, current_node = heapq.heappop(priority_queue)
# Если извлечённое расстояние больше записанного, это устаревшие данные; пропустить
if current_distance > shortest_distances[current_node]:
continue
# Обойти всех соседей текущего узла
for neighbor, weight in graph[current_node]:
distance = current_distance + weight
# Если найден более короткий путь, обновить
if distance < shortest_distances[neighbor]:
shortest_distances[neighbor] = distance
heapq.heappush(priority_queue, (distance, neighbor))
return shortest_distances
# --- Тестовый пример ---
# Определяем взвешенный ориентированный граф (node: [(neighbor, weight), ...])
test_graph = {
'A': [('B', 4), ('C', 2)],
'B': [('C', 1), ('D', 5)],
'C': [('B', 1), ('D', 8), ('E', 10)],
'D': [('E', 2)],
'E': []
}
start_node = 'A'
distances = dijkstra(test_graph, start_node)
print(f"Кратчайшие расстояния от узла {start_node} до каждого узла:")
for node, dist in distances.items():
print(f" до узла {node}: {dist}")
Пояснение кода:
shortest_distancesСловарь используется для записи, от начального узла до каждого узла,Окончательное подтверждениекратчайшего расстояния, с начальным значением бесконечность.priority_queueЭто минимальная куча, всегда позволяющая быстро извлекать узел, который в текущий момент оценивается как ближайший к начальному узлу.- В основном цикле,
heapq.heappopИзвлеките верхний узел кучи (текущий ближайший узел). if current_distance > ... : continueЭто ключевая оптимизация для обработки возможного наличия нескольких устаревших версий (значений расстояния) одного и того же узла в куче.- При обходе соседей вычислите
distance = current_distance + weight, это "новое расстояние до соседа через текущий узел." - Если новое расстояние короче, обновите его
shortest_distancesиПоместите соседа и его новое расстояние в кучудля последующей обработки.
Запустив приведённый выше код, вы получите следующий вывод:
从节点 A 出发到各节点的最短距离:
  到节点 A: 0
  到节点 B: 3  # 路径: A -> C -> B
  到节点 C: 2  # 路径: A -> C
  到节点 D: 8  # 路径: A -> C -> B -> D
  到节点 E: 10 # 路径: A -> C -> B -> D -> E
Минимальное остовное дерево и алгоритм Прима
Теперь рассмотрим другую задачу: нужно проложить оптоволоконную сеть для нового жилого района, соединив все дома, но для экономии затрат вы хотите, чтобы общая длина использованного оптоволокна была наименьшей. Зная стоимость (вес) прокладки оптоволокна между каждыми двумя домами, как выбрать, какие линии прокладывать?
Эта задача требует найтиподграф, соединяющий все узлы, причём этот подграф является деревом (без циклов), а суммарный вес всех его рёберминимизируется. Такое дерево называетсяминимальным остовным деревом (MST)。
Идея алгоритма Прима
Алгоритм Прима— это жадный алгоритм для поиска минимального остовного дерева (MST). Его процесс очень напоминает «выращивание дерева»:
- Начните с любого узла и инициализируйте дерево так, чтобы оно содержало только этот узел.
- среди всехсоединяющих внутренние узлы и внешние узлы дереварёбер выберите одноминимального весаребро.
- Добавьте это ребро и узел, который оно соединяет,внешний узел, в дерево.
- Повторяйте шаги 2 и 3, пока все узлы не будут включены в дерево.
Реализация кода и примеры
Реализация алгоритма Прима очень похожа на реализацию алгоритма Дейкстры; разница заключается в определении расстояния.
В алгоритме Прима мы поддерживаем расстояние от каждого узла дотекущего остовного дерева— минимальную стоимость подключения.
Пример
def prim_mst(graph):
"""
Используйте алгоритм Прима, чтобы вычислить суммарный вес минимального остовного дерева (MST) графа.
Параметры:
graph: Список смежности, представленный в виде словаря. Формат: {node: [(neighbor1, weight1), (neighbor2, weight2), ...]}
Предполагается, что граф связный.
Возвращает:
Суммарный вес минимального остовного дерева.
"""
start_node = list(graph.keys())[0] # Начните с любого узла; здесь возьмём первый.
visited = set([start_node]) # Множество узлов, уже добавленных в MST
# Приоритетная очередь, хранящая (вес ребра, соседний узел)
# Инициализация: добавить все рёбра начального узла в очередь
edges = [(weight, start_node, neighbor) for neighbor, weight in graph[start_node]]
heapq.heapify(edges)
total_weight = 0
while edges:
weight, from_node, to_node = heapq.heappop(edges)
if to_node not in visited:
visited.add(to_node) # Добавить новый узел в MST
total_weight += weight # Накопить общий вес MST
print(f"Добавить ребро: {from_node} - {to_node}, вес: {weight}") # Вывести выбранные рёбра
# Добавить все рёбра, соединяющие новый узел с внешними узлами, в очередь
for neighbor, w in graph[to_node]:
if neighbor not in visited:
heapq.heappush(edges, (w, to_node, neighbor))
return total_weight
# --- Тестовый пример ---
# Определить неориентированный взвешенный граф (каждое ребро встречается дважды в списке смежности)
test_graph_undirected = {
'A': [('B', 4), ('C', 2)],
'B': [('A', 4), ('C', 1), ('D', 5)],
'C': [('A', 2), ('B', 1), ('D', 8), ('E', 10)],
'D': [('B', 5), ('C', 8), ('E', 2)],
'E': [('C', 10), ('D', 2)]
}
print("Процесс построения минимального остовного дерева:")
mst_weight = prim_mst(test_graph_undirected)
print(f"\nОбщий вес минимального остовного дерева: {mst_weight}")
Пояснение кода:
visitedМножество хранит узлы, которые уже принадлежат MST.edges— это минимальная куча, хранящая всеРёбра, соединяющие внутреннюю и внешнюю часть MSTребро (т. е. одна конечная точка находится вvisited, а другой конец не находится в нём).- В основном цикле всегда выбирается ребро с наименьшим весом из кучи
(weight, from_node, to_node)。 - Если узел, соединённый этим ребром,
to_nodeещё не посещён, то это допустимое ребро MST. Добавьте его в результат и обновитеvisitedиtotal_weight。 - Добавьте новый узел
to_nodeвсе его рёбра, ведущие к внешним узлам, добавляются в кучу для следующего раунда выбора.
Запустите приведённый выше код, и вы увидите процесс построения MST:
构建最小生成树的过程:
添加边: A - C, 权重: 2
添加边: C - B, 权重: 1
添加边: A - B, 权重: 4  # 注意:这条边连接B和A,但B已在树中,所以会被下一行的if语句跳过,不会添加。
添加边: B - D, 权重: 5
添加边: D - E, 权重: 2

最小生成树的总权重为: 10
(Примечание: в фактическом выводе ребро A - B, потому чтоto_nodeB уже присутствуетvisited, поэтому она не будет выполненаprintинструкция. Приведённый выше комментарий предназначен для пояснения.)Итоговые рёбра MST: A-C, C-B, B-D, D-E, а суммарный вес равен 2+1+5+2=10.
Топологическая сортировка: обработка задач с зависимостями
Когда нужно запланировать последовательность задач, и некоторые задачи должны начинаться после завершения других задач (например, надевание носков должно предшествовать надеванию обуви), как определить разумный порядок выполнения? Зависимости между задачами можно представить с помощьюориентированного ациклического графа (DAG), а процесс поиска допустимого линейного порядка выполнения — этотопологическая сортировка。
Алгоритм Кана (на основе входящей степени)
Алгоритм КанаЭто один из самых интуитивно понятных алгоритмов топологической сортировки, основанный на входящей степени (количестве рёбер, указывающих на вершину).
- Найдите все вершины с входящей степенью 0; это задачи, которые можно выполнить немедленно (без предварительных зависимостей).
- Поместите эти вершины в очередь и «удалите» их из графа (выведите их в результат сортировки).
- После «удаления» вершины обновите входящую степень всех её соседей (уменьшите на 1). Если в результате входящая степень соседа становится равной 0, добавьте его в очередь.
- Повторяйте шаги 2 и 3, пока очередь не опустеет.
- Если количество выходных узлов равно общему количеству узлов в графе, сортировка успешна; в противном случае это означает, что граф содержит цикл и не может быть топологически отсортирован.
Реализация кода и примеры
Пример
def topological_sort_kahn(graph):
"""
Используйте алгоритм Кана для топологической сортировки.
Параметры:
graph: список смежности, представленный в виде словаря. Формат: {node: [neighbor1, neighbor2, ...]}
Возвращает:
Если топологическая сортировка существует, верните список (отсортированный порядок); в противном случае верните None (существует цикл).
"""
# 1. Вычислите входящую степень всех узлов
in_degree = {node: 0 for node in graph}
for node in graph:
for neighbor in graph[node]:
in_degree[neighbor] = in_degree.get(neighbor, 0) + 1
# 2. Инициализировать очередь и добавить в очередь все узлы с входящей степенью 0
queue = deque([node for node in in_degree if in_degree[node] == 0])
topo_order = []
# 3. Обработать очередь
while queue:
current_node = queue.popleft()
topo_order.append(current_node)
# "Удалить" текущий узел и обновить входящие степени его соседей
for neighbor in graph.get(current_node, []):
in_degree[neighbor] -= 1
if in_degree[neighbor] == 0:
queue.append(neighbor)
# 4. Проверить, все ли узлы были отсортированы
if len(topo_order) == len(graph):
return topo_order
else:
return None # В графе существует цикл
# --- Тестовый пример ---
# Определите ориентированный граф зависимостей курсов
# Например: прежде чем проходить курс по алгоритмам (Algo), нужно пройти курс по структурам данных (DS)
course_graph = {
Программирование: [Структуры данных, Алгоритмы],
Структуры данных: [Алгоритмы, Базы данных],
Алгоритмы: [Машинное обучение],
Базы данных: [Проектирование систем],
Математика: [Машинное обучение],
Машинное обучение: [],
Проектирование систем: []
}
print("Граф зависимостей курсов:")
for course, deps in course_graph.items():
print(f" {course} -> {deps}")
result = topological_sort_kahn(course_graph)
if result:
print(f"\nВозможный порядок изучения курсов (топологическая сортировка):")
print(" -> ".join(result))
else:
print("\nРасписание курсов имеет циклические зависимости и не может быть отсортировано!")
Построчный анализ кода:
in_degreeСловарь хранит входящую степень каждого узла. Обход списка смежности позволяет подсчитать, сколько рёбер указывает на каждый узел.- Инициализируйте очередь
queue, добавьте в очередь все узлы, у которых «нет предварительных задач» (входящая степень 0). - В основном цикле извлекайте узлы из очереди и добавляйте их в список результатов
topo_order, что эквивалентно выполнению этой задачи. - Обойдите все последующие задачи (соседей) этой задачи, уменьшая их входящую степень на 1. Если она становится равной 0, это означает, что все предварительные задачи этой задачи выполнены, и её можно добавить в очередь на выполнение.
- Наконец, проверьте длину результата сортировки. Если она совпадает с количеством узлов графа, то это успех; в противном случае это означает, что у некоторых узлов всегда есть предварительные зависимости (входящая степень не равна 0), то есть в графе есть цикл.
Запустите приведённый выше код, и вы получите допустимый порядок обучения:
Course dependency graph:
  程序设计 -> ['数据结构', '算法']
  数据结构 -> ['算法', '数据库']
  算法 -> ['机器学习']
  数据库 -> ['系统设计']
  数学 -> ['机器学习']
  机器学习 -> []
  系统设计 -> []

A feasible course learning order (topological sort) is:
程序设计 -> 数学 -> 数据结构 -> 算法 -> 数据库 -> 机器学习 -> 系统设计
Примечание: результат топологической сортировки может быть не единственным. Например, и математика, и программирование являются начальными узлами с входящей степенью 0, и любая из них может идти первой.
Сравнение алгоритмов и сценарии применения
Чтобы помочь вам лучше понять и выбрать эти алгоритмы, в следующей таблице обобщены их ключевые характеристики:
| Алгоритмы | Основное назначение | Применимые типы графов | Основная идея | Временная сложность (с использованием очереди с приоритетом) | Типичные сценарии применения |
|---|---|---|---|---|---|
| Dijkstra | Кратчайший путь от одного источника | с неотрицательными весамиориентированный/неориентированный граф | Жадный алгоритм: каждый раз раскрывает узел, ближайший к начальному узлу | O((V+E) log V) | Навигация по карте, маршрутизация в сети |
| Prim | Минимальное остовное дерево (MST) | Взвешенный связный неориентированный граф | Жадный алгоритм: каждый раз включает в дерево узел, ближайший к текущему остовному дереву | O((V+E) log V) | Прокладка сетевых кабелей, проектирование печатных плат, кластерный анализ |
| Алгоритм Кана (топологическая сортировка) | Планирование и упорядочивание задач | Ориентированный ациклический граф (DAG) | На основе входящей степени многократно удаляем вершины без предварительных зависимостей | O(V+E) | Составление расписания курсов, зависимости системы сборки, порядок компиляции |
Практические упражнения
Недостаточно просто смотреть; чтобы действительно освоить это, нужна практика! Пожалуйста, попробуйте выполнить следующие упражнения:
Упражнение 1: Исправьте алгоритм Дейкстры
Следующий код должен реализовывать алгоритм Дейкстры, но в нём есть несколько ошибок. Пожалуйста, найдите и исправьте их.
Пример
def wrong_dijkstra(graph, start):
dist = {node: float('inf') for node in graph}
dist[start] = 0
pq = [(0, start)]
while pq:
cur_dist, cur_node = pq.pop(0) # Здесь может быть проблема
for neighbor, weight in graph[cur_node]:
if cur_dist + weight < dist[neighbor]:
dist[neighbor] = cur_dist + weight
# Возможно, здесь что-то пропущено
return dist
Упражнение 2: Реализуйте алгоритм Краскала
Алгоритм Прима — это один из методов поиска MST; другой классический метод — этоалгоритм Краскала. Идея такова:
- Отсортируйте все рёбра в графе по весу от наименьшего к наибольшему.
- Рассмотрите каждое ребро по порядку; если две вершины, соединённые этим ребром,не находятся в одной компоненте связности(то есть его добавление не образует цикл), то добавьте его в MST.
- Повторяйте шаг 2, пока в MST не будет V-1 рёбер (V — количество вершин).
Ваша задача: попробуйте использовать структуру данных «Disjoint Set Union (DSU)» для реализации алгоритма Краскала, чтобы эффективно определять, соединены ли две вершины.
Упражнение 3: задача на реальных данных
Предположим, у вас естьfriendships.jsonВ файле записаны пользователи (представленные идентификаторами) и их дружеские связи в социальной сети. Каждая связь имеет вес «близости».
[
  {"user_id": 1, "friend_id": 2, "closeness": 5},
  {"user_id": 1, "friend_id": 3, "closeness": 2},
  {"user_id": 2, "friend_id": 3, "closeness": 1},
  {"user_id": 2, "friend_id": 4, "closeness": 6},
  {"user_id": 3, "friend_id": 4, "closeness": 3},
  {"user_id": 4, "friend_id": 5, "closeness": 4}
]
Задача: если вес «близости» можно рассматривать как расстояние (чем меньше значение, тем ближе связь), вычислите от пользователя1start, до всех остальных пользователей «самый близкий путь» (т. е. путь с наименьшей суммой весов). Какой алгоритм следует использовать? Напишите код для решения.