NLP テキスト類似度計算
テキスト類似度計算は自然言語処理(NLP)における基礎的なタスクであり、2つのテキスト断片間の類似度を定量的に評価することを目的としています。この技術は情報検索、質問応答システム、盗用検出、推薦システムなど多くの分野で広く応用されています。
基本概念
- 意味的類似度:テキストが意味的にどれほど近いかを測る
- 文字通りの類似度:テキストの表面的な語彙の重なり具合を測る
- ベクトル空間モデル:テキストを高次元空間のベクトルとして表現する
- 距離測定:ベクトル間の距離または類似度を計算する
よく使われるテキスト類似度計算方法
1. 単語頻度に基づく方法
バッグ・オブ・ワーズ(Bag of Words)
例
from sklearn.feature_extraction.text import CountVectorizer
corpus = [
'私は自然言語処理が好きです',
'私はNLP技術を学ぶのが大好きです',
'テキスト類似度計算はとても面白い'
]
vectorizer = CountVectorizer()
X = vectorizer.fit_transform(corpus)
print(X.toarray())
corpus = [
'私は自然言語処理が好きです',
'私はNLP技術を学ぶのが大好きです',
'テキスト類似度計算はとても面白い'
]
vectorizer = CountVectorizer()
X = vectorizer.fit_transform(corpus)
print(X.toarray())
TF-IDF 手法
例
from sklearn.feature_extraction.text import TfidfVectorizer
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(corpus)
print(tfidf_matrix.toarray())
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(corpus)
print(tfidf_matrix.toarray())
2. 単語ベクトルに基づく方法
Word2Vec 類似度
例
from gensim.models import Word2Vec
sentences = [
['私','好き','自然言語処理'],
['私','愛','学習','NLP','技術'],
['テキスト','類似度','計算','とても','面白い']
]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1, workers=4)
vector = model.wv['自然言語処理'] # 単語ベクトルを取得
sentences = [
['私','好き','自然言語処理'],
['私','愛','学習','NLP','技術'],
['テキスト','類似度','計算','とても','面白い']
]
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1, workers=4)
vector = model.wv['自然言語処理'] # 単語ベクトルを取得
文ベクトル計算
例
import numpy as np
def sentence_vector(sentence, model):
vectors = [model.wv[word] for word in sentence if word in model.wv]
return np.mean(vectors, axis=0) if vectors else np.zeros(model.vector_size)
sentence_vec1 = sentence_vector(['私','好き','自然言語処理'], model)
sentence_vec2 = sentence_vector(['私','愛','NLP'], model)
def sentence_vector(sentence, model):
vectors = [model.wv[word] for word in sentence if word in model.wv]
return np.mean(vectors, axis=0) if vectors else np.zeros(model.vector_size)
sentence_vec1 = sentence_vector(['私','好き','自然言語処理'], model)
sentence_vec2 = sentence_vector(['私','愛','NLP'], model)
3. 事前学習モデルに基づく方法
BERT 類似度計算
例
from transformers import BertTokenizer, BertModel
import torch
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
model = BertModel.from_pretrained('bert-base-chinese')
inputs = tokenizer("これはサンプル文です", return_tensors="pt")
outputs = model(**inputs)
last_hidden_states = outputs.last_hidden_state
import torch
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
model = BertModel.from_pretrained('bert-base-chinese')
inputs = tokenizer("これはサンプル文です", return_tensors="pt")
outputs = model(**inputs)
last_hidden_states = outputs.last_hidden_state
類似度評価指標
よく使われる距離測定方法
| 方法名 | 公式 | 特徴 |
|---|---|---|
| コサイン類似度 | cos(θ) = (A·B)/(|A||B|) | ベクトルの長さを無視し、方向に注目する |
| ユークリッド距離 | √Σ(Ai-Bi)² | ベクトルの絶対位置を考慮する |
| マンハッタン距離 | Σ|Ai-Bi| | 外れ値に敏感ではない |
| Jaccard類似度 | |A∩B|/|A∪B| | 集合の類似度に適している |
コード実装例
例
from sklearn.metrics.pairwise import cosine_similarity
# コサイン類似度を計算
similarity = cosine_similarity(tfidf_matrix[0:1], tfidf_matrix[1:2])
print(f"テキスト類似度: {similarity)
# コサイン類似度を計算
similarity = cosine_similarity(tfidf_matrix[0:1], tfidf_matrix[1:2])
print(f"テキスト類似度: {similarity)
実践応用例
ニュース見出し類似度検出
例
import pandas as pd
from sklearn.metrics.pairwise import cosine_similarity
# サンプルデータ
titles = [
"アップルが新型iPhoneを発表",
"アップル社が最新スマートフォンを発売",
"マイクロソフトが四半期決算を発表",
"グーグルが新たな人工知能計画を発表"
]
# 類似度行列を計算
tfidf = TfidfVectorizer()
tfidf_matrix = tfidf.fit_transform(titles)
similarities = cosine_similarity(tfidf_matrix)
# 結果を表示
df = pd.DataFrame(similarities, columns=titles, index=titles)
print(df)
結果分析
                         苹果发布新款iPhone手机  苹果公司推出最新智能手机  微软公布季度财报  谷歌宣布新的人工智能计划
苹果发布新款iPhone手机           1.000000         0.723417     0.000000         0.000000
苹果公司推出最新智能手机         0.723417         1.000000     0.000000         0.000000
微软公布季度财报               0.000000         0.000000     1.000000         0.204598
谷歌宣布新的人工智能计划         0.000000         0.000000     0.204598         1.000000
応用技術と課題
1. 意味は類似しているが語彙が異なるテキストの処理
例
text1 = "私は猫が好きです"
text2 = "私は犬が嫌いです"
# 表面的な類似度は低いが、意味的にはどちらも動物に対する態度を表している
text2 = "私は犬が嫌いです"
# 表面的な類似度は低いが、意味的にはどちらも動物に対する態度を表している
2. 多義語問題の解決
例
# 「苹果」(アップル)は果物または会社を指すことができる
text1 = "リンゴはとても甘い"
text2 = "アップルの時価総額が最高値を更新"
text1 = "リンゴはとても甘い"
text2 = "アップルの時価総額が最高値を更新"
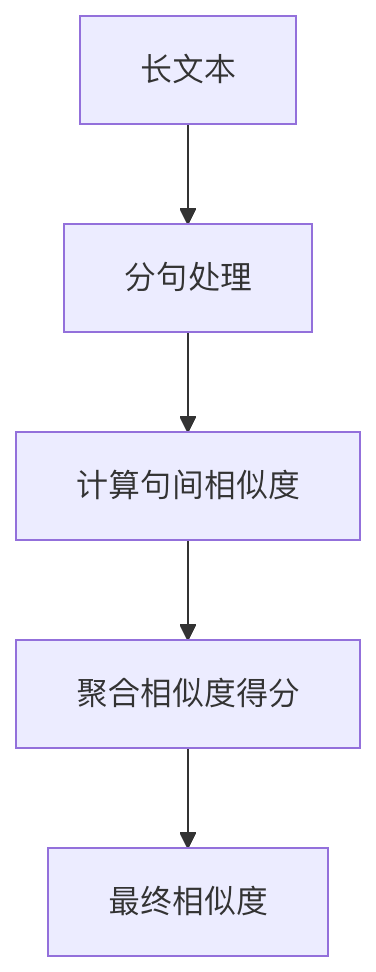
3. 長文テキストの類似度計算
ベストプラクティス提案
データ前処理は非常に重要
- 大文字と小文字を統一
- ストップワードを除去
- ステミング/見出し語化(レンマ化)
シナリオに応じて方法を選択
- 短文テキスト:BERTなどの事前学習モデル
- 長文ドキュメント:TF-IDF + コサイン類似度
- リアルタイムシステム:Word2Vecなどの軽量モデル
計算効率を考慮
- 大規模データには近似最近傍(ANN)アルゴリズムを使用
- Faissなどの高効率類似度検索ライブラリの使用を検討
継続的な評価と最適化
- 人手による評価セットを構築
- 本番環境での効果を監視
- 定期的にモデルを更新