マルチモーダル事前学習モデル
マルチモーダル事前学習モデル(Multimodal Pre-trained Models)とは、複数のデータモダリティを同時に処理・理解できる複数のデータモダリティ(テキスト、画像、音声など)の深層学習モデルです。従来のシングルモーダルモデルとは異なり、これらのモデルは大規模な事前学習を通じて、異なるモダリティ間の関連性と対応関係を学習します。
マルチモーダル学習の核心的な利点
- 情報の補完:異なるモダリティが補完的な情報を提供できる(例:画像は視覚情報を、テキストは意味情報を提供)
- ロバスト性の向上:あるモダリティのデータが欠落している、または品質が低い場合、他のモダリティがサポートを提供できる
- 応用シーンの拡大:より豊富なクロスモーダルタスクをサポート(例:画像とテキストの検索、画像キャプション生成など)
CLIP:画像とテキストの対比学習におけるマイルストーン
基本概念
CLIP(Contrastive Language-Image Pre-training)は、OpenAI が2021年に発表したマルチモーダルモデルで、対比学習によって画像とテキストの間の関連性を構築します。
CLIP は2つの核心的なコンポーネントで構成されています:
- 画像エンコーダー(Image Encoder):画像を特徴ベクトルに変換します(例:Vision Transformer や ResNet を使用)。
- テキストエンコーダー(Text Encoder):テキスト記述を特徴ベクトルに変換します(例:Transformer を使用)。
処理フロー:
- 入力:
- 画像とテキストのペア(例:犬の写真 + 説明文 "a photo of a dog")。
- エンコーディング:
- 画像エンコーダーが画像特徴を抽出し、テキストエンコーダーがテキスト特徴を抽出します。
- 対比学習:
- すべての画像とテキストのペアの類似度行列を計算し、損失関数(例:InfoNCE)を使用してモデルを最適化し、マッチしたペアの特徴を近づけ、マッチしないペアの特徴を遠ざけます。
両者が出力する特徴ベクトルは同じ意味空間にマッピングされ、対比学習によって画像とテキストの表現が整列されます。
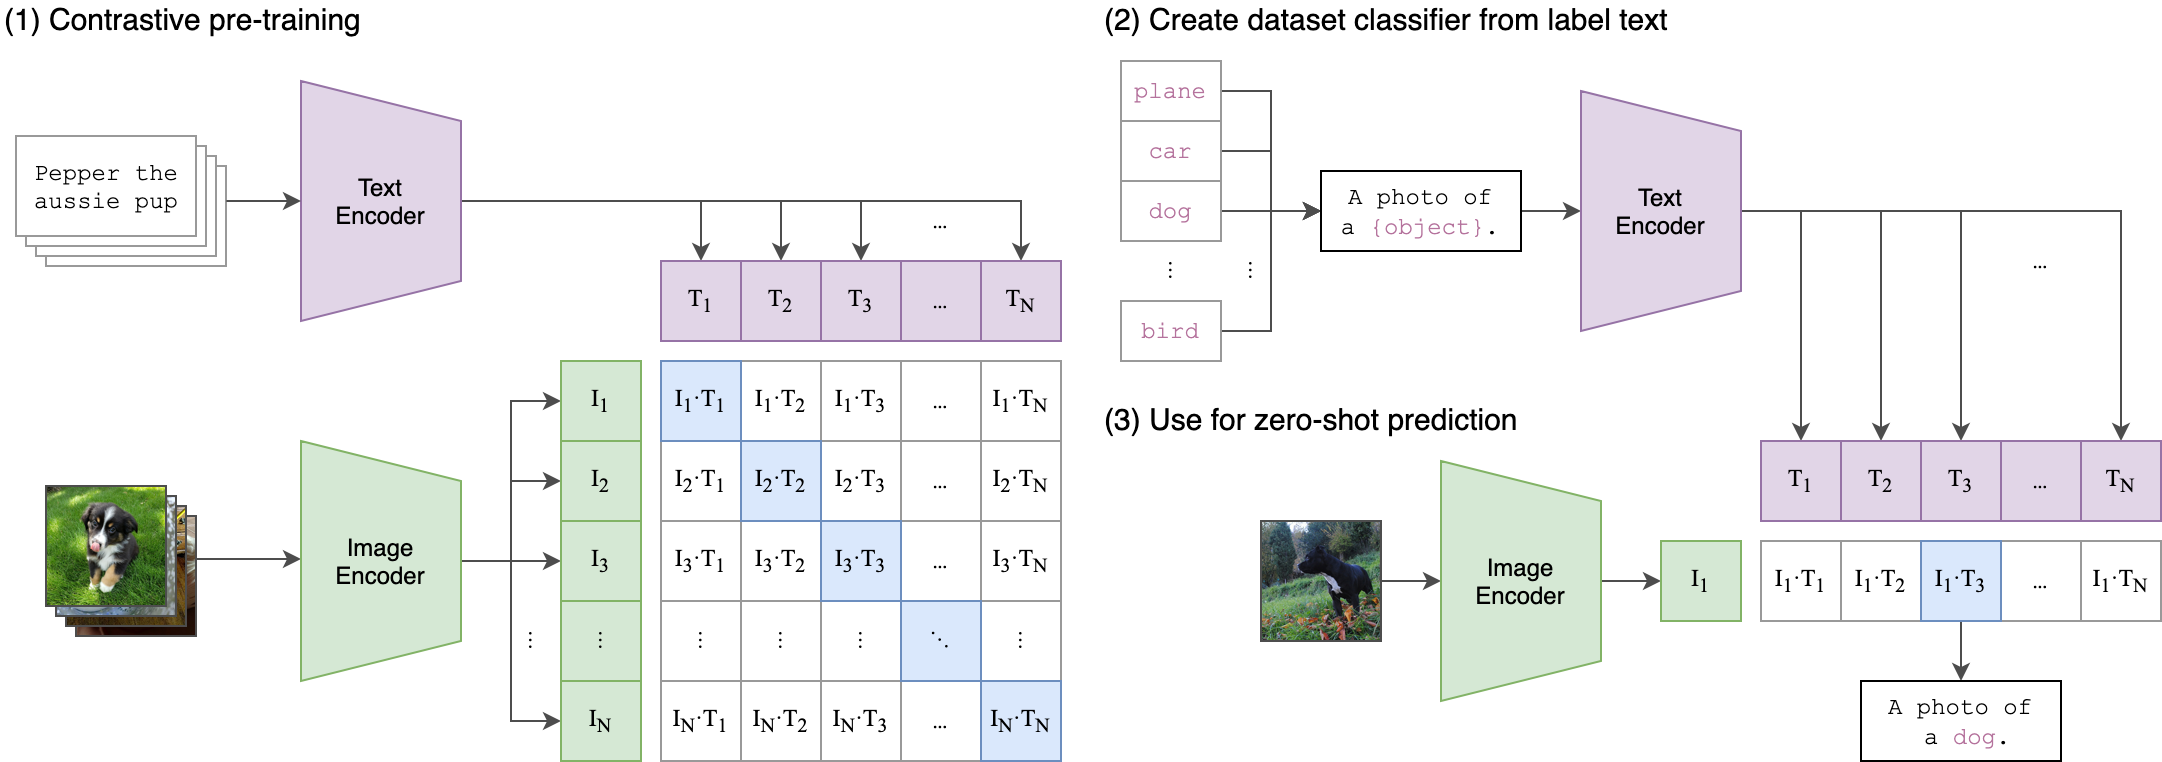
図中の重要な部分の説明
テーブル部分:対比学習マトリクス
このテーブルは画像とテキストのペアの類似度計算を示しています(ここではN個のテキストと4個の画像があると仮定):
- 行(画像):
I1, I2, I3, I4異なる画像特徴を表します。 - 列(テキスト):
T1, T2, ..., TN異なるテキスト特徴を表します。 - セルの値(例:
I1-T1):画像I1とテキストT1の特徴ベクトルのコサイン類似度。
目標:
対角線上の類似度を最大化し(正しいペア、例:I1-T1)、非対角線上の類似度を最小化します(誤ったペア、例:I1-T2)。これが対比学習の核となる考え方です。
例示部分
- 画像の例:
- "Pepper the aussie pup"(オーストラリアン・シェパードの写真)。
- "Planer car dog"(ノイズまたは誤ったラベルの可能性があり、実際には "A photo of a (object)" のテンプレートテキストであるべきもの)。
- テキストテンプレート:
- "A photo of a (object)" は、CLIP の事前学習時によく使用されるテキストプロンプトのテンプレートで、さまざまなカテゴリを汎用化するために使用されます(例:"a photo of a dog")。
モデルアーキテクチャ
- デュアルエンコーダー構造:
- 画像エンコーダー:一般的に Vision Transformer (ViT) または ResNet を使用
- テキストエンコーダー:Transformer アーキテクチャに基づく
- 対比学習の目的:
- ポジティブサンプルペア(マッチした画像とテキストのペア)は特徴空間で近づく
- ネガティブサンプルペア(マッチしない画像とテキストのペア)は特徴空間で遠ざかる
トレーニングプロセス
実例
# CLIP の核心的なトレーニングロジックを示す擬似コード
image_features = image_encoder(image_batch) # 画像特徴の抽出
text_features = text_encoder(text_batch) # テキスト特徴の抽出
# 類似度行列の計算
logits = torch.matmul(image_features, text_features.T) * temperature
labels = torch.arange(batch_size) # 対角線はポジティブサンプル
# 対称な対比損失
loss_img = cross_entropy(logits, labels)
loss_txt = cross_entropy(logits.T, labels)
total_loss = (loss_img + loss_txt)/2
応用シーン
- ゼロショット画像分類:ファインチューニングなしで新しいカテゴリを分類できる
- 画像・テキスト検索:テキストから画像、または画像からテキストへの効率的な検索を実現
- コンテンツモデレーション:テキスト記述と一致しない画像コンテンツを識別する
DALL-E:テキストから画像への生成の魔法
基本概念
DALL-E は OpenAI が開発したテキストから画像を生成するモデルで、自然言語の記述に基づいて高品質な画像を生成できます。
技術的特徴
2段階トレーニング:
- 第1段階:離散変分オートエンコーダー(dVAE)が画像を視覚トークンに圧縮する
- 第2段階:自己回帰 Transformer がテキストから視覚トークンへのマッピングを学習する
重要な革新:
- 画像生成をシーケンス予測問題として扱う
- 12-billion パラメータの Transformer モデルを使用
生成プロセスの例
実例
# DALL-E の生成プロセスを示す擬似コード
text = "宇宙服を着た柴犬が宇宙ステーションでテレビゲームをしている"
text_tokens = tokenizer(text) # テキストエンコーディング
image_tokens = transformer.generate(text_tokens) # 視覚トークンの生成
image = dvae.decode(image_tokens) # 画像へのデコード
text = "宇宙服を着た柴犬が宇宙ステーションでテレビゲームをしている"
text_tokens = tokenizer(text) # テキストエンコーディング
image_tokens = transformer.generate(text_tokens) # 視覚トークンの生成
image = dvae.decode(image_tokens) # 画像へのデコード
モデルの進化
| バージョン | 主な改善点 | 生成能力 |
|---|---|---|
| DALL-E 1 | 基本アーキテクチャ | 256x256 解像度 |
| DALL-E 2 | 拡散モデル | 1024x1024 解像度、より高精度 |
| DALL-E 3 | ChatGPT との統合 | より複雑なプロンプト理解 |
その他の重要なマルチモーダルモデル
ALIGN(Google)
- ノイズの多いウェブデータを使用してトレーニング
- 大規模な弱教師ありデータの有効性を実証
Flamingo(DeepMind)
- インターリーブされたマルチモーダルシーケンスを処理(例:画像とテキストの交互配置)
- 少数ショット学習をサポート
BEiT-3(Microsoft)
- 統一されたマルチモーダル事前学習フレームワーク
- 画像、テキスト、視覚言語タスクのいずれにおいても優れたパフォーマンスを発揮
マルチモーダルモデルの応用における課題
- データ要件:大量の高品質なマルチモーダル整列データが必要
- 計算コスト:これらのモデルのトレーニングには膨大な計算リソースが必要
- 評価の難しさ:統一されたマルチモーダルタスクの評価基準が不足している
- バイアスの問題:トレーニングデータに含まれる社会的バイアスを増幅する可能性がある
実践演習:CLIP を使用したゼロショット分類
実例
import clip
import torch
from PIL import Image
# モデルのロードと前処理
device = "cuda" if torch.cuda.is_available() else "cpu"
model, preprocess = clip.load("ViT-B/32", device=device)
# 入力の準備
image = preprocess(Image.open("dog.jpg")).unsqueeze(0).to(device)
text_inputs = clip.tokenize(["a dog", "a cat", "a bird"]).to(device)
# 特徴の計算
with torch.no_grad():
image_features = model.encode_image(image)
text_features = model.encode_text(text_inputs)
# 類似度の計算
logits = (image_features @ text_features.T).softmax(dim=-1)
print("予測確率:", logits.cpu().numpy())
今後の発展方向
- より効率的なアーキテクチャ:計算コストを削減し、推論速度を向上させる
- より多くのモダリティ融合:音声、動画などより多くのモダリティを追加
- 因果理解能力:マルチモーダルコンテンツに対するモデルの深い理解を強化
- 制御可能な生成:生成コンテンツの精密な制御と編集可能性を向上
マルチモーダル事前学習モデルは、人とコンピュータのインタラクションの方法を再構築しています。CLIP のクロスモーダル理解から DALL-E の創造的な生成まで、これらの技術は AI アプリケーションにまったく新しい可能性を切り開いています。
その他の拡張