Развёртывание локальных моделей
Многие думают, что ИИ можно использовать только в облаке: при использовании ChatGPT данные отправляются на серверы OpenAI, а при использовании Claude запросы отправляются в дата-центры Anthropic.
На самом деле,модели ИИ могут работать полностью на вашем собственном компьютере。
Представьте: вы можете использовать ИИ без сети, конфиденциальные данные никогда не покидают ваш компьютер, не нужно платить за каждый вызов, и вы можете настраивать его как угодно.
В этом ценность локального развёртывания моделей.
Этот модуль проведёт вас от нуля до запуска вашей первой локальной модели ИИ на вашем собственном компьютере.
Зачем нужен локальный ИИ
Облачный ИИ удобен, но у локального ИИ есть незаменимые преимущества.
Защита конфиденциальности данных
Это главная причина, по которой многие выбирают локальное развёртывание.
Если вы работаете с договорами, медицинскими записями, финансовыми данными или внутренними документами, отправлять эти данные на сторонние серверы рискованно.
При локальном запуске,все данные обрабатываются на вашем собственном компьютере и никогда не покидают ваше устройство。
Использование в офлайн-среде
В самолётах, поездах или в местах с нестабильной сетью облачный ИИ недоступен.
После загрузки локальные модели доступны навсегда и не требуют подключения к сети.
Контроль затрат
Облачный ИИ взимает плату в зависимости от количества вызовов или токенов, и при интенсивном использовании это может стать значительными расходами.
Локальные модели загружаются один раз, после чего их можно свободно использовать без дополнительных затрат.
Возможности настройки
Вы не можете изменять облачные модели; можно использовать только предоставленные функции.
С локальными моделями вы можете выполнять тонкую настройку, квантование, изменять шаблоны промптов и полностью настраивать их под свои нужды.
Сравнение этих преимуществ:
| Характеристика | Облачный ИИ | Локальный ИИ |
|---|---|---|
| Конфиденциальность данных | Данные необходимо загружать | Данные полностью локализованы |
| Зависимость от сети | Требуется подключение к интернету | Сеть не требуется |
| Стоимость использования | Оплата по мере использования | Одна загрузка, неограниченное использование |
| Возможность настройки | Ограниченно | Полностью контролируемый |
| Простота использования | Готово к работе из коробки | Требует настройки |
| Скорость отклика | Зависит от сети | Зависит от оборудования |
Не то чтобы облачный ИИ плох, а скорееУ обоих есть свои подходящие сценарииДля повседневного общения используйте облако; для конфиденциальных данных — локальный вариант; для простых задач используйте облако; для особой настройки — локальный.
Оценка требований к оборудованию
Возможность запуска локальной модели и скорость её работы в основном зависят от конфигурации вашего оборудования.
Инференс на CPU против инференса на GPU
Существует два способа запуска моделей: инференс на CPU и инференс на GPU.
Инференс на CPU использует главный процессор компьютера для запуска моделей. Преимущество — хорошая совместимость; почти все компьютеры могут его запускать. Недостаток — низкая скорость; большие модели могут работать долго.
Инференс на GPU использует графические карты. Основное преимущество —мощная способность к параллельным вычислениям, благодаря которой модели работают в десятки раз быстрее。
Для видеокарт NVIDIA необходимо установить CUDA toolkit; для видеокарт AMD можно использовать ROCm; для видеокарт Intel можно использовать OpenVINO.
Связь между требованиями к VRAM и размером модели
VRAM определяет, насколько большую модель вы можете запустить.
Чем больше параметров у модели, тем больше VRAM ей требуется. Однако с помощью методов квантования можно запускать более крупные модели при меньшем объёме VRAM.
| Объём VRAM | Модели, доступные для запуска (FP16) | Модели, доступные для запуска (после квантования) | Рекомендуемые сценарии |
|---|---|---|---|
| 8 GB | Модели 7B несколько сложны | 7B (Q4), 13B (Q4) едва запускаются | Простой чат, лёгкие задачи |
| 16 GB | Модели 7B, 13B | 7B、13B(Q4/Q8)、33B(Q4) | Повседневное использование, лучшее соотношение цены и качества |
| 24 GB | Модели 7B, 13B, 33B | 7B、13B、33B(Q4/Q8)、70B(Q4) | Профессиональное использование, плавная работа |
| 48 GB+ | Модели 33B, 70B | Все основные модели | Исследовательские и производственные среды |
Преимущества серии Mac M
Apple Silicon (чипы серий M1, M2, M3) имеет уникальные преимущества в локальном ИИ.
Фреймворк Metal от Apple и архитектура унифицированной памяти делают компьютеры Mac очень эффективными при запуске локальных моделей.
Унифицированная память означает, чтоCPU и GPU совместно используют памятьи могут автоматически заимствовать память, когда VRAM недостаточно.
MacBook Pro с 16GB унифицированной памяти может без проблем запускать квантованные модели 7B и 13B.
Рекомендуемые варианты конфигурации
В зависимости от разных бюджетов и потребностей, вот несколько вариантов конфигурации:
| План | Конфигурация | Подходит для | Ожидаемый опыт |
|---|---|---|---|
| Начальный план | Любой компьютер (8GB+ ОЗУ) | Новички, которые хотят попробовать локальный ИИ | Может запускать небольшие модели, относительно медленно |
| Оптимальный по цене план | 16GB RAM + 6GB+ VRAM | Личное повседневное использование | Плавная работа моделей 7B/13B |
| Профессиональный план | 32GB RAM + 12GB+ VRAM | Разработчики, исследователи | Плавная работа моделей 33B |
| План для Mac | M1/M2/M3 + 16GB унифицированной памяти | Первый выбор для пользователей Mac | Плавная работа моделей 7B/13B |
Не пугайтесь термина «большая модель». Сегодняшняя технология квантования уже позволяет 7B-моделям работать без сбоев на обычных компьютерах, а возможностей 7B-моделей достаточно для большинства повседневных задач.
Ollama: самый простой локальный ИИ-инструмент
- Официальный сайт Ollama:https://ollama.com/
- Список поддерживаемых моделей Ollama:https://ollama.com/search
- Руководство по Ollama:https://www.example.com/ollama/ollama-tutorial.html
Ollama — сегодня самый популярный инструмент для локальных моделей. Если резюмировать одним предложением:Устанавливайте модели так же, как устанавливаете приложения, используйте ИИ так же, как командную строку。
Установка и настройка
Ollama поддерживает macOS, Linux и Windows, а процесс установки очень прост.
Ссылка для скачивания установщика:https://ollama.com/download
Установка одной командой:
curl -fsSL https://ollama.com/install.sh | sh
Пользователи macOS могут скачать установщик напрямую или установить с помощью Homebrew:
# macOS 使用 Homebrew 安装
brew install ollama

# 或者下载安装包:https://ollama.com/download
Пользователи Windows могут просто скачать установщик с официального сайта и запустить его.
После установки запустите сервис Ollama:
ollama serve
Как только вы увидите, что сервис успешно запущен, можно начинать им пользоваться.
Загрузка моделей
Библиотека моделей Ollama очень богата и включает такие популярные модели, как Llama, Qwen, Gemma и Mistral.
Для загрузки модели достаточно одной команды:
Пример
ollama pull llama3
# Скачать Qwen (Tongyi Qianwen, с поддержкой китайского языка)
ollama pull qwen
# Скачать Gemma (от Google)
ollama pull gemma
# Скачать Mistral
ollama pull mistral
Вы также можете использоватьollama run + имя моделикоманду, которая автоматически загрузит указанную модель, если она ещё не установлена:
ollama run qwen
Запустите модель qwen, загрузив её, если она недоступна.
У каждой модели есть разные версии, например 8B, 70B или различные квантованные версии.
Вы можете использоватьollama listчтобы просмотреть уже загруженные модели:
ollama list
Вывод, похожий на:
NAME              ID              SIZE      MODIFIED
qwen3.5:latest    6488c96fa5fa    6.6 GB    3 months ago
Использование командной строки
После загрузки модели вы можете запустить её напрямую, чтобы начать разговор:
# 运行 Llama 3,没有会下载
ollama run llama3

# 运行 Qwen,没有会下载
ollama run qwen3.5
qwen3.5 более чем достаточно для обычных задач:
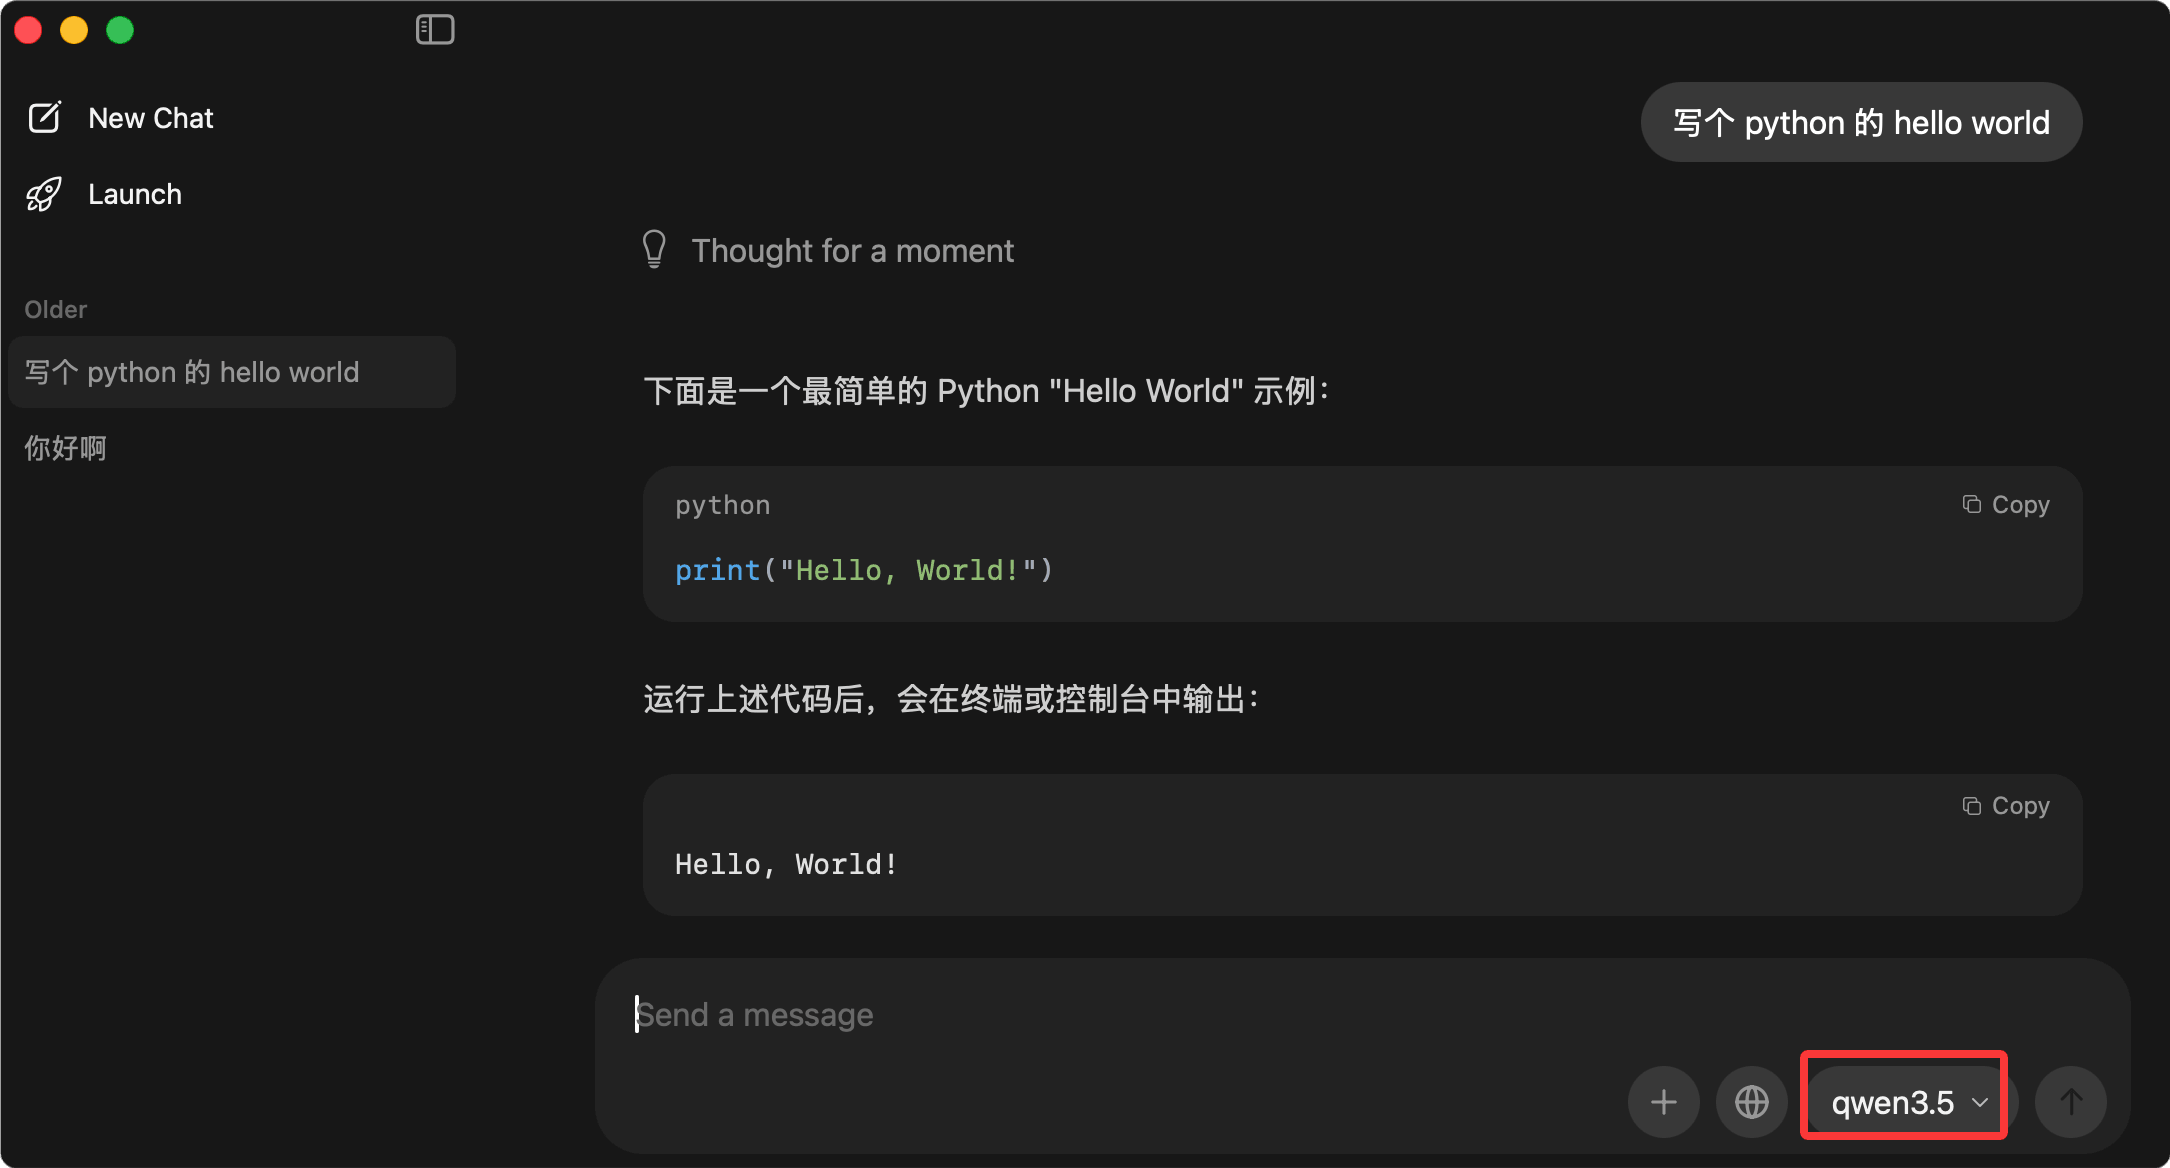
Затем вы можете напрямую общаться с моделью:
>>> 你好,请介绍一下你自己
你好!我是 Llama 3,由 Meta 开发的 AI 助手。我可以帮你回答问题、
写作、编程、分析数据等。有什么我可以帮你的吗?

>>> 用 Python 写一个 Hello World 程序
好的,这是一个简单的 Python Hello World 程序:

print("Hello, World!")

>>> /bye  # 输入 /bye 退出
Основные команды:
| Команда | Функция | Пример |
|---|---|---|
| ollama pull <model> | Скачать модель | ollama pull llama3 |
| ollama run <model> | Запустить модель | ollama run llama3 |
| ollama list | Список установленных моделей | ollama list |
| ollama rm <model> | Удалить модель | ollama rm llama3 |
| ollama show <model> | Просмотреть информацию о модели | ollama show llama3 |
Вызовы интерфейса API
Ollama поставляется с HTTP API, поэтому её можно вызывать из кода, а не только из командной строки.
По умолчанию Ollama находится по адресуhttp://localhost:11434чтобы предоставлять API-сервис.
Вызов API Ollama с помощью Python:
Пример
# Вызов API Ollama с помощью Python
import requests
import json
# Адрес API Ollama
OLLAMA_URL = "http://localhost:11434/api/generate"
def ask_ollama(prompt: str, model: str = "llama3") -> str:
"""
Отправить запрос в Ollama для получения ответа модели
Аргументы:
prompt: запрос, введённый пользователем
model: имя используемой модели, по умолчанию — llama3
Возвращает:
Текст ответа модели
"""
# Сформировать данные запроса
payload = {
"model": model, # Используемая модель
"prompt": prompt, # Пользовательский ввод
"stream": False # Не использовать потоковый вывод, вернуть всё сразу
}
try:
# Отправить POST-запрос
response = requests.post(OLLAMA_URL, json=payload)
response.raise_for_status() # Проверить, был ли запрос успешным
# Разобрать возвращённый JSON
result = response.json()
return result.get("response", "")
except requests.exceptions.ConnectionError:
return "Ошибка: не удалось подключиться к сервису Ollama, пожалуйста, убедитесь, что Ollama запущен"
except requests.exceptions.RequestException as e:
return f"Ошибка запроса: {str(e)}"
# Протестировать это
if __name__ == "__main__":
# Тестовый вопрос 1
question1 = "Пожалуйста, представьте руководство EXAMPLE в одном предложении"
answer1 = ask_ollama(question1)
print(f"Вопрос: {question1}")
print(f"Ответ: {answer1}")
print("-" * 50)
# Тестовый вопрос 2
question2 = "Напишите функцию на Python для вычисления последовательности Фибоначчи"
answer2 = ask_ollama(question2)
print(f"Вопрос: {question2}")
print(f"Ответ: {answer2}")
Запустите этот скрипт:
Пример
pip install requests
# Запустите скрипт
python ollama_test.py
Если вам нужна обёртка более высокого уровня, вы можете использовать официальную библиотеку Python от Ollama:
Пример
# Использование библиотеки Ollama для Python
# Сначала установите: pip install ollama
import ollama
def chat_with_example():
"""
Используйте библиотеку Ollama для Python для многоходовых диалогов
"""
# История сообщений
messages = [
{
"role": "system",
"content": "Ты — дружелюбный помощник по программированию по имени ExampleBot. Твои ответы должны быть краткими и практичными, с большим количеством примеров кода."
}
]
print("ExampleBot запущен! Введите 'quit' для выхода.")
print("-" * 50)
while True:
# Получить ввод пользователя
user_input = input(Вы:)
if user_input.lower() in ["quit", "exit", Выход]:
print(До свидания!)
break
# Добавьте сообщение пользователя в историю
messages.append({
"role": "user",
"content": user_input
})
# Вызвать модель
response = ollama.chat(
model="llama3",
messages=messages
)
# Получить ответ
assistant_message = response["message"]["content"]
print(f"ExampleBot:{assistant_message}")
print("-" * 50)
# Добавить ответ ассистента в историю
messages.append({
"role": "assistant",
"content": assistant_message
})
if __name__ == "__main__":
chat_with_example()
Интеграция с Open WebUI
Командная строка удобна, но графический интерфейс более дружелюбен.
Open WebUI — это очень красивый веб-интерфейс, который может подключаться к Ollama, позволяя использовать локальные модели так же, как ChatGPT.
Установка Open WebUI:
Пример
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:main
# Если вы не используете Docker, установить можно также через pip
pip install open-webui
open-webui serve
После установки откройте в браузереhttp://localhost:3000, и вы увидите интерфейс, очень похожий на ChatGPT.
Ollama + Open WebUI — это на сегодняшний день наиболее рекомендуемое сочетание для локального ИИ: простая установка, удобный интерфейс и высокая мощность; подходит для подавляющего большинства пользователей.
LM Studio: работа через графический интерфейс
Если вы не любите командную строку, LM Studio — отличный выбор.Полностью графический интерфейс: загрузка и запуск моделей выполняются прямо в окне.。
Установка LM Studio
LM Studio поддерживает Windows, macOS и Linux.
С официального сайтаhttps://lmstudio.aiСкачайте установочный пакет и просто установите его.
Загрузка и управление моделями
Откройте LM Studio, библиотека моделей находится слева.
Можно искать по названию модели, например, поискать "llama", "qwen", "mistral", найти нужную модель и нажать «Скачать».
LM Studio автоматически перечислит разные версии одной и той же модели:
| Version | Описание | Рекомендуемый сценарий |
|---|---|---|
| Q4_K_M | 4-битное квантование, небольшая потеря качества | Выбор большинства людей |
| Q5_K_M | 5-битное квантование, лучшее качество, немного больший размер | Выберите это, если у вас достаточно VRAM |
| Q8_0 | 8-битное квантование, близко к исходному качеству | Для тех, кто стремится к качеству и имеет достаточно VRAM |
| FP16 | Полная точность, наибольший размер | Для исследовательских целей |
Скачанные модели появятся в списке "Мои модели".
Локальный API-сервис
LM Studio также может предоставлять API-сервис, совместимый с форматом API OpenAI.
Это означает, что для кода OpenAI, который вы пишете, вам нужно только изменить адрес API и Key, чтобы использовать локальную модель.
Пример
# LM Studio совместим с форматом API OpenAI
from openai import OpenAI
# Подключение к локальному серверу LM Studio
# Примечание: сначала нужно запустить сервер в LM Studio
client = OpenAI(
base_url="http://localhost:1234/v1",
api_key="lm-studio" # LM Studio может просто использовать этот заполнитель
)
def ask_local_model(prompt: str, system_prompt: str = "Вы — полезный ассистент.") -> str:
"""
Вызов локальной модели LM Studio через интерфейс, совместимый с OpenAI
"""
response = client.chat.completions.create(
model="local-model", # Это поле будет проигнорировано LM Studio
messages=[
{"role": "system", "content": system_prompt},
{"role": "user", "content": prompt}
],
temperature=0.7,
)
return response.choices[0].message.content
#
if __name__ == "__main__":
question = "Расскажите о возможностях учебника по Python"
answer = ask_local_model(
prompt=question,
system_prompt="Вы — специальная служба поддержки клиентов Example, профессионально отвечающая на вопросы об изучении программирования."
)
print(f"В: {question}")
print(f"О: {answer}")
Эта функция очень полезна — вы можете использовать один и тот же код для переключения между облачными и локальными моделями по мере необходимости.
Пользователям, которые только начинают работать с локальным ИИ, я рекомендую: сначала освоиться с LM Studio, чтобы понять основные концепции и операции; после ознакомления использовать Ollama для автоматизации и интеграции.
Начало работы с квантованием моделей
Квантование — ключевая технология, позволяющая запускать большие модели на обычных компьютерах —Запускайте более крупные модели с меньшим объёмом VRAM, сохраняя большинство возможностей。
Что такое квантование
Проще говоря, квантование — это снижение точности параметров модели.
Исходные модели обычно хранят каждый параметр, используя 16-битные числа с плавающей запятой (FP16) или 32-битные числа с плавающей запятой (FP32).
После квантования мы используем 8-битные целые числа (INT8) или даже 4-битные целые числа (INT4) для хранения.
Точность снижается, но размер и требования к VRAM значительно сокращаются.
Например:
| Precision | Размер модели 7B | Размер модели 13B | Требования к VRAM | Потеря качества |
|---|---|---|---|---|
| FP16 | 13 GB | 26 GB | Высокая | Отсутствует |
| Q8_0 | 7 GB | 13 GB | Средняя | Очень маленькая |
| Q5_K_M | 5 GB | 9 GB | Низкая | Приемлемо |
| Q4_K_M | 4 GB | 7 GB | Очень низкая | Незначительный |
| Q3_K_M | 3 GB | 5 GB | Крайне низкий | Очевидный |
Практическое правило: квантование Q8 имеет почти незаметную потерю качества, а квантования Q4 достаточно для большинства задач.
Объяснение формата GGUF
GGUF в настоящее время — самый популярный формат квантованных моделей.
Предшественником GGUF является GGML, разработанный проектом llama.cpp.
Преимущества этого формата:
-
Во-первых,Хорошая кроссплатформенная совместимость—Работает в Windows, macOS и Linux; запускается как на CPU, так и на GPU.
-
Во-вторых,Поддерживает несколько уровней квантования—От FP16 до Q3, выбирайте по необходимости.
-
В-третьих,Высокая скорость инференса—Сильно оптимизирован для CPU и GPU.
Большинство локальных инструментов для моделей (Ollama, LM Studio, llama.cpp) теперь поддерживают формат GGUF.
Различия между квантованием Q4/Q8
Q4 и Q8 — два наиболее часто используемых уровня квантования.
Квантование Q8 — это 8-битное квантование; каждый параметр хранится как 8-битное целое. Преимущество Q8 —минимальная потеря качества, почти идентично исходной модели; недостаток — размер всё ещё недостаточно мал.
-
Квантование Q4 — это 4-битное квантование; каждый параметр хранится как 4-битное целое. Преимущество Q4 —малый размер и высокая скорость; недостаток — качество заметно падает на сложных задачах.
Как выбрать:
| Сценарий | Рекомендуемый уровень квантования | Причина |
|---|---|---|
| Очень ограниченный объём видеопамяти (ниже 8GB) | Q4_K_M | Главный приоритет — работоспособность |
| Повседневные разговоры, простые задачи | Q4_K_M | Лучшее соотношение цены и качества |
| Написание текстов, программирование, анализ | Q5_K_M или Q6_K | Баланс качества и скорости |
| Стремление к наилучшему качеству | Q8_0 | Близко к нативному качеству |
Схемы квантования AWQ/GPTQ
Помимо квантования GGUF, существуют две другие распространённые схемы квантования: AWQ и GPTQ.
AWQ (квантование весов с учётом активаций) характеризуется тем, чтосохраняет веса, которые сильно влияют на результаты, что приводит к меньшей потере качества после квантования.
GPTQ (квантование после обучения на основе градиентов) характеризуется тем, чтоиспользует информацию о градиентах для оптимизации квантования, подходит для сценариев с GPU.
Эти две схемы в основном применяются на GPU NVIDIA с поддержкой CUDA.
Простое сравнение:
| Схема квантования | Подходящее оборудование | Скорость | Качество | Рекомендуемые инструменты |
|---|---|---|---|---|
| GGUF | CPU + различные GPU | Высокая | ОК | Ollama、LM Studio |
| AWQ | NVIDIA GPU | Очень быстро | Очень хорошо | vLLM、Text Generation WebUI |
| GPTQ | NVIDIA GPU | Очень быстро | Очень хорошо | AutoGPTQ、ExLlama |
Новичкам не стоит беспокоиться об этих технических деталях — просто используйте версию Q4_K_M, рекомендованную в Ollama или LM Studio. Это лучший баланс, проверенный обширным тестированием.
Руководство по выбору модели
Сейчас существуют сотни открытых моделей; важно выбрать ту, которая подходит вашим потребностям.
Сравнение моделей 7B/13B/70B
Количество параметров — важный показатель: 7B, 13B и 70B — наиболее распространённые спецификации.
| Спецификация | Требования к VRAM (Q4) | Скорость инференса | Уровень возможностей | Применимые сценарии |
|---|---|---|---|---|
| 7B | 4-6 GB | Очень быстро | Достаточный | Повседневные разговоры, простые задачи |
| 13B | 7-10 GB | Высокая | Хороший | Написание текстов, программирование, анализ |
| 33B | 15-20 GB | Средняя | Отличный | Сложные рассуждения, профессиональные области |
| 70B | 30-40 GB | Медленнее | Близко к GPT-3.5 | Исследовательские и производственные среды |
Для большинства людей оптимальным вариантом является квантованная версия 13B Q4 — хорошие возможности при приемлемой скорости.
Рекомендуемые модели с хорошей поддержкой китайского языка
Многие иностранные модели имеют посредственные возможности в китайском. Вот несколько моделей с хорошей поддержкой китайского:
| Название модели | Разработчик | Особенности | Команда Ollama |
|---|---|---|---|
| Qwen (Tongyi Qianwen) | Alibaba | Сильные возможности в китайском, сбалансированная производительность | ollama pull qwen |
| Yi (01.AI) | 01.AI | Хорошее понимание китайского, сильные рассуждения | ollama pull yi |
| DeepSeek | DeepSeek | Сильные навыки программирования, приличный уровень китайского | ollama pull deepseek-coder |
| Llama 3 | Meta | В целом сильна, но китайский требует дообучения | ollama pull llama3 |
| Gemma | Прочная основа, хорошие способности к программированию | ollama pull gemma |
Для задач на китайском Qwen — первый выбор; его понимание и генерация китайского — лучшие среди моделей с открытым исходным кодом.
Выбор модели под конкретную задачу
У разных моделей разные сильные стороны; выбирайте в зависимости от вашей задачи:
| Тип задачи | Рекомендуемая модель | Причина |
|---|---|---|
| Повседневное общение, вопросы и ответы | Llama 3、Qwen、Mistral | Сбалансированные возможности в целом |
| Написание текстов, копирайтинг | Yi, Llama 3, Claude (облако) | Хороший стиль письма, плавное изложение |
| Программирование, код | DeepSeek-Coder、CodeLlama、StarCoder | Сильное понимание кода и генерация |
| Математика, рассуждения | Llama 3、Qwen、WizardMath | Хорошие логические рассуждения |
| Профессиональные области (медицина, юриспруденция) | Модели, дообученные для предметной области | Обучены на профессиональных данных |
Более крупная модель не всегда лучше, и более новая тоже —та, что подходит вашему оборудованию и вашей задаче,является лучшей. Начните с нескольких моделей 7B, чтобы почувствовать разницу, затем переходите на более мощные.
Практическое руководство: создание полностью офлайн локальной базы знаний
Один из самых практичных сценариев использования локальных моделей — создание собственной приватной базы знаний —загружайте локальные документы в модель и заставляйте её отвечать на вопросы по ним.。
Вся система работает полностью офлайн; данные никогда не покидают ваш компьютер.
Технический подход
Мы используем технологию RAG (Retrieval-Augmented Generation):
1. Разбить документы на фрагменты
2. Использовать модель эмбеддингов, чтобы преобразовать каждый фрагмент в вектор
3. Сохранять векторы в векторной базе данных
4. При запросе также преобразовать вопрос в вектор
5. Найти наиболее релевантные фрагменты документов в векторной базе данных
6. Отправить релевантные документы и вопрос вместе в локальную LLM
7. LLM отвечает на основе содержимого документа
Это звучит сложно, но с существующими инструментами всё просто.
Реализация с Ollama + LangChain
Мы будем использовать Python, чтобы реализовать простую версию:
Пример
# Полностью офлайн локальная RAG-система для базы знаний
# Сначала установите зависимости:
# pip install langchain langchain-ollama chromadb pypdf
from langchain_ollama import OllamaLLM, OllamaEmbeddings
from langchain_community.document_loaders import PyPDFLoader, TextLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.vectorstores import Chroma
from langchain.chains import RetrievalQA
import os
class LocalKnowledgeBase:
"""Локальный класс базы знаний, реализующий полностью офлайн-функциональность RAG"""
def __init__(self, model_name: str = "llama3", persist_dir: str = "./chroma_db"):
"""
Инициализировать базу знаний
Аргументы:
model_name: Имя модели Ollama для использования
persist_dir: Каталог сохранения векторной базы данных
"""
self.model_name = model_name
self.persist_dir = persist_dir
# 1. Инициализировать LLM (локальная модель)
self.llm = OllamaLLM(model=model_name)
# 2. Инициализировать модель эмбеддингов (локальные эмбеддинги)
# Используйте nomic-embed-text; эта модель хорошо работает как с китайским, так и с английским
self.embeddings = OllamaEmbeddings(model="nomic-embed-text")
# 3. Заглушка для векторной базы данных
self.vector_store = None
self.qa_chain = None
def load_documents(self, document_paths: list):
"""
Загрузить документы и построить векторную базу данных
Аргументы:
document_paths: список путей к документам
"""
документы = []
for path in document_paths:
if not os.path.exists(path):
print(f"Предупреждение: файл {path} не существует, пропускаем")
continue
# Выбор загрузчика в зависимости от расширения файла
if path.lower().endswith(".pdf"):
loader = PyPDFLoader(path)
elif path.lower().endswith(".txt"):
loader = TextLoader(path, encoding="utf-8")
else:
print(f"Предупреждение: неподдерживаемый тип файла {path}, пропуск")
continue
documents.extend(loader.load())
print(f"Загружено: {path}")
if not documents:
print("Ни один документ не был успешно загружен")
return
print(f"Всего загружено {len(documents)} фрагментов документов")
# 4. Разделение документов
text_splitter = RecursiveCharacterTextSplitter(
chunk_size=500, # Каждый фрагмент: 500 символов
chunk_overlap=100 # Перекрытие между фрагментами: 100 символов
)
split_docs = text_splitter.split_documents(documents)
print(f"Разбито на {len(split_docs)} фрагментов")
# 5. Построение векторной базы данных
print("Строим векторную базу данных...")
self.vector_store = Chroma.from_documents(
documents=split_docs,
embedding=self.embeddings,
persist_directory=self.persist_dir
)
print("Векторная база данных успешно построена!")
# 6. Построение цепочки QA
self._build_qa_chain()
def _build_qa_chain(self):
"""Создать цепочку вопросов-ответов RAG"""
if not self.vector_store:
print("Пожалуйста, сначала загрузите документ!")
return
# Создать retriever
retriever = self.vector_store.as_retriever(
search_type="similarity",
search_kwargs={"k": 3} # Вернуть 3 наиболее релевантных фрагмента
)
# Создать цепочку RAG
self.qa_chain = RetrievalQA.from_chain_type(
llm=self.llm,
chain_type="stuff",
retriever=retriever,
return_source_documents=True
)
def load_existing_db(self):
"""Загрузить существующую векторную базу данных"""
if os.path.exists(self.persist_dir):
self.vector_store = Chroma(
persist_directory=self.persist_dir,
embedding_function=self.embeddings
)
self._build_qa_chain()
print("Загружена существующая векторная база данных")
return True
else:
print("Существующая векторная база данных не найдена")
return False
def ask(self, question: str) -> dict:
"""
Задайте вопрос базе знаний
Аргументы:
question: question
Возвращает:
Словарь, содержащий ответ и ссылки на источники
"""
if not self.qa_chain:
return {"error": "Сначала загрузите документ или существующую базу данных!"}
# Создайте шаблон запроса, чтобы стимулировать ответы на китайском языке
result = self.qa_chain.invoke({
"query": f"""Пожалуйста, ответьте на следующий вопрос на китайском языке. Если ответ есть в контексте, явно укажите на это.
Если ответа нет в контексте, честно скажите "Не могу ответить на основе предоставленной информации."
Вопрос: {question}
"""
})
return {
"question": question,
"answer": result["result"],
"sources": [doc.page_content for doc in result["source_documents"]]
}
# ============================================
# Пример использования
# ============================================
if __name__ == "__main__":
# 1. Создайте экземпляр базы знаний
kb = LocalKnowledgeBase(model_name="qwen") # Используйте Qwen, лучше подходит для китайского языка
# 2. Попробуйте загрузить существующую базу данных; иначе загрузите документы
if not kb.load_existing_db():
# Подготовьте несколько документов, например, сохраните несколько ПРИМЕРНЫХ руководств в формате txt
sample_docs = [
"/Users/example/documents/example_python_tutorial.txt",
"/Users/example/documents/company_handbook.pdf",
]
kb.load_documents(sample_docs)
# 3. Интерактивные вопросы и ответы
print("=" * 50)
print("Пример локальной базы знаний запущен!")
print("Введите свой вопрос или введите 'quit' для выхода")
print("=" * 50)
while True:
user_input = input("\n"Ваш вопрос: ")
if user_input.lower() in ["quit", "exit", "Exit"]:
print("До свидания!")
break
if not user_input.strip():
continue
# Задать вопрос
result = kb.ask(user_input)
if "error" in result:
print(f"Ошибка: {result['error']}")
continue
print(f"\n"Ответ: {result['answer']}")
print("\n"Источники: ")
for i, source in enumerate(result["sources"], 1):
print(f"\n[{i}] {source[:200]}...")
Перед использованием этой системы необходимо скачать модель эмбеддингов:
Пример
ollama pull nomic-embed-text
# Скачать основную модель (если ещё не скачана)
ollama pull qwen
Таким образом, у вас есть система приватной базы знаний, работающая полностью локально.
Вы можете добавлять собственные заметки, документы и электронные книги и позволить ИИ помогать вам искать и отвечать на вопросы.
Все данные в этой системе остаются на вашей локальной машине — документы на вашем жёстком диске, векторная база данных в вашем каталоге, модели на вашем компьютере — так что вам совсем не нужно беспокоиться об утечках данных.
Советы по оптимизации производительности
Локальная модель работает, но как сделать её быстрее? Вот несколько практических советов.
Выбор правильного уровня квантования
Это самая простая и самая эффективная оптимизация — чем ниже уровень квантования, тем выше скорость.
Если Q4 работает, не используйте Q8; если Q8 работает, не используйте FP16.
Настройка размера контекстного окна
Чем больше контекстное окно, тем больше вычислений требуется.
Если вам не нужен длинный контекст, вы можете задать его в Modelfile Ollama:
Пример
# Создание нового файла Modelfile
echo "FROM llama3
PARAMETER num_ctx 2048" > Modelfile
# Создайте пользовательскую модель
ollama create llama3-fast -f Modelfile
# Запуск
ollama run llama3-fast
Уменьшение контекста с значения по умолчанию 8192 до 2048 сделает его заметно быстрее.
Использование GPU-ускорения
Если у вас есть NVIDIA GPU или Mac с Apple Silicon, убедитесь, что Ollama использует GPU, а не CPU.
Ollama автоматически обнаружит и будет использовать GPU, но иногда вам нужно это проверить.
В журналах запуска Ollama вы должны увидеть сообщения типа "Metal GPU activated" или "CUDA activated".
Использование более быстрых параметров сэмплирования
Некоторые параметры сэмплирования могут влиять на скорость:
Пример
# Файл: Modelfile.fast
echo "FROM llama3
PARAMETER temperature 0.7
PARAMETER top_k 20
PARAMETER top_p 0.9
PARAMETER num_predict 256" > Modelfile.fast
# Создать и запустить
ollama create llama3-optimized -f Modelfile.fast
ollama run llama3-optimized
Описания параметров:
| Параметр | Описание | Рекомендации по оптимизации |
|---|---|---|
| temperature | Управление случайностью | Умеренный уровень подойдёт, на скорость не влияет |
| top_k | Ограничить число слов-кандидатов | Установите меньшее значение (20-40), чтобы ускорить |
| top_p | Порог кумулятивной вероятности | Значение по умолчанию 0.9 подходит |
| num_predict | Максимальное количество генерируемых токенов | Ограничивайте по необходимости |
| num_ctx | Размер контекстного окна | Достаточно минимально необходимого; чем меньше, тем быстрее |
Отключение ненужных функций
Если вы используете вызовы API и вам не нужен потоковый вывод, можно установить stream в false.
Хотя это не ускорит инференс, это может снизить накладные расходы на передачу данных по сети.
Другие расширенияОптимизация производительности — это искусство баланса: скорость, качество и память нельзя получить одновременно. Найдите точку баланса, подходящую именно вам.