Рандомизированная быстрая сортировка
Быстрая сортировка — один из самых классических алгоритмов сортировки в информатике, известный своей средней временной сложностью O(n log n). Однако, когда входные данные уже отсортированы или почти отсортированы, традиционная быстрая сортировка деградирует до временной сложности O(n²). Рандомизированная быстрая сортировка остроумно решает эту проблему, вводя случайность.
Прежде чем погрузиться в рандомизированную быструю сортировку, давайте сначала рассмотрим основную идею традиционной быстрой сортировки.
Как работает быстрая сортировка
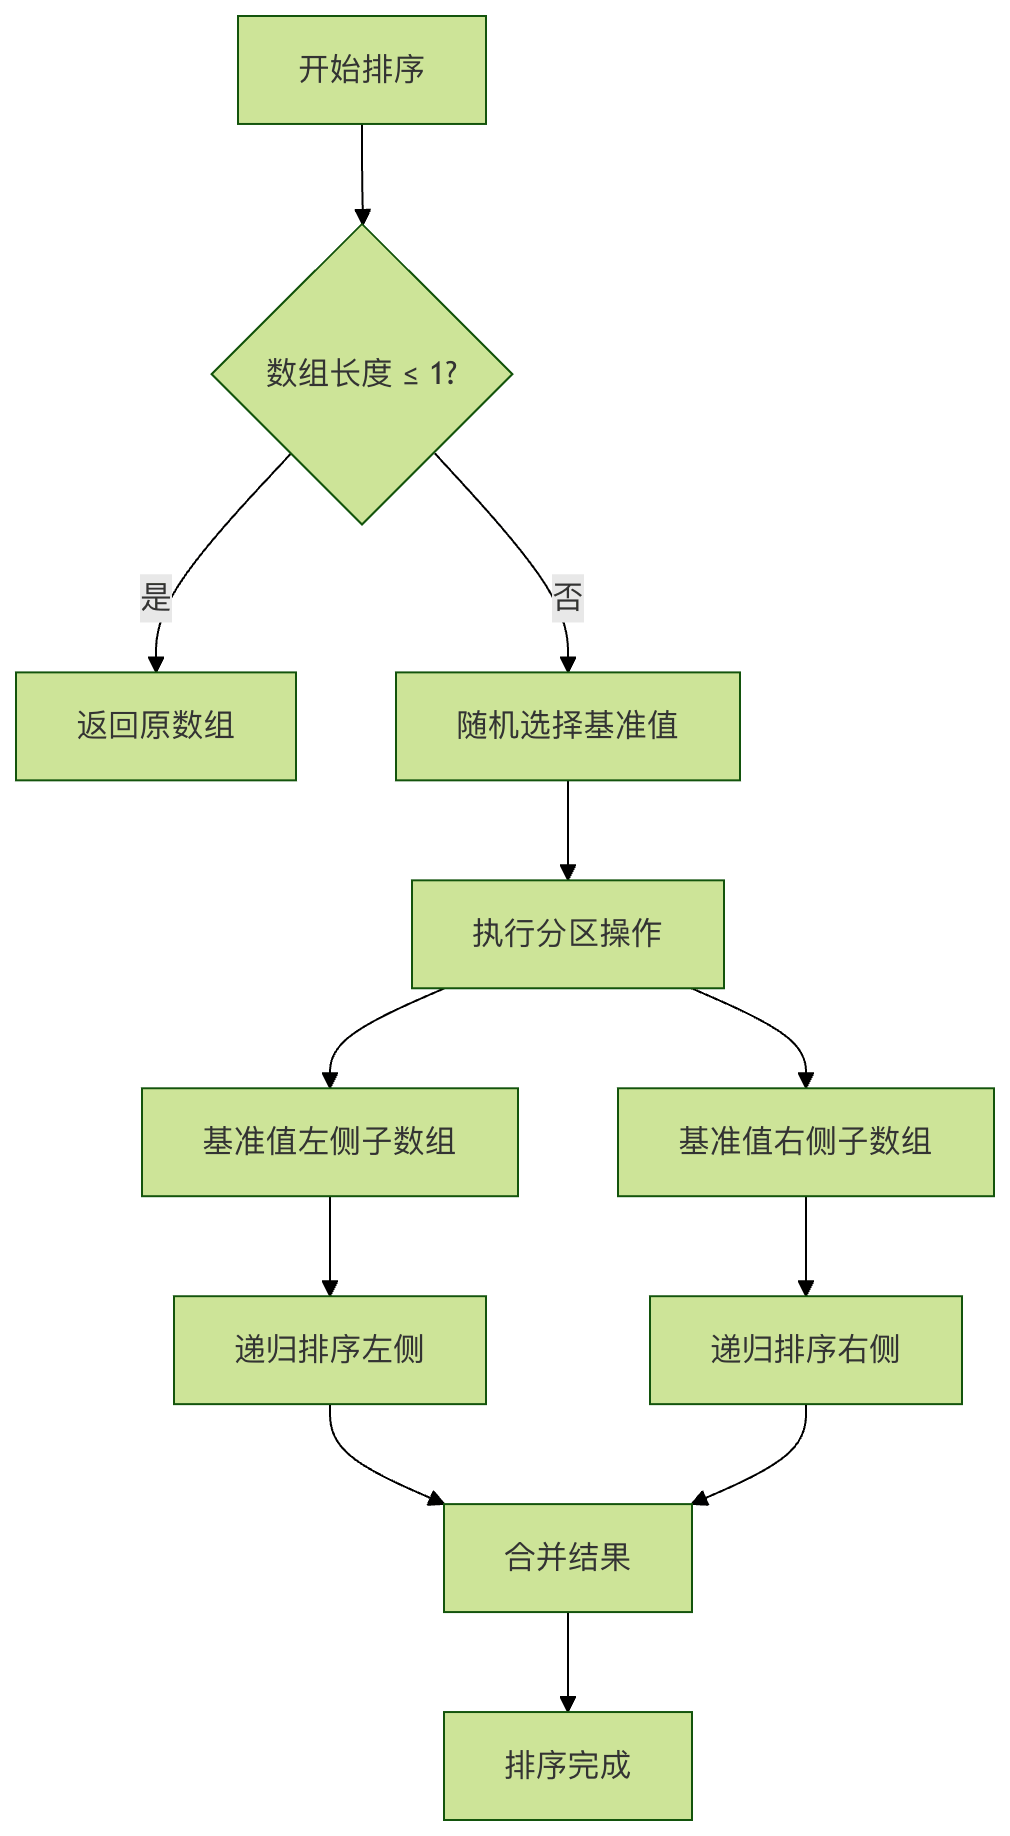
Быстрая сортировка используетстратегию «разделяй и властвуй», основные шаги следующие:
- Выбор опорного элементаВыберите элемент из массива в качестве опорного значения.
- Операция разделенияПереупорядочьте массив так, чтобы все элементы меньше опорного были размещены перед ним, а все элементы больше опорного — после него.
- Рекурсивная сортировкаРекурсивно примените тот же процесс к подмассивам по обе стороны от опорного элемента.
Проблемы традиционной быстрой сортировки
Производительность традиционной быстрой сортировки сильно зависит от выбора опорного элемента. Алгоритм наиболее эффективен, когда опорный элемент может примерно разделить массив на две равные половины каждый раз. Однако производительность значительно снижается в следующих случаях:
- Отсортированный массивЕсли массив уже отсортирован, выбор последнего элемента в качестве опорного каждый раз приводит к крайне несбалансированным разбиениям.
- Массив в обратном порядкеПохож на отсортированный массив, но в противоположном направлении.
- Дублирующиеся элементыБольшое количество дублирующихся элементов также может вызывать несбалансированные разбиения.
В этих наихудших сценариях временная сложность быстрой сортировки ухудшается до O(n²), что сравнимо с простыми алгоритмами, такими как пузырьковая сортировка.
Рандомизированная быстрая сортировка избегает наихудших сценариев, внося случайность, что гарантирует поддержание хорошей средней производительности алгоритма на различных входных данных.
Основное усовершенствование рандомизированной быстрой сортировки очень просто:Случайный выбор опорного элементаВместо того чтобы всегда выбирать первый, последний или средний элемент, в качестве опорного выбирается случайный элемент. Эта случайность делает вероятность наихудшего случая чрезвычайно низкой, тем самым обеспечивая ожидаемую временную сложность O(n log n).
Основная идея рандомизированной быстрой сортировки:За один проход сортировки сортируемые данные разделяются на две независимые части, где все данные в одной части меньше всех данных в другой части. Затем быстрая сортировка рекурсивно применяется к каждой из этих двух частей. Весь процесс сортировки может выполняться рекурсивно, превращая таким образом все данные в упорядоченную последовательность.
Преимущества алгоритма
| Особенности | Традиционная быстрая сортировка | Рандомизированная быстрая сортировка |
|---|---|---|
| Временная сложность в худшем случае | O(n²) | O(n²) (но с чрезвычайно низкой вероятностью) |
| Средняя временная сложность | O(n log n) | O(n log n) |
| Условия наихудшего случая | Определённые входные данные (например, уже отсортированные массивы) | Случайный выбор всегда попадает на экстремальное значение |
| Пространственная сложность | O(log n) (стек рекурсии) | O(log n) (стек рекурсии) |
| Стабильность | неустойчивая | неустойчивая |
Хотя теоретически временная сложность рандомизированной быстрой сортировки в наихудшем случае по-прежнему равна O(n²), на практике вероятность возникновения этого наихудшего случая чрезвычайно мала. Для массива из n элементов вероятность того, что случайный выбор опорных элементов приведёт к наихудшему случаю, составляет примерно 1/n!, что практически невозможно на практике.
Схема процесса
В массиве выберите опорный элемент, например 4 в первой позиции, затем переместите 4 на его правильную позицию так, чтобы данные в предшествующем подмассиве были меньше 4, а данные в следующем подмассиве были больше 4, после чего рекурсивно продолжайте, пока вся сортировка не завершится.
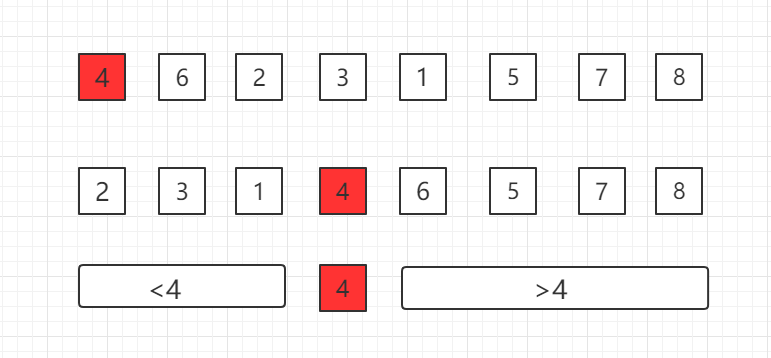
То, как переместить выбранные опорные данные на их правильную позицию, является ядром быстрой сортировки, и этот процесс мы называем разбиением.
Процесс выглядит следующим образом, гдеi— это позиция элемента, который в данный момент обходится и сравнивается:
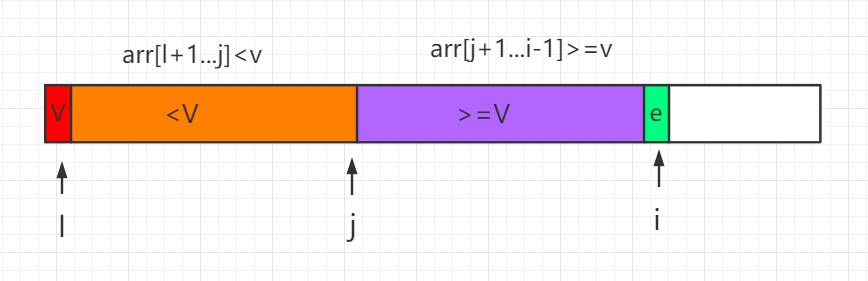
Этот процесс разбиения выражается в коде так:
Пример
private static int partition(Comparable[] arr, int l, int r){
Comparable v = arr[l];
int j = l;
for( int i = l + 1 ; i <= r ; i ++ )
if( arr[i].compareTo(v) < 0 ){
j ++;
// Обменять местами позиции элементов массива
swap(arr, j, i);
}
swap(arr, l, j);
return j;
}
...
Если быстрая сортировка применяется к почти отсортированному массиву, подмассивы после каждого разбиения оказываются крайне несбалансированными, и она легко может выродиться вO(n^2)алгоритм временной сложности. Нам нужно оптимизировать приведённый выше код, случайно выбирая опорный элемент в качестве эталона; это называется алгоритмом рандомизированной быстрой сортировки. Нужно лишь добавить следующую строку перед приведённым выше кодом, чтобы случайно выбрать элемент в массиве и поменять его местами с опорными данными.
swap( arr, l , (int)(Math.random()*(r-l+1))+l );
Пример кода на Java
Загрузка пакета исходного кода:Скачать
Код файла QuickSort.java:
/**
* Рандомизированная быстрая сортировка
*/
public class QuickSort {
// Выполнить операцию разбиения для части arr[l...r]
// Вернуть p так, чтобы arr[l...p-1] < arr[p] ; arr[p+1...r] > arr[p]
private static int partition(Comparable[] arr, int l, int r){
// Случайным образом выбрать значение в качестве опорного элемента в диапазоне arr[l...r]
swap( arr, l , (int)(Math.random()*(r-l+1))+l );
Comparable v = arr[l];
// arr[l+1...j] < v ; arr[j+1...i) > v
int j = l;
for( int i = l + 1 ; i <= r ; i ++ )
if( arr[i].compareTo(v) < 0 ){
j ++;
swap(arr, j, i);
}
swap(arr, l, j);
return j;
}
// Рекурсивно применяйте быструю сортировку для сортировки диапазона arr[l...r]
private static void sort(Comparable[] arr, int l, int r){
if (l >= r) {
return;
}
int p = partition(arr, l, r);
sort(arr, l, p-1 );
sort(arr, p+1, r);
}
public static void sort(Comparable[] arr){
int n = arr.length;
sort(arr, 0, n-1);
}
private static void swap(Object[] arr, int i, int j) {
Object t = arr[i];
arr[i] = arr[j];
arr[j] = t;
}
// Тестирование QuickSort
public static void main(String[] args) {
// Быстрая сортировка также является алгоритмом со сложностью O(n log n)
// Может легко обрабатывать данные порядка 1 миллиона за 1 секунду
int N = 1000000;
Integer[] arr = SortTestHelper.generateRandomArray(N, 0, 100000);
sort(arr);
SortTestHelper.printArray(arr);
}
}
Реализация рандомизированной быстрой сортировки
Реализация на Python
Пример
def randomized_quick_sort(arr, low=None, high=Отсутствует):
"""
Основная функция для рандомизированной быстрой сортировки
Параметры:
arr: список для сортировки
low: начальный индекс подмассива (по умолчанию 0)
high: конечный индекс подмассива (по умолчанию len(arr)-1)
Возвращает:
Отсортированный список (сортировка на месте; также возвращает отсортированный список)
"""
# Установить параметры по умолчанию
if low is None:
low = 0
if high is None:
high = len(arr) - 1
# Условие завершения рекурсии: длина подмассива меньше или равна 1
if low < high:
# Случайно выбрать опорный элемент и разделить
pivot_index = randomized_partition(arr, low, high)
# Рекурсивно отсортировать левый и правый подмассивы
randomized_quick_sort(arr, low, pivot_index - 1)
randomized_quick_sort(arr, pivot_index + 1, high)
return arr
def randomized_partition(arr, low, high):
"""
Функция рандомизированного разбиения
Параметры:
arr: список для разбиения
low: начальный индекс подмассива
high: конечный индекс подмассива
Возвращает:
Индекс конечной позиции опорного значения
"""
# Случайным образом выбрать индекс в качестве позиции опорного элемента
random_index = random.randint(low, high)
# Поменять местами случайно выбранный элемент с последним элементом
arr[random_index], arr[high] = arr[high], arr[random_index]
# Использовать последний элемент (который теперь является случайно выбранным элементом) в качестве опорного элемента
return partition(arr, low, high)
def partition(arr, low, high):
"""
Функция разделения (та же, что и в быстрой сортировке)
Параметры:
arr: список для разбиения
low: начальный индекс подмассива
high: конечный индекс подмассива
Возвращает:
Индекс конечной позиции опорного значения
"""
pivot = arr[high] # Опорный элемент
i = low - 1 # Граница области элементов, меньших опорного
for j in range(low, high):
if arr[j] <= pivot:
i += 1
# Поменять элементы местами
arr[i], arr[j] = arr[j], arr[i]
# Поместить опорный элемент в правильную позицию
arr[i + 1], arr[high] = arr[high], arr[i + 1]
return i + 1
# Тестовые данные
test_data = [3, 6, 8, 10, 1, 2, 1]
print("Исходный массив:", test_data)
print("Отсортированный массив:", randomized_quick_sort(test_data.copy()))
Анализ временной сложности
Временная сложность рандомизированной быстрой сортировки может быть выражена следующей формулой:
\[ T(n) = O(n) + T(k) + T(n - k - 1) \]
Где:
- \( O(n) \) — это время выполнения операции разделения.
- \( T(k) \) — это время сортировки левого подмассива.
- \( T(n - k - 1) \) — это время сортировки правого подмассива.
- \( k \) — количество элементов слева от опорного значения.
В рандомизированной версии ожидаемое значение \( k \) равно \( n/2 \), поэтому ожидаемая временная сложность равна:
\[ E[T(n)] = O(n \log n) \]
Варианты и оптимизации рандомизированной быстрой сортировки
1. Трёхпутевая быстрая сортировка
Когда массив содержит много повторяющихся элементов, традиционная двухпутевая быстрая сортировка неэффективна. Трёхпутевая быстрая сортировка делит массив на три части: меньше опорного элемента, равные опорному элементу и больше опорного элемента.
Пример
"""Трёхпутевая рандомизированная быстрая сортировка"""
if low is None:
low = 0
if high is None:
high = len(arr) - 1
if low < high:
# Случайно выбрать опорный элемент
random_index = random.randint(low, high)
arr[random_index], arr[low] = arr[low], arr[random_index]
pivot = arr[low]
# Трёхстороннее разбиение
lt = low # Граница области для значений меньше опорного элемента
gt = high # Граница области для значений больше опорного элемента
i = low + 1 # Текущий проверяемый элемент
while i <= gt:
if arr[i] < pivot:
arr[lt], arr[i] = arr[i], arr[lt]
lt += 1
i += 1
elif arr[i] > pivot:
arr[i], arr[gt] = arr[gt], arr[i]
gt -= 1
else:
i += 1
# Рекурсивно отсортировать части, которые меньше и больше опорного элемента
randomized_three_way_quick_sort(arr, low, lt - 1)
randomized_three_way_quick_sort(arr, gt + 1, high)
return arr
# Проверка на данных, содержащих дублирующиеся элементы
test_data_with_duplicates = [3, 6, 3, 8, 1, 3, 6, 1]
print("Исходный массив (с дубликатами):", test_data_with_duplicates)
print("После трёхсторонней быстрой сортировки:", randomized_three_way_quick_sort(test_data_with_duplicates.copy()))
2. Оптимизация для небольших массивов
Для очень маленьких массивов (обычно менее 10-20 элементов) сортировка вставками может быть эффективнее быстрой сортировки. Мы можем объединить преимущества обоих алгоритмов:
Пример
"""Оптимизированная рандомизированная быстрая сортировка: использовать сортировку вставками для небольших массивов"""
if low is None:
low = 0
if high is None:
high = len(arr) - 1
# Использовать сортировку вставками для небольших массивов
if high - low + 1 <= threshold:
insertion_sort(arr, low, high)
return arr
if low < high:
pivot_index = randomized_partition(arr, low, high)
optimized_randomized_quick_sort(arr, low, pivot_index - 1, threshold)
optimized_randomized_quick_sort(arr, pivot_index + 1, high, threshold)
return arr
def insertion_sort(arr, low, high):
"""Сортировка вставками, используется для сортировки небольших массивов"""
for i in range(low + 1, high + 1):
key = arr[i]
j = i - 1
while j >= low and arr[j] > key:
arr[j + 1] = arr[j]
j -= 1
arr[j + 1] = key
# Проверка оптимизации для малых массивов
small_test_data = [9, 3, 7, 1, 5, 2, 8, 4, 6]
print("Исходный небольшой массив:", small_test_data)
print("После оптимизированной сортировки:", optimized_randomized_quick_sort(small_test_data.copy(), threshold=5))
Сравнение производительности и практические рекомендации
Тест производительности
Давайте сравним производительность различных алгоритмов сортировки с помощью практических тестов.
Пример
import random as rand
def performance_test():
"""Тест производительности: сравнение времени выполнения различных алгоритмов сортировки"""
algorithms = {
"Рандомизированная быстрая сортировка": randomized_quick_sort,
"Трёхпутевая быстрая сортировка": randomized_three_way_quick_sort,
"Оптимизированная быстрая сортировка": optimized_randomized_quick_sort,
}
# Генерация тестовых данных
test_sizes = [100, 1000, 10000]
for size in test_sizes:
print(f"\nРазмер тестового массива: {size}")
# Генерация различных типов тестовых данных
test_cases = {
"Случайные данные": [rand.randint(0, 10000) for _ in range(size)],
"Отсортированные данные: list(range(size)),
"Reversed data": list(range(size, 0, -1)),
Большое количество дублирующихся данных: [rand.randint(0, 10) for _ in range(size)],
}
for case_name, test_data in test_cases.items():
print(f" {case_name}:")
for algo_name, algo_func in algorithms.items():
data_copy = test_data.copy()
start_time = time.time()
algo_func(data_copy)
end_time = time.time()
execution_time = (end_time - start_time) * 1000 # Преобразовать в миллисекунды
print(f" {algo_name}: {execution_time:.2f} ms")
# Запустить тест производительности (примечание: это может занять некоторое время для больших массивов)
# performance_test()