Union-Find-Pfadkompression
In der find-Funktion der Disjoint-Set-Union kann eine Pfadkompression durchgeführt werden, um den Wurzelknoten eines Knotens schneller zu finden. Bei einem Mengenbaum können viele Knoten unter seinem Wurzelknoten hängen. Daher können wir während des find-Prozesses versuchen, den Knoten so weit wie möglich von unten nach oben zu bewegen, wenn der aktuell besuchte Knoten nicht der Wurzelknoten ist, wodurch die Tiefe des Baums verringert wird. Dieser Prozess wird Pfadkompression genannt.
Wie in der folgenden Abbildung gezeigt, kann der Prozess von find(4) die Pfadkompression nutzen, um die Anzahl der Ebenen im Baum zu reduzieren.
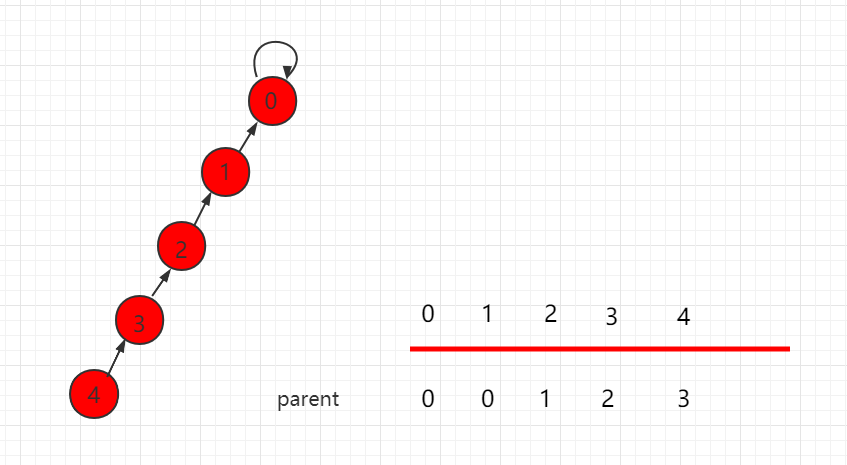
Wenn Knoten 4 nach oben zum Wurzelknoten sucht, reduziert der erste Kompressionsschritt die Anzahl der Ebenen des Baums um eins:
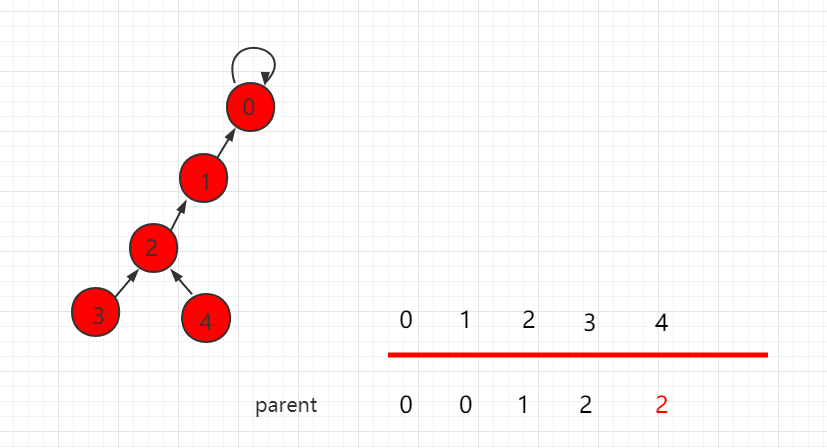
Knoten 2 sucht ebenfalls nach oben und ist nicht der Wurzelknoten, daher wird Element 2 auf den Elternknoten seines ursprünglichen Elternknotens verwiesen. Nach dieser Operation wird die Anzahl der Ebenen des Baums entsprechend um eins reduziert und Wurzelknoten 0 zurückgegeben.

Ändern Sie den find-Prozess-Code wie folgt:
// O(h)-Komplexität, h ist die Höhe des Baums
private int find(int p){
assert( p >= 0 && p < count );
// Pfadkomprimierung 1
while( p != parent[p] ){
parent[p] = parent[parent[p]];
p = parent[p];
}
return p;
}
Die oben beschriebene Pfadkomprimierung ist nicht der optimale Ansatz. Wir können den ursprünglichen Baum in die in der folgenden Abbildung gezeigte Form komprimieren, die die minimale Anzahl von Ebenen aufweist.

Dieser find-Prozess kann wie folgt dargestellt werden:
// find-Prozess, finde die Mengennummer, die dem Element p entspricht
// O(h)-Komplexität, h ist die Höhe des Baums
private int find(int p) {
assert (p >= 0 && p < count);
// Zweiter Pfadkomprimierungsalgorithmus
if (p != parent[p])
parent[p] = find(parent[p]);
return parent[p];
}
...
Java-Beispielcode
Quellcode-Paket-Download:Herunterladen
Code der Datei UnionFind3.java:
/**
* Rangbasierte Optimierung
*/
public class UnionFind4 {
private int[] rank; // rank[i] steht für die Anzahl der Ebenen des Baums, der durch die bei i verwurzelte Menge dargestellt wird
private int[] parent; // parent[i] steht für den Elternknoten, auf den das i-te Element zeigt
private int count; // Anzahl der Datenelemente
// Konstruktor
public UnionFind4(int count){
rank = new int[count];
parent = new int[count];
this.count = count;
// Initialisierung: Jedes parent[i] zeigt auf sich selbst, was bedeutet, dass jedes Element eine eigene Menge bildet
for( int i = 0 ; i < count ; i ++ ){
parent[i] = i;
rank[i] = 1;
}
}
// find-Prozess, finde die Mengennummer, die dem Element p entspricht
// O(h)-Komplexität, h ist die Höhe des Baums
private int find(int p){
assert( p >= 0 && p < count );
// den Elternknoten weiter abfragen, bis der Wurzelknoten erreicht ist
// Eigenschaft des Wurzelknotens: parent[p] == p
while( p != parent[p] )
p = parent[p];
return p;
// Zweiter Pfadkomprimierungsalgorithmus
//if( p != parent[p] )
//parent[p] = find( parent[p] );
//return parent[p];
}
// prüfen, ob Element p und Element q zu derselben Menge gehören
// O(h)-Komplexität, h ist die Höhe des Baums
public boolean isConnected( int p , int q ){
return find(p) == find(q);
}
// die Mengen, die Element p und Element q enthalten, zusammenführen
// O(h)-Komplexität, h ist die Höhe des Baums
public void unionElements(int p, int q){
int pRoot = find(p);
int qRoot = find(q);
if( pRoot == qRoot )
return;
if( rank[pRoot] < rank[qRoot] ){
parent[pRoot] = qRoot;
}
else if( rank[qRoot] < rank[pRoot]){
parent[qRoot] = pRoot;
}
else{ // rank[pRoot] == rank[qRoot]
parent[pRoot] = qRoot;
rank[qRoot] += 1; // den Rangwert beibehalten
}
}
}