Hash-Tabelle
Eine Hash-Tabelle, auch Hash-Map genannt, ist eine äußerst effiziente Datenstruktur.
Hash-Tabellen können im Durchschnitt mit nahezuO(1)Die Zeitkomplexität für das Einfügen, Löschen und Suchen von Daten ist viel besser als das Durchlaufen eines Arrays (O(n)) und die Suche in einem binären Suchbaum (O(log n)) ist viel schneller.
| Aktion | Array/verkettete Liste | Hash-Tabelle |
|---|---|---|
| Suche | O(n) | O(1) |
| Einfügen | O(n) | O(1) |
| Delete | O(n) | O(1) |
| Speichereffizienz | Hoch | Mittel |
Hash-TabelleGenau wie ein intelligentes Schließfachsystem:
- Traditionelles Schließfach: Sie müssen sich merken, in welchem Schrank sich jeder Gegenstand befindet (lineare Suche)
- Intelligentes Schließfach: Du nennst dem Administrator den Gegenstandsnamen, und er nennt dir direkt die Schranknummer (Hash-Lookup)
Kernidee:
Durchdie Hash-Funktionwirdder Schlüsselin einenArray-Index umgewandelt, was schnellen Zugriff ermöglicht.
Praxisbeispiel:
- Wörterbuchsuche: Anhand des Anfangsbuchstabens des Wortes schnell die Seite finden
- Telefonbuch: Nach Nachnamen-Pinyin sortieren, um Kontakte schnell zu finden
- Bibliothekssignatur: Anhand der Klassifikationsnummer direkt den Regalstandort finden
Stell dir vor, du hast eine riesige Bibliothek mit Tausenden von Büchern.
Wenn du ein bestimmtes Buch finden möchtest, zum Beispiel Harry Potter, was würdest du tun? Die dümmste Methode ist, beim ersten Buch im ersten Regal anzufangen und eins nach dem anderen zu suchen, bis du es findest – das könnte Stunden oder sogar Tage dauern!
Was würde ein kluger Bibliothekar tun? Er würde einIndexsystemverwenden: Basierend auf einer Regel des Buchtitels oder Autorennamens (z. B. dem ersten Buchstaben) schnell den groben Bereich finden, in dem sich das Buch befindet, und dann nur in diesem kleinen Bereich suchen. Die Idee dieses Indexsystems istHash-Tabelleder Kern davon.
Grundlegende Konzepte
Was ist eine Hash-Tabelle?
Eine Hash-Tabelle ist eine Datenstruktur, die direkt über Schlüssel auf Werte zugreift., sie verwendet etwas, das alsHash-Funktionbezeichnet wird – die Zauberformel, die einen Schlüssel beliebiger Größe (z. B. eine Zeichenkette, eine Zahl oder ein Objekt) in eine Zahl fester Größe umwandelt, die als Hash-Wert bezeichnet wird.Hash-WertoderHash-CodeVerwenden Sie dann diesen Hashwert als denIndexdes Arrays und speichern Sie den Wert an der diesem Index entsprechenden Position im Array.
Dieser Prozess ist wie das Zuweisen einer eindeutigen Sitzplatznummer (Hashwert) zu jedem Schlüssel und ihm dann zu sagen: Deine Daten sind an dem Sitzplatz mit dieser Nummer abgelegt. Wenn Sie diese Daten finden möchten, berechnen Sie einfach die Sitzplatznummer mit derselben Regel neu und gehen direkt dorthin – ohne Sitz für Sitz nachsehen zu müssen.
Kernkomponenten
Eine Hash-Tabelle besteht hauptsächlich aus den folgenden drei Kernbestandteilen:
- Schlüssel: Der Bezeichner, den Sie beim Speichern und Nachschlagen von Daten verwenden. In einem Telefonbuch ist beispielsweise der Name der Person der Schlüssel.
- Wert: die tatsächlichen Daten, die mit dem Schlüssel verknüpft sind. In einem Telefonbuch ist die Telefonnummer der Wert.
- Hash-Funktion (Hash Function): Die mathematische Funktion, die Schlüssel auf Array-Indizes abbildet. Sie ist das Herzstück der Hash-Tabelle.
Diagramm der Funktionsweise
Verwenden wir ein einfaches Beispiel. Angenommen, wir möchten ein Telefonbuch erstellen, das Namen auf Telefonnummern abbildet.
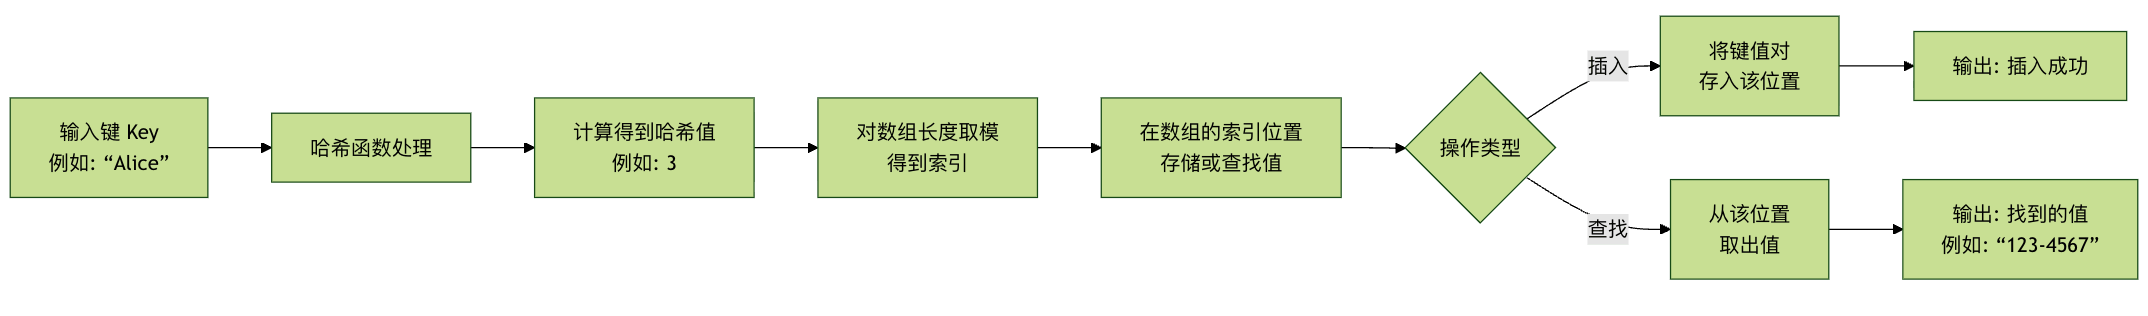
Die obige Abbildung zeigt deutlich den Arbeitsablauf einer Hash-Tabelle: Ob beim Einfügen oder Nachschlagen, es beginnt immer mit einem Schlüssel, berechnet den Index durch die Hash-Funktion und arbeitet dann direkt an dieser Position im Array, was einen schnellen Zugriff ermöglicht.
Entwurf der Hash-Funktion
Eigenschaften einer guten Hash-Funktion
| Funktionen | Beschreibung | Bedeutung |
|---|---|---|
| Determinismus | Dieselbe Eingabe erzeugt immer dieselbe Ausgabe | ⭐⭐⭐⭐⭐ |
| Gleichmäßige Verteilung | Die Ausgabe ist gleichmäßig innerhalb des Bereichs der Hash-Tabelle verteilt | ⭐⭐⭐⭐⭐ |
| Effiziente Berechnung | Der Berechnungsprozess ist einfach und schnell | ⭐⭐⭐⭐ |
| Lawineneffekt | Eine winzige Änderung der Eingabe verursacht eine enorme Änderung der Ausgabe | ⭐⭐⭐ |
Gängige Hash-Funktionen
| Type | Beispiel | Anwendbare Szenarien |
|---|---|---|
| Divisions-Rest-Methode | hash = key % table_size |
Ganzzahliger Schlüssel |
| Multiplikationsmethode | hash = floor(key * A % 1 * table_size) |
Gleitkommaschlüssel |
| Ziffernanalysemethode | Verteilungsmuster von Zahlen analysieren | Daten mit bestimmten Mustern |
| Mid-Square-Methode | hash = (key * key) // 10^(n/2) % table_size |
Numerischer Schlüssel |
| String-Hashing | Zeichenweise Verarbeitung | String-Schlüssel |
Kollisionsauflösungsmethoden
Separate Verkettung
| Funktionen | Beschreibung | Zeitkomplexität |
|---|---|---|
| Prinzip | Jeder Hash-Bucket unterhält eine verkettete Liste | |
| Einfügen | Am Kopf der entsprechenden verketteten Liste einfügen | O(1) |
| Suche | In der entsprechenden verketteten Liste suchen | O(k), wobei k die Länge der verketteten Liste ist |
| Delete | Aus der entsprechenden verketteten Liste löschen | O(k) |
| Speicher-Overhead | Erfordert zusätzlichen Zeigerspeicher | Relativ groß |
Offene Adressierung (Open Addressing)
| Type | Sondierungssequenz | Vorteile | Nachteile |
|---|---|---|---|
| Lineares Sondieren | h, h+1, h+2, ... |
Einfach und leicht zu implementieren | Anfällig für Clustering |
| Quadratisches Sondieren | h, h+1², h+2², ... |
Clustering reduzieren | Möglicherweise können nicht alle Positionen sondiert werden |
| Doppeltes Hashing | h, h+hash2(key), h+2*hash2(key), ... |
Gleichmäßige Verteilung | Rechenintensiv |
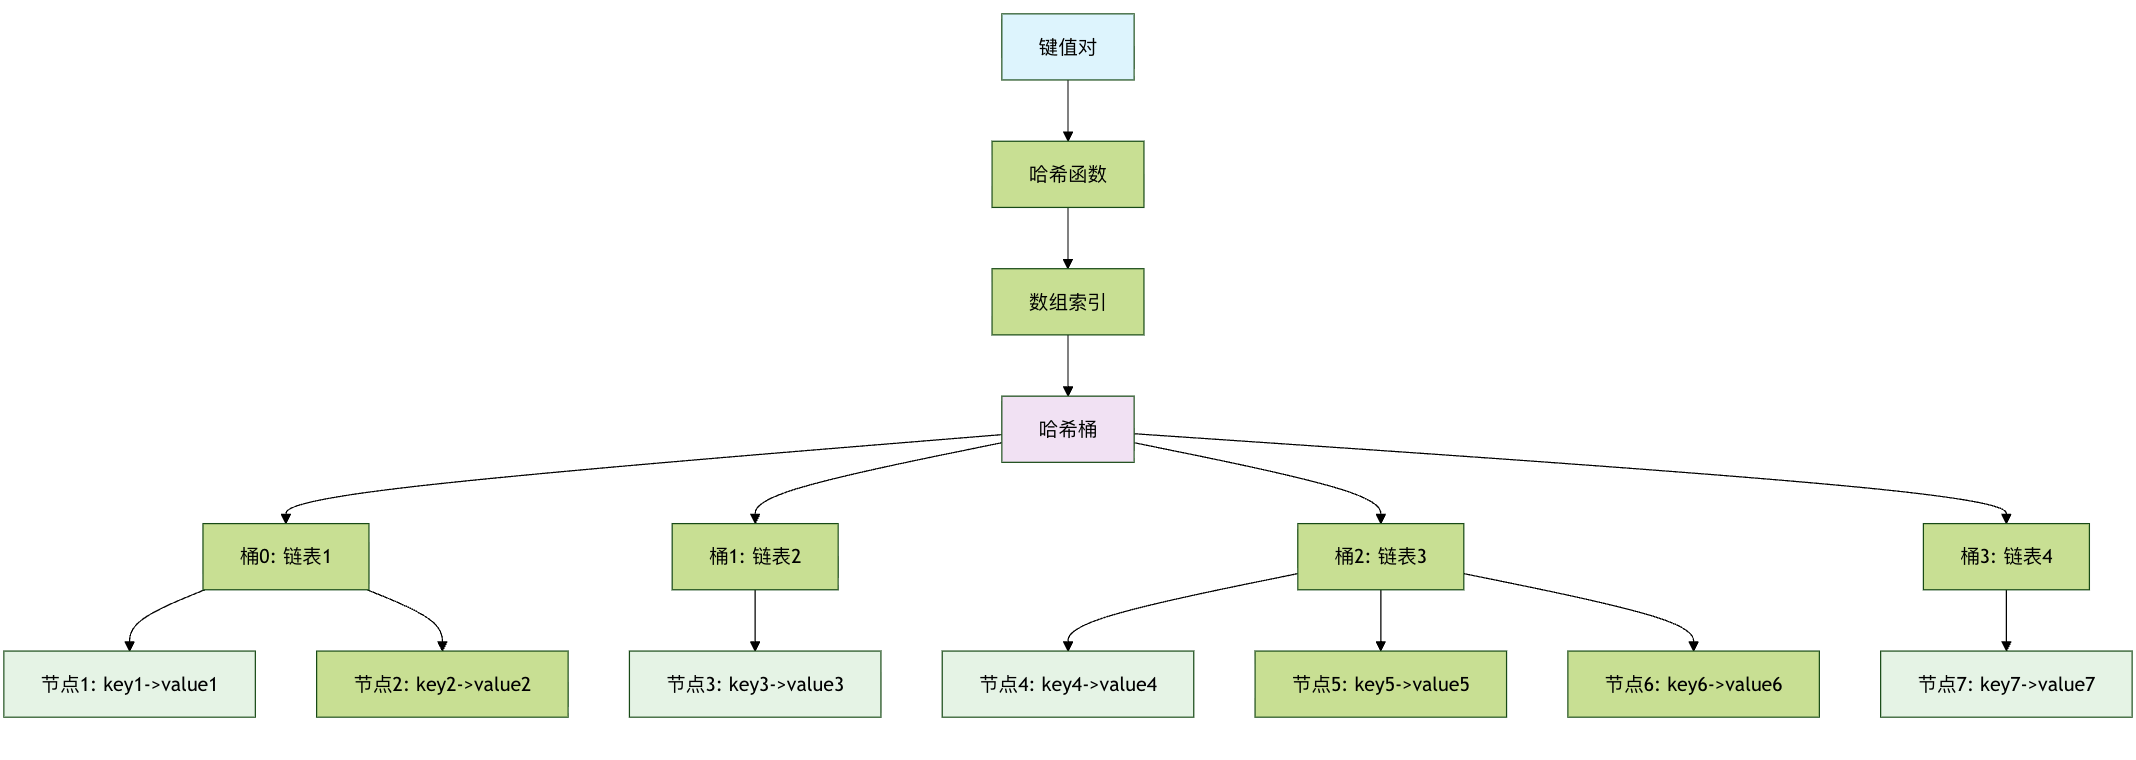
Strukturdiagramm einer Hashtabelle
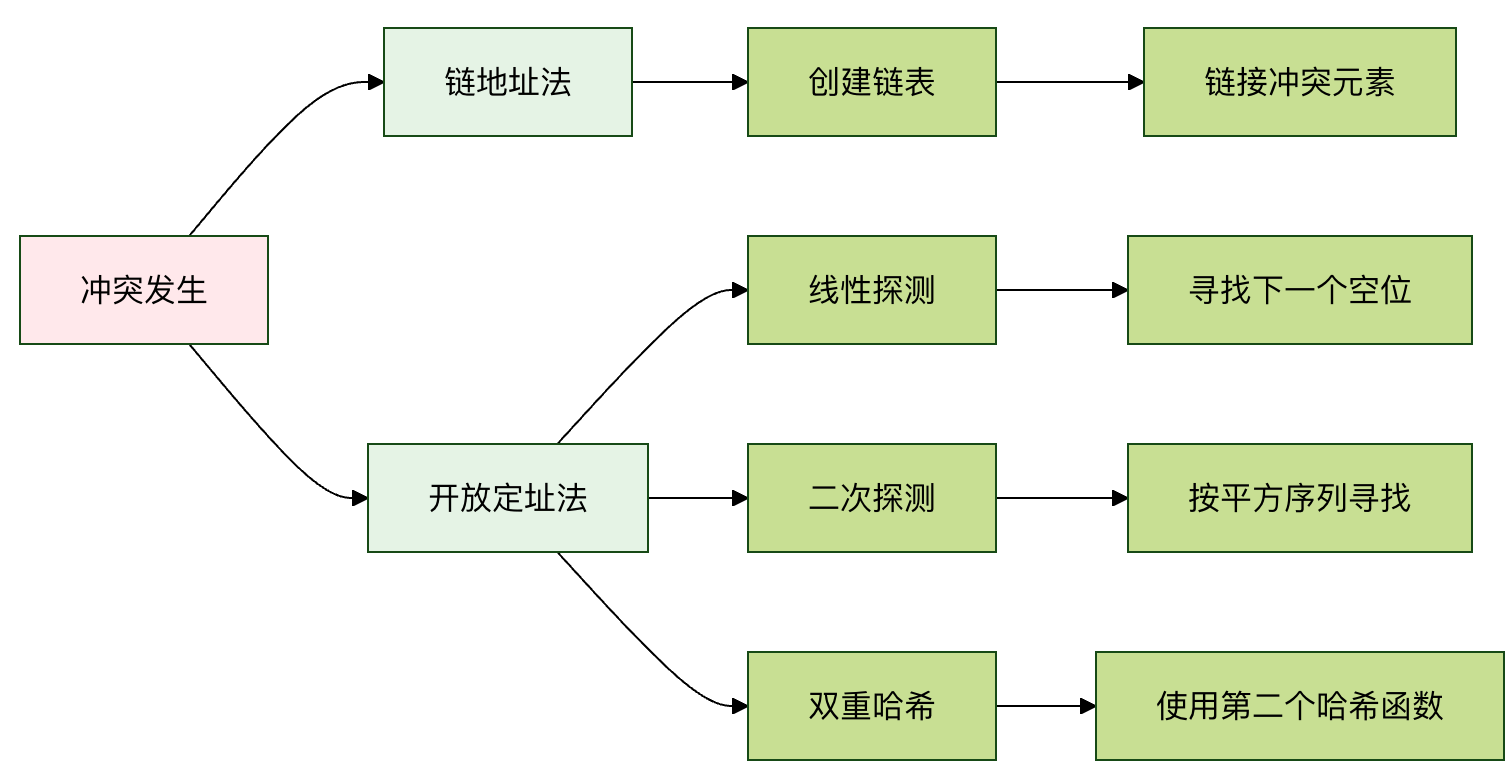
Vergleich der Methoden zur Kollisionsauflösung
Tiefergehendes Verständnis von Hashfunktionen
Die Hashfunktion ist der Schlüssel zur Effizienz von Hashtabellen. Eine gute Hashfunktion sollte die folgenden Eigenschaften haben:
- Determinismus: Derselbe Schlüssel muss immer denselben Hashwert erzeugen.
- Effizienz: Die Berechnungsgeschwindigkeit muss schnell sein.
- Gleichmäßige Verteilung: Sie kann verschiedene Schlüssel so gleichmäßig wie möglich über den gesamten Array-Bereich verteilen und dadurch Kollisionen reduzieren.
Ein Beispiel für eine einfache Hashfunktion
Angenommen, unsere Schlüssel sind Strings und die Array-Länge beträgt 10. Eine einfache Hashfunktion könnte darin bestehen, die ASCII-Codes jedes Zeichens im String zu addieren und dann den Rest modulo der Array-Länge zu nehmen.
Beispiel
"""
Eine einfache String-Hash-Funktion.
:param key: Der Eingabeschlüssel (String)
:param array_size: Die Größe des Hash-Tabellen-Arrays
:return: Der berechnete Array-Index
"""
total = 0
for char in key:
# Das Zeichen in seinen ASCII-Code-Wert umwandeln und akkumulieren
total += ord(char)
# Modulo der Array-Größe nehmen, um sicherzustellen, dass der Index innerhalb des Array-Bereichs liegt
return total % array_size
# Unsere Hash-Funktion testen
keys_to_test = ["Alice", "Bob", "Charlie", "David"]
array_size = 10
print("Testergebnisse der einfachen Hash-Funktion:")
for key in keys_to_test:
hash_index = simple_hash(key, array_size)
print(fSchlüssel '{key}' -> Hash-Index: {hash_index})
Ausgabeergebnis:
简单哈希函数测试结果:
  键 'Alice' -> 哈希索引: 0
  键 'Bob' -> 哈希索引: 8
  键 'Charlie' -> 哈希索引: 5
  键 'David' -> 哈希索引: 3
Diese Funktion ist einfach, aber möglicherweise nicht die beste, weil verschiedene Zeichenketten dieselbe Summe erzeugen können (z. B. ab und ba), was zuHash-Kollision führt。
Hash-Konflikte und Lösungsmethoden
Hash-Kollisionen. Eine Kollision bedeutet, dass zwei oder mehr verschiedene Schlüssel nach Verarbeitung durch die Hash-Funktion denselben Array-Index erzeugen. Es ist, als ob zwei Kinobesuchern dieselbe Sitzplatznummer zugewiesen wird, was eindeutig ein Problem ist. Kollisionen sind unvermeidlich, weil der Bereich der Hash-Werte (Array-Größe) normalerweise endlich ist, während die möglichen Schlüssel unendlich sind.
Es gibt zwei klassische Hauptmethoden, um Konflikte aufzulösen:
Methode 1: Verkettungsmethode
Dies ist die gebräuchlichste Methode. Sie platziert Daten nicht direkt in jeder Array-Position; stattdessen speichert sie eineverkettete Listeverkettete Liste (oder eine andere Datenstruktur, z. B. einen Rot-Schwarz-Baum) an jeder Array-Position. Wenn eine Kollision auftritt, wird das neue Schlüssel-Wert-Paar an die verkettete Liste an dieser Position angehängt.
Prozessbeschreibung:
Berechne den Hashwert des Schlüssels und finde den Array-Index.
Wenn die verkettete Liste nicht leer ist (eine Kollision auftritt), durchlaufe die verkettete Liste.
- Wenn derselbe Schlüssel gefunden wird, aktualisiere seinen Wert (oder behandle ihn nach Bedarf).
- Wenn derselbe Schlüssel nicht gefunden wird, füge das neue Schlüssel-Wert-Paar am Ende der verketteten Liste hinzu.
Beispiel
"""Eine Hash-Tabellen-Implementierung, die Verkettung verwendet, um Kollisionen aufzulösen."""
def __init__(self, size=10):
"""Initialisiere die Hash-Tabelle.
:param size: Anfangsgröße des zugrunde liegenden Arrays
"""
self.size = size
# Erstelle eine Liste der Größe `size`, wobei jedes Element mit einer leeren Liste initialisiert wird (die eine verkettete Liste darstellt)
self.table = [[] for _ in range(size)]
def _hash(self, key):
"""Interne Hash-Funktion. Hier verwenden wir die in Python eingebaute Hash-Funktion und bilden den Modulo."""
return hash(key) % self.size
def insert(self, key, value):
"""Fügt ein Schlüssel-Wert-Paar in die Hash-Tabelle ein."""
index = self._hash(key)
bucket = self.table[index] # Hole den 'Bucket' (verkettete Liste), der diesem Index entspricht
# Durchlaufe den Bucket und prüfe, ob der Schlüssel bereits existiert
for i, (k, v) in enumerate(bucket):
if k == key:
# Schlüssel existiert bereits, aktualisiere den Wert
bucket[i] = (key, value)
return
# Schlüssel existiert nicht, füge ihn am Ende der verketteten Liste hinzu
bucket.append((key, value))
def get(self, key):
"""Ruft den Wert anhand des Schlüssels ab. Wenn der Schlüssel nicht existiert, wird None zurückgegeben."""
index = self._hash(key)
bucket = self.table[index]
for k, v in bucket:
if k == key:
return v
return None # Schlüssel existiert nicht
def delete(self, key):
"""Löscht das Schlüssel-Wert-Paar anhand des Schlüssels."""
index = self._hash(key)
bucket = self.table[index]
for i, (k, v) in enumerate(bucket):
if k == key:
del bucket[i] # Lösche diesen Knoten aus der verketteten Liste
return True # Löschen erfolgreich
return False # Schlüssel existiert nicht, Löschen fehlgeschlagen
def display(self):
"""Alle Inhalte der Hash-Tabelle ausgeben."""
for i, bucket in enumerate(self.table):
print(fIndex {i}: {bucket})
# Verwendungsbeispiel
print("\n--- Beispiel für eine Hash-Tabelle mit Verkettung ---)
phone_book = HashTableChaining(5)
phone_book.insert("Alice", "123-4567")
phone_book.insert("Bob", "987-6543")
phone_book.insert("Charlie", "555-1234")
# Angenommen, der Hashwert von "David" kollidiert mit "Alice" (zur Veranschaulichung)
phone_book.insert("David", "111-2222")
print("Hash-Tabelle nach dem Einfügen von Daten:")
phone_book.display()
print(f"\nTelefonnummer von 'Bob' nachschlagen: {phone_book.get('Bob')}")
print(f"Nicht existierende 'Eve' nachschlagen: {phone_book.get('Eve')}")
phone_book.delete("Charlie")
print("\nHashtabelle nach dem Löschen von 'Charlie':")
phone_book.display()
Ausgabeergebnis:
--- 链地址法哈希表示例 ---
插入数据后的哈希表:
索引 0: [('David', '111-2222')]
索引 1: []
索引 2: [('Alice', '123-4567')]
索引 3: [('Charlie', '555-1234')]
索引 4: [('Bob', '987-6543')]

查找 'Bob' 的电话: 987-6543
查找不存在的 'Eve': None

删除 'Charlie' 后的哈希表:
索引 0: [('David', '111-2222')]
索引 1: []
索引 2: [('Alice', '123-4567')]
索引 3: []
索引 4: [('Bob', '987-6543')]
Hinweis: Um Kollisionen deutlich zu demonstrieren, ist die Arraygröße im Beispiel auf 5 gesetzt, und wir verwenden
hash(key), tatsächliche Kollisionen sind möglicherweise nicht offensichtlich. Insimple_hashUnter der Funktion,"Alice"und"David"Schlüssel, die denselben Index erzeugen können und somit zeigen, wie die Verkettungsmethode mehrere Einträge unter einem Index speichert.
Methode 2: Offene Adressierung
Diese Methode speichert alle Elemente direkt im Array selbst. Wenn eine Kollision auftritt, sucht sie gemäß einer Sondierungssequenz nach der nächsten freien Position im Array.
Übliche Sondierungsmethoden:
- Lineares Sondieren: Wenn Position
ibelegt ist, dann versuchei+1,i+2,i+3... bis ein leerer Slot gefunden wird. - Quadratisches Sondieren: Wenn Position
ibelegt ist, dann versuchei+1^2,i+2^2,i+3^2...。 - Doppeltes Hashing: Verwende eine zweite Hashfunktion, um die Schrittweite für das Sondieren zu berechnen.
Hier implementieren wir ein einfaches lineares Sondieren:
Beispiel
"""Hash-Tabellen-Implementierung mit linearem Sondieren (offene Adressierung) zur Auflösung von Kollisionen."""
def __init__(self, size=10):
self.size = size
# Verwende einen speziellen Marker `None`, um leere Slots darzustellen, und einen Marker (wie `'DELETED'`), um gelöschte Positionen darzustellen.
# Der Einfachheit halber wird nur `None` für leere Slots verwendet; die Suche stoppt, wenn sie auf `None` trifft.
self.keys = [None] * size
self.values = [None] * size
def _hash(self, key):
return hash(key) % self.size
def insert(self, key, value):
index = self._hash(key)
original_index = index
# Verwende lineare Sondierung, um einen leeren Slot oder denselben Schlüssel zu finden
while self.keys[index] is not Keine:
if self.keys[index] == key:
# Schlüssel existiert bereits, aktualisiere den Wert
self.values[index] = value
return
index = (index + 1) % self.size # Zur nächsten Position wechseln (zirkuläres Array)
if index == original_index:
# Ein voller Kreis wurde durchlaufen; die Tabelle ist voll (in der Praxis sollte die Größe geändert werden)
raise Exception("Hash-Tabelle ist voll")
# Leeren Slot gefunden, einfügen
self.keys[index] = key
self.values[index] = value
def get(self, key):
index = self._hash(key)
original_index = index
while self.keys[index] is not Keine:
if self.keys[index] == key:
return self.values[index]
index = (index + 1) % self.size
if index == original_index:
break # Einen vollen Kreis durchlaufen, ohne es zu finden
return None
def display(self):
for i in range(self.size):
if self.keys[i] is not Keine:
print(f"Index {i}: Schlüssel={self.keys[i]}, Wert={self.values[i]}")
else:
print(fIndex {i}: leer)
# Verwendungsbeispiel
print("\n--- Beispiel für lineares Sondieren einer Hash-Tabelle ---)
ht_linear = HashTableLinearProbing(7) # Kleine Größe macht Sondierung leicht sichtbar
ht_linear.insert("Apple", 10)
ht_linear.insert("Banana", 20)
ht_linear.insert("Cherry", 30)
# Angenommen, 'Date' und 'Apple' kollidieren im Hash
ht_linear.insert("Date", 40)
print("Hash-Tabelle nach dem Einfügen von Daten:")
ht_linear.display()
print(f"\nSuche nach 'Banana': {ht_linear.get('Banana')})
print(fSuche nach 'Date' (nach Kollision eingefügt): {ht_linear.get('Date')})
Ausgabeergebnis:
--- 线性探测哈希表示例 ---
插入数据后的哈希表:
索引 0: 键=Apple, 值=10
索引 1: 键=Date, 值=40
索引 2: 键=Banana, 值=20
索引 3: 键=Cherry, 值=30
索引 4: 空
索引 5: 空
索引 6: 空

查找 'Banana': 20
查找 'Date' (冲突后插入的): 40
Hinweis: Bei offener Adressierung ist das Löschen knifflig: Man kann die Position nicht einfach auf
Noneleer (null) setzen; andernfalls würde die Sondierungssequenz unterbrochen. Normalerweise wird ein spezieller "deleted"-Marker verwendet. Der Einfachheit halber implementiert dieses Beispiel das Löschen nicht.
Vergleich der beiden Methoden
| Funktionen | Separate Verkettung | Offene Adressierung |
|---|---|---|
| Implementierungsschwierigkeit | Relativ einfach | Relativ komplex, insbesondere Löschoperationen |
| Speicher-Overhead | Erfordert zusätzlichen Speicherplatz zum Speichern von Zeigern (verkettete Liste) | Alle Daten befinden sich im Array, daher kann die Speicherplatzausnutzung höher sein |
| Auswirkung von Kollisionen | Kollisionen beeinflussen nur die Leistung desselben Buckets (verkettete Liste) | Kollisionen beeinflussen die Positionen nachfolgender Einfügungen und können zu "Clusterbildung" führen |
| Zeitpunkt der Größenänderung | Vergrößern, wenn die durchschnittliche Länge der verketteten Liste den Schwellenwert überschreitet | Vergrößern, wenn der Lastfaktor (Anzahl der Elemente / Arraygröße) einen Schwellenwert überschreitet |
| Anwendbare Szenarien | Allgemein, häufiger | Cachefreundlich, geeignet für Szenarien mit bekannter maximaler Datenmenge oder knappem Speicher |
Leistung von Hash-Tabellen und Lastfaktor
Die Effizienz einer Hash-Tabelle hängt stark von einer zentralen Kennzahl ab:Lastfaktor。
Lastfaktor = Anzahl der in der Hash-Tabelle gespeicherten Elemente / Gesamtgröße des Hash-Tabellen-Arrays
- Niedriger Lastfaktor(z. B. 0.5): Bedeutet, dass das Array noch viele leere Plätze hat, die Kollisionswahrscheinlichkeit niedrig ist und die Operationen schnell sind.
- Hoher Lastfaktor(z. B. 0.9): Bedeutet, das Array ist fast voll, die Kollisionswahrscheinlichkeit steigt stark an, verkettete Listen werden länger oder Sondierungsdistanzen werden größer, und die Leistung sinkt.
Um eine hohe Leistung aufrechtzuerhalten, wird die Hash-Tabelle erweitert, wenn der Lastfaktor einen bestimmten Schwellenwert (z. B. 0.75) überschreitet:ResizeOperationen:
- Erstellen Sie ein neues, größeres Array (normalerweise doppelt so groß wie das Original).
- Durchlaufen Sie alle Schlüssel-Wert-Paare in der alten Hash-Tabelle.
- Basierend auf der neuen Array-Größe, verwenden Sie die Hash-Funktion, um den Index für jeden Schlüssel neu zu berechnen, und fügen Sie ihn in das neue Array ein.
Dieser Prozess heißtRehashingObwohl dies zeitaufwändig ist, kann es den Lastfaktor erheblich reduzieren und die Hash-Tabelle wieder auf hohe Effizienz bringen.
Praktische Übung: Einen Wortzähler erstellen
Verwenden wir eine selbstgebaute Hash-Tabelle mit Verkettung, um ein praktisches Problem zu lösen: das Zählen der Vorkommen jedes Wortes in einem Textabschnitt.
Wir werden den folgenden Text als Testdaten verwenden (Sie können ihn in Ihren Code kopieren):
the quick brown fox jumps over the lazy dog the dog is not lazy at all
Beispiel
print("\n=== Praktische Übung: Wortzähler ===)
# 1. Erstellen Sie eine Hash-Tabellen-Instanz
word_counter = HashTableChaining(size=10)
# 2. Vorgegebener Testtext
text = "der schnelle braune Fuchs springt über den faulen Hund der Hund ist überhaupt nicht faul"
words = text.split() # Den Text in eine Liste von Wörtern aufteilen
print(Verarbeitete Wortliste:, words)
# 3. Wörter durchlaufen und in die Hash-Tabelle einfügen
for word in words:
current_count = word_counter.get(word)
if current_count is None:
# Erstes Vorkommen eines Wortes, Zähler ist 1
word_counter.insert(word, 1)
else:
# Wort existiert bereits, Zähler um 1 erhöhen
word_counter.insert(word, current_count + 1)
# 4. Statistische Ergebnisse ausgeben
print("\nWortvorkommen-Statistik:)
# Hinweis: Unsere Anzeigemethode gibt nach Index aus; hier schreiben wir eine benutzerfreundlichere Ausgabe
all_entries = []
for bucket in word_counter.table:
all_entries.extend(bucket) # Einträge in allen Buckets zusammenführen
for word, count in all_entries:
print(f'{word}': {count} Mal)
# 5. Ein bestimmtes Wort überprüfen
test_word = "the"
print(f"\nÜberprüfen: Das Wort '{test_word}' kam {word_counter.get(test_word)} Mal vor.)
test_word = "lazy"
print(fÜberprüfen: Das Wort '{test_word}' kam {word_counter.get(test_word)} Mal vor.)
Ausgabeergebnis:
=== 实践练习:单词计数器 ===
处理的单词列表: ['the', 'quick', 'brown', 'fox', 'jumps', 'over', 'the', 'lazy', 'dog', 'the', 'dog', 'is', 'not', 'lazy', 'at', 'all']

单词出现次数统计:
  'the': 3 次
  'quick': 1 次
  'brown': 1 次
  'fox': 1 次
  'jumps': 1 次
  'over': 1 次
  'lazy': 2 次
  'dog': 2 次
  'is': 1 次
  'not': 1 次
  'at': 1 次
  'all': 1 次

验证:单词 'the' 出现了 3 次。
验证:单词 'lazy' 出现了 2 次。
Herzlichen Glückwunsch! Sie haben erfolgreich Ihre eigene Hash-Tabellen-Implementierung genutzt, um eine praktische Aufgabe abzuschließen. In der realen Programmierung müssen Sie selten selbst eine Hash-Tabelle implementieren, denn moderne Programmiersprachen (wie PythonsdictJavasHashMapC++'sunordered_map) bieten alle hochoptimierte, leistungsstarke integrierte Hash-Tabellen-Implementierungen. Das Verständnis ihrer Prinzipien kann Ihnen helfen, sie klüger und effizienter zu nutzen.
Zusammenfassung und Überprüfung der Kernpunkte
Was ist eine Hash-Tabelle: Eine effiziente Datenstruktur, die direkt über Schlüssel auf Werte zugreift, mit einer durchschnittlichen Zeitkomplexität vonO(1)。
Kernmechanismus: Hash-FunktionDen Schlüssel in einen Array-Index umwandeln.
Zentrale Herausforderungen: Hash-Kollision—verschiedene Schlüssel werden demselben Index zugeordnet.
Lösung:
- Separate Verkettung: Jede Indexposition speichert eine verkettete Liste, um kollidierende Schlüssel-Wert-Paare aufzunehmen.
- Offene Adressierung: Finde den nächsten leeren Slot im Array gemäß der Sondierungssequenz.
Leistungskritisch: Lastfaktor. Wenn der Lastfaktor zu hoch ist, muss esResizeundRehashingum die Leistung wiederherzustellen.
Praktische Anwendungen: Hash-Tabellen sind ein Eckpfeiler der Programmierung und werden in unzähligen Szenarien weit verbreitet eingesetzt, wie Datenbankindizierung, Cache-Systeme, Überprüfungen der Mengenzugehörigkeit, Speicherung von Objekteigenschaften und vielem mehr.
Weitere Erweiterungen