Einführung in Datenstrukturen und Algorithmen
In der Informatik sind Datenstrukturen und Algorithmen die Kernbasis für den Aufbau effizienter und zuverlässiger Software. Sie sind die Werkzeugkiste der Programmierer zum Lösen komplexer Probleme und bestimmen die Ausführungsgeschwindigkeit und den Ressourcenverbrauch des Programms.
Stellen Sie sich vor, Sie organisieren ein unordentliches Bücherregal. Wenn Sie Bücher einfach zufällig stapeln, wäre es sehr schwierig, ein bestimmtes Buch zu finden. Aber wenn Sie sie nach dem ersten Buchstaben des Titels sortieren oder kategorisieren (z. B. Belletristik, Geschichte, Wissenschaft), würde die Sucheffizienz stark verbessert.DatenstrukturenGenau wie die Methode zum Organisieren eines Bücherregals definiert sie, wie Daten organisiert und gespeichert werden sollten. UndAlgorithmenist der konkrete Schritt zum Finden, Einfügen oder Löschen eines Buchs.
Datenstrukturen und Algorithmen sind die grundlegenden Fähigkeiten der Informatik, die verwendet werden, um zwei Dinge zu lösen: wie Daten organisiert werden sollten und wie Probleme effizient gelöst werden können.
Datenstrukturen
Untersucht, wie Daten im Speicher oder auf einem Speichermedium organisiert werden und wie effizient auf sie zugegriffen und sie geändert werden können. Das Kernziel ist es, Zeit- und Speicherkosten zu reduzieren.
Häufige Typen:
- Lineare Strukturen: Arrays, verkettete Listen, Stacks, Warteschlangen
- Nichtlineare Strukturen: Bäume, Graphen, Heaps, Hash-Tabellen
Algorithmen
Untersucht die Schritte und Strategien zur Problemlösung; im Wesentlichen handelt es sich um eine Abstraktion des Berechnungsprozesses. Es gibt nur zwei Bewertungskriterien: Zeitkomplexität und Speicherkomplexität.
Häufige Klassifizierungen:
- Grundlegende Algorithmen: Traversierung, Rekursion, Teile und Herrsche
- Sortieren und Suchen: Quicksort, Mergesort, binäre Suche
- Fortgeschrittene Strategien: Greedy, dynamische Programmierung, Backtracking
Beziehung
Datenstrukturen bestimmen, wie Daten gespeichert werden, und Algorithmen bestimmen, wie sie berechnet werden. Für dasselbe Problem können unterschiedliche Strukturen die Algorithmuskomplexität stark verändern.
Datenstrukturen
Eine Datenstruktur ist eine Möglichkeit für einen Computer, Daten zu speichern und zu organisieren.
Eine Datenstruktur zielt darauf ab, eine Sammlung von Datenelementen mit einer oder mehreren bestimmten Beziehungen zu implementieren und außerdem eine Menge von Operationen für diese Daten zu definieren.
Kernkonzepte
- Daten: Eine Sammlung von Symbolen, die ein Computer erkennen, speichern und verarbeiten kann, wie Zahlen, Zeichen usw.
- Datenelement: Die grundlegende Einheit der Daten, die in einem Programm normalerweise als Ganzes betrachtet und verarbeitet wird.
- Datenitem: Die kleinste unteilbare Einheit, die ein Datenelement bildet und eine eigenständige Bedeutung hat.
- Datenstrukturen: Eine Sammlung von Datenelementen, die eine oder mehrere bestimmte Beziehungen zueinander haben.
Klassifizierung von Datenstrukturen
Datenstrukturen werden hauptsächlich in zwei große Kategorien unterteilt:logische Strukturundphysische Struktur。
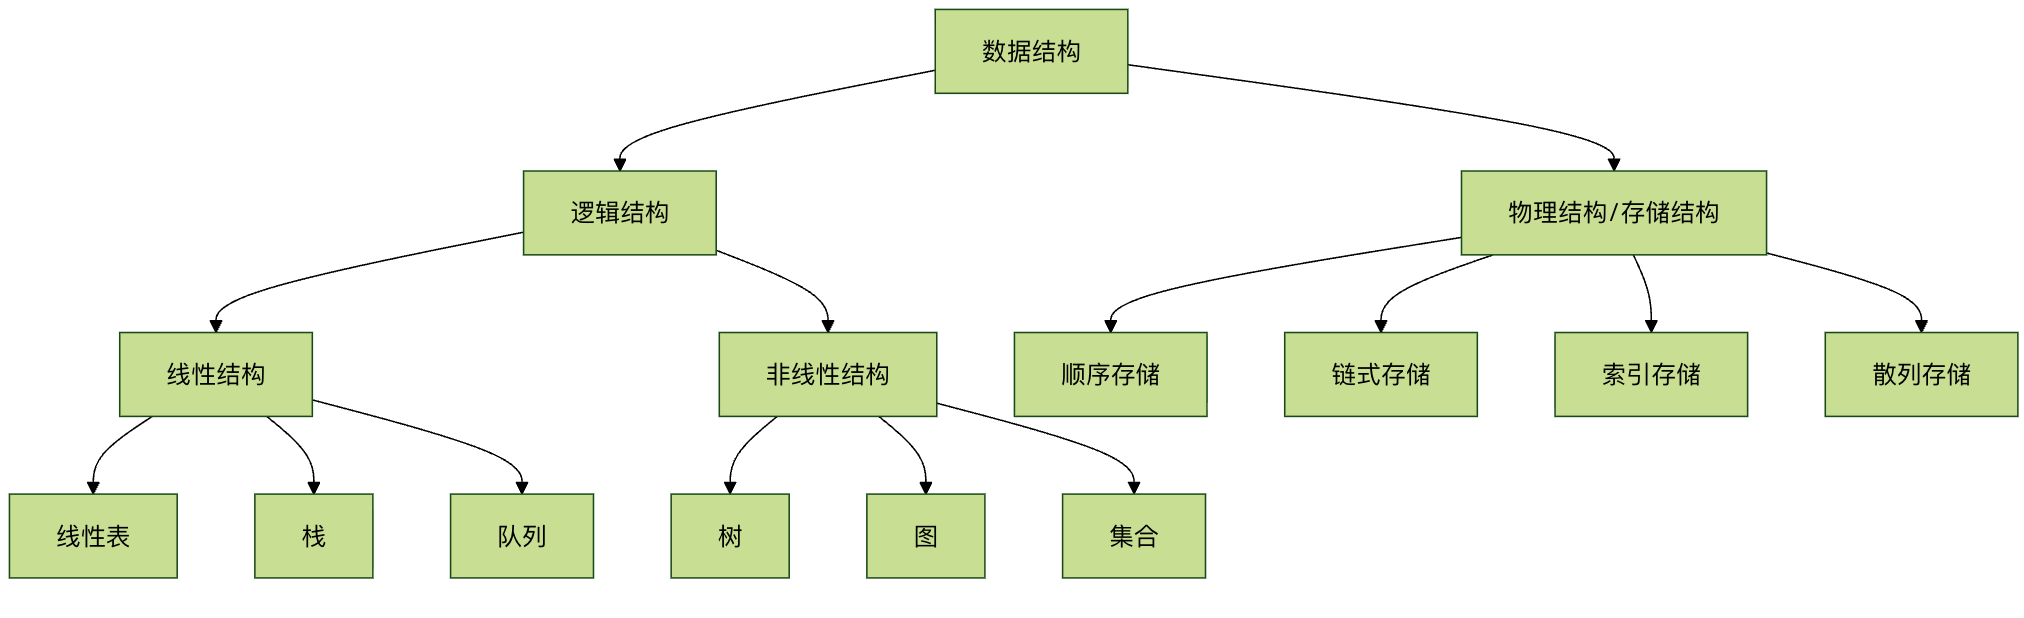
Logische StrukturBeschreibt die abstrakten Beziehungen zwischen Datenelementen, unabhängig davon, wie der Computer sie implementiert. Sie wird hauptsächlich unterteilt in:
- Lineare Struktur: Zwischen Datenelementen besteht eine lineare „Eins-zu-eins“-Beziehung. Wie Arrays, verkettete Listen, Stacks und Warteschlangen.
- Nichtlineare Struktur: Zwischen Datenelementen bestehen komplexe „Eins-zu-viele“- oder „Viele-zu-viele“-Beziehungen. Wie Bäume, Graphen und Mengen.
Physische Struktur(Auch Speicherstruktur genannt) Die tatsächliche Speicherungsmethode von Daten im Computerspeicher. Sie wird hauptsächlich unterteilt in:
- Sequentielle Speicherung: Logisch benachbarte Elemente werden in Speichereinheiten gespeichert, die auch physisch benachbart sind. Wie Arrays.
- Verkettete Speicherung: Erfordert nicht, dass logisch benachbarte Elemente physisch benachbart sind; die logischen Beziehungen zwischen Elementen werden durch zusätzliche Zeiger dargestellt. Wie verkettete Listen.
Algorithmen
Ein Algorithmus ist eine klare, endliche Folge von Anweisungsschritten zur Lösung eines bestimmten Problems.
Ein effektiver Algorithmus sollte die folgenden fünf Eigenschaften haben:
- Endlichkeit: Der Algorithmus muss nach einer endlichen Anzahl von Schritten terminieren.
- Determiniertheit: Jeder Schritt des Algorithmus muss eine eindeutige Definition ohne Mehrdeutigkeit haben.
- Durchführbarkeit: Jeder Schritt des Algorithmus kann durch bereits implementierte Basisoperationen endlich oft ausgeführt werden.
- Eingabe: Ein Algorithmus hat null oder mehr Eingaben.
- Ausgabe: Ein Algorithmus hat eine oder mehrere Ausgaben, die in einer bestimmten Beziehung zu den Eingaben stehen.
Bewertungskriterien für Algorithmen: Zeitkomplexität und Speicherkomplexität
Wie beurteilen wir, ob ein Algorithmus gut oder schlecht ist? Normalerweise wird er anhand vonZeitundSpeicher, zwei Dimensionen, gemessen.
- Zeitkomplexität: Beschreibt qualitativ die Laufzeit des Algorithmus. Sie stellt den Wachstumstrend der Ausführungszeit des Algorithmus dar, wenn die Problemgröße n zunimmt. Wird üblicherweise mit der Big-O-Notation ausgedrückt.
- Speicherkomplexität: Beschreibt qualitativ die Größe des temporären Speicherplatzes, den der Algorithmus während der Ausführung belegt. Wird ebenfalls mit der Big-O-Notation ausgedrückt.
Vergleich gängiger Zeitkomplexitäten
Die folgende Tabelle zeigt die Trends verschiedener Zeitkomplexitäten bei wachsendem Datenumfang:
| Komplexitätsdarstellung | Name | Beispiel (n=10 vs. n=1000) | Beschreibung |
|---|---|---|---|
| O(1) | Konstante Ordnung | 1 Schritt vs. 1 Schritt | Höchste Effizienz, unabhängig von der Problemgröße |
| O(log n) | Logarithmische Ordnung | ~3 Schritte vs. ~10 Schritte | Sehr hohe Effizienz, wie bei der binären Suche |
| O(n) | Lineare Ordnung | 10 Schritte vs. 1000 Schritte | Gute Effizienz, wie beim Durchlaufen eines Arrays |
| O(n log n) | Linearithmische Ordnung | ~30 Schritte vs. ~10000 Schritte | Ziemlich gute Effizienz, wie bei Quicksort |
| O(n²) | Quadratische Ordnung | 100 Schritte vs. 1,000,000 Schritte | Geringere Effizienz, wie bei der einfachen Auswahlsortierung |
| O(2ⁿ) | Exponentielle Ordnung | 1024 Schritte vs. astronomische Zahlen | Extrem niedrige Effizienz, sollte nach Möglichkeit vermieden werden |
Einfaches Verständnis: Was wir anstreben, sind Algorithmen, deren Zeitverbrauch langsamer wächst, je größer die Datenmenge n wird. O(1) und O(log n) sind ausgezeichnet, O(n) ist akzeptabel, und O(n²) und darüber müssen bei großen Datenmengen optimiert werden.
Klassische Beispiele für Datenstrukturen und Algorithmen
Lassen Sie uns die Anwendung von Datenstrukturen und Algorithmen anhand eines konkreten Problems erleben.
Problem: In einer ungeordneten Liste von Zahlen schnell feststellen, ob eine Zielzahl existiert.
Lösung 1: Lineare Suche (mit Arrays)
Dies ist eine intuitive, aber ineffiziente Methode.
- Datenstrukturen: Array (eine lineare Liste mit sequenzieller Speicherung).
- Algorithmen: Beginnend beim ersten Element, vergleiche es eines nach dem anderen mit dem Zielwert, bis es gefunden wird oder alle Elemente durchlaufen wurden.
- Zeitkomplexität: O(n). Im schlimmsten Fall müssen alle n Elemente überprüft werden.
Beispiel
def linear_search(arr, target):
"""
Sucht linear nach dem Zielwert target im Array arr.
Parameter:
arr: die zu durchsuchende Liste
target: der zu findende Zielwert
Rückgabe:
Wenn gefunden, den Index zurückgeben; andernfalls -1 zurückgeben.
"""
for i in range(len(arr)): # Durchlaufe jedes Element des Arrays
if arr[i] == target: # Wenn das aktuelle Element dem Zielwert entspricht
return i # Gib den aktuellen Index zurück
return -1 # Nach dem Durchlauf, falls nicht gefunden, -1 zurückgeben
# Testdaten
test_data = [12, 45, 67, 89, 34, 23, 90, 11]
target_number = 34
# Suche durchführen
result = linear_search(test_data, target_number)
# Ergebnis ausgeben
if result != -1:
print(f"Der Index der Zielzahl {target_number} im Array ist: {result}")
else:
print(f"Zielzahl {target_number} im Array nicht gefunden.")
Ausgabeergebnis:
目标数字 34 在数组中的索引是:4
Lösung 2: Binäre Suche (mit einem sortierten Array)
Dies ist eine effiziente Methode, aber die Voraussetzung ist, dass die Daten sortiert sein müssen.
- Datenstrukturen: Geordnetes Array.
- Algorithmen:
- Vergleiche den Zielwert mit dem mittleren Element des Arrays.
- Wenn er gleich ist, ist er gefunden.
- Wenn der Zielwert kleiner ist, wiederhole Schritt 1 in der linken Hälfte des Arrays.
- Wenn der Zielwert größer ist, wiederhole Schritt 1 in der rechten Hälfte des Arrays.
- Wenn das Suchintervall leer ist, wurde es nicht gefunden.
- Zeitkomplexität: O(log n). Jeder Vergleich halbiert den Suchbereich.
Beispiel
def binary_search(sorted_arr, target):
"""
Binäre Suche nach dem Zielwert target im sortierten Array sorted_arr.
Parameter:
sorted_arr: sortierte Liste (aufsteigend)
target: der zu findende Zielwert
Rückgabe:
Wenn gefunden, den Index zurückgeben; andernfalls -1 zurückgeben.
"""
left, right = 0, len(sorted_arr) - 1 # Initialisiere den Suchbereich auf das gesamte Array
while left <= right: # Suche weiter, solange der Bereich gültig ist
mid = (left + right) // 2 # Den mittleren Index berechnen
if sorted_arr[mid] == target: # Zielwert gefunden
return mid
elif sorted_arr[mid] < target: # Zielwert befindet sich in der rechten Hälfte
left = mid + 1
else: # Zielwert befindet sich in der linken Hälfte
right = mid - 1
return -1 # Ungültiger Bereich, nicht gefunden
# Testdaten (müssen sortiert sein)
test_data = [12, 45, 67, 89, 34, 23, 90, 11]
sorted_test_data = sorted(test_data) # Testdaten sortieren
print(fSortiertes Array: {sorted_test_data})
target_number = 34
# Suche durchführen
result = binary_search(sorted_test_data, target_number)
# Ergebnis ausgeben
if result != -1:
print(fIndex der Zielnummer {target_number} im sortierten Array: {result})
else:
print(fZielzahl {target_number} nicht im sortierten Array gefunden)
Ausgabeergebnis:
有序数组:[11, 12, 23, 34, 45, 67, 89, 90]
目标数字 34 在有序数组中的索引是:3
Vergleich und Überlegung:
- Wann
n=1000, erfordert die lineare Suche höchstens 1000 Vergleiche, während die binäre Suche höchstens nur etwa 10 Vergleiche benötigt (da 2^10 ≈ 1024). - Die binäre Suche ist weitaus effizienter als die lineare Suche, aber sie erfordert, dass die Daten vorsortiert sind. Das Sortieren selbst verursacht Kosten, daher hängt die Wahl des Algorithmus vom konkreten Szenario ab (zum Beispiel, ob die Daten statisch mit häufigen Suchen oder dynamisch mit häufigen Einfügungen sind).
Wie beginnt man mit dem Lernen?
Das Lernen von Datenstrukturen und Algorithmen ist ein schrittweiser Prozess. Es wird empfohlen, diesem Pfad zu folgen:
- Beherrsche eine Programmiersprache: Zuerst brauchst du ein Werkzeug, um deine Ideen umzusetzen. Python, Java oder C++ sind alle gute Wahlmöglichkeiten. Python hat eine prägnante Syntax und ist für Anfänger besser geeignet, sich auf die Algorithmuslogik selbst zu konzentrieren.
- Beginne mit grundlegenden Datenstrukturen:
- Array / Liste: Die grundlegendste und am häufigsten verwendete sequenzielle Speicherstruktur.
- Verkettete Liste: Der Schlüssel zum Verständnis von Zeigern/Referenzen und dynamischer Speicherzuweisung.
- Stapel und Warteschlange: Verstehe die in ihren Operationen eingeschränkten linearen Listen des "Last In, First Out" und "First In, First Out".
- Lerne grundlegende Algorithmuskonzepte:
- Sortieralgorithmen: Bubblesort, Selectionsort, Insertionsort (O(n²) verstehen), dann Mergesort und Quicksort lernen (O(n log n) und die Divide-and-Conquer-Idee verstehen).
- Suchalgorithmen: Sequenzielle Suche, binäre Suche.
- Nichtlineare Strukturen herausfordern:
- Baum: Konzentriere dich auf Binärbäume, insbesondere binäre Suchbäume. Verstehe Baumtraversierung (Preorder, Inorder, Postorder).
- Graph: Verstehe Methoden zur Graphendarstellung (Adjazenzmatrix, Adjazenzliste) und grundlegende Traversierungsalgorithmen (Tiefensuche DFS, Breitensuche BFS).
- Üben und Problemlösen: Übe, indem du mit einfachen Problemen auf Plattformen wie LeetCode und Niuke.com beginnst, um Theorie in die Praxis umzusetzen. Dies ist der beste Weg, Wissen zu festigen und dein Denken zu trainieren.