Индексная куча и её оптимизация
1. Понятие и введение
Индексная куча — это оптимизация структуры данных кучи.
Индексная куча использует новый массив int для хранения информации об индексах.
По сравнению с кучами преимущества следующие:
- Оптимизирует накладные расходы на обмен элементами.
- Позиция добавляемых данных фиксирована, что упрощает их поиск.
II. Указания по применимости
Если элементы, хранящиеся в куче, большие, их перестановка занимает много времени. В этом случае в качестве замены можно использовать структуру данных «индексная куча»; куча хранит индексы массива, а оперируем мы индексами.
III. Схема структуры
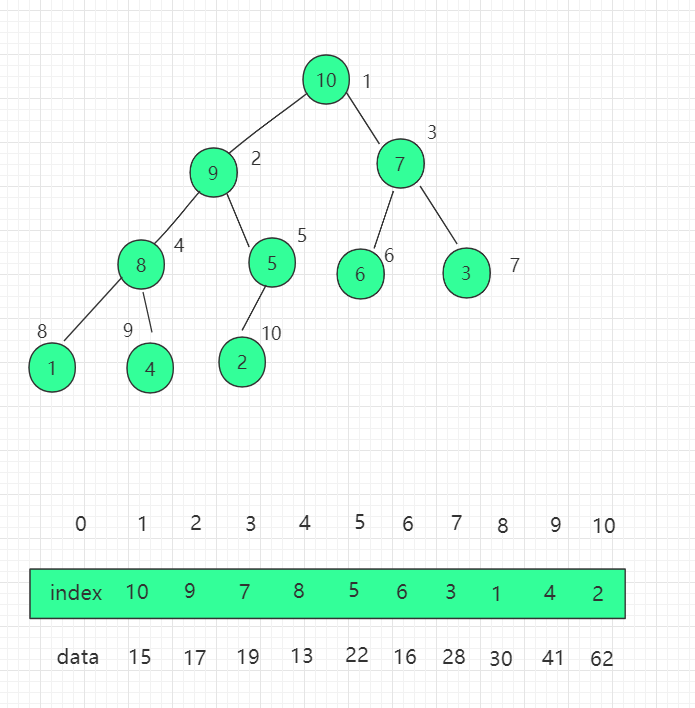
Нам нужно изменить предыдущую реализацию кучи и перейти к подходу с непосредственной работой с индексами. Сначала добавим в конструктор свойство-массив индексов "indexes".
protected int[] indexes; // Индексы в индексной куче максимумов
protected int count;
protected int capacity;
Соответственно скорректируйте конструктор, добавив инициализацию массива индексов.
public IndexMaxHeap(int capacity){
data = (T[])new Comparable[capacity+1];
indexes = new int[capacity+1];
count = 0;
this.capacity = capacity;
}
...
Скорректируйте операцию вставки: элементы, добавляемые в массив indexes, — это индексы фактического массива data.indexes[count+1] = i。
// Вставить новый элемент в максимальную индексную кучу. Индекс нового элемента — i, а элемент — item
// Переданный i имеет нулевую индексацию с точки зрения пользователя
public void insert(int i, Item item){
assert count + 1 <= capacity;
assert i + 1 >= 1 && i + 1 <= capacity;
i += 1;
data[i] = item;
indexes[count+1] = i;
count ++;
shiftUp(count);
}
...
Скорректируйте операцию shift up: сравнение основано на размере данных родительского узла в массиве data, поэтому это нужно выразить какdata[index[k/2]] < data[indexs[k]], меняя местами индексы в массиве индексов, не вызывая изменений в массиве data; то же самое относится и к shift down.
// k — это индекс в куче
// В индексной куче сравнения основаны на размере data, но фактические операции выполняются над индексами
private void shiftUp(int k){
while( k > 1 && data[indexes[k/2]].compareTo(data[indexes[k]]) < 0 ){
swapIndexes(k, k/2);
k /= 2;
}
}
...
При извлечении элемента из индексной кучи наибольший элемент — это корневой элемент.data[index[1]]в data, а затем поменять местами позиции индексов, чтобы продолжить.shift downоперация.
public T extractMax(){
assert count > 0;
T ret = data[indexes[1]];
swapIndexes( 1 , count );
count --;
shiftDown(1);
return ret;
}
...
Вы также можете напрямую получить индекс в массиве data для максимального значения.
// Извлечь индекс верхнего элемента из кучи максимальных индексов
public int extractMaxIndex(){
assert count > 0;
int ret = indexes[1] - 1;
swapIndexes( 1 , count );
count --;
shiftDown(1);
return ret;
}
...
Изменение data по позиции индекса
// Изменить элемент с индексом i в куче максимальных индексов на newItem
public void change( int i , Item newItem ){
i += 1;
data[i] = newItem;
// Найти indexes[j] = i, где j представляет позицию data[i] в куче
// Затем shiftUp(j), затем shiftDown(j)
for( int j = 1 ; j <= count ; j ++ )
if( indexes[j] == i ){
shiftUp(j);
shiftDown(j);
return;
}
}
...
IV. Пример кода на Java
Исходный пакет:Скачать
Код в src/example/heap/IndexMaxHeap.java:
import * Heap;
/**
* Индексная куча
*/
// Максимальная индексная куча, идея: сравнения используют значения данных, но перестановки производятся по индексам
public IndexMaxHeap extends<T Comparable Comparable> {
protected T[] data; // Данные в индексной куче максимумов
protected int[] indexes; // Индексы в индексной куче максимумов
protected int count;
protected int capacity;
// Конструктор, создаёт пустую кучу, которая может вместить capacity элементов
public IndexMaxHeap(int capacity){
data = (T[])new Comparable[capacity+1];
indexes = new int[capacity+1];
count = 0;
this.capacity = capacity;
}
// Возвращает количество элементов в индексной куче
public int size(){
return count;
}
// Возвращает логическое значение, указывающее, пуста ли индексная куча
public boolean isEmpty(){
return count == 0;
}
// Вставить новый элемент в максимальную индексную кучу. Индекс нового элемента — i, а элемент — item
// Переданный i имеет нулевую индексацию с точки зрения пользователя
public void insert(int i, T item){
assert count + 1 <= capacity;
assert i + 1 >= 1 && i + 1 <= capacity;
i += 1;
data[i] = item;
indexes[count+1] = i;
count ++;
shiftUp(count);
}
// Извлекает верхний элемент из максимальной индексной кучи, т.е. максимальные данные, хранящиеся в индексной куче
public T extractMax(){
assert count > 0;
T ret = data[indexes[1]];
swapIndexes( 1 , count );
count --;
shiftDown(1);
return ret;
}
// Извлечь индекс верхнего элемента из кучи максимальных индексов
public int extractMaxIndex(){
assert count > 0;
int ret = indexes[1] - 1;
swapIndexes( 1 , count );
count --;
shiftDown(1);
return ret;
}
// Получить верхний элемент максимальной индексной кучи
public T getMax(){
assert count > 0;
return data[indexes[1]];
}
// Получить индекс верхнего элемента в максимальной индексной куче
public int getMaxIndex(){
assert count > 0;
return indexes[1]-1;
}
// Получить элемент с индексом i в максимальной индексной куче
public T getItem( int i ){
assert i + 1 >= 1 && i + 1 <= capacity;
return data[i+1];
}
// Изменить элемент с индексом i в куче максимальных индексов на newItem
public void change( int i , T newItem ){
i += 1;
data[i] = newItem;
// Найти indexes[j] = i, где j представляет позицию data[i] в куче
// Затем shiftUp(j), затем shiftDown(j)
for( int j = 1 ; j <= count ; j ++ )
if( indexes[j] == i ){
shiftUp(j);
shiftDown(j);
return;
}
}
// Поменять местами индексы i и j в индексной куче
private void swapIndexes(int i, int j){
int t = indexes[i];
indexes[i] = indexes[j];
indexes[j] = t;
}
//********************
//* Основные вспомогательные функции индексной кучи максимума
//********************
// k — это индекс в куче
// В индексной куче сравнения основаны на размере data, но фактические операции выполняются над индексами
private void shiftUp(int k){
while( k > 1 && data[indexes[k/2]].compareTo(data[indexes[k]]) < 0 ){
swapIndexes(k, k/2);
k /= 2;
}
}
// В индексной куче сравнения основаны на размере data, но фактические операции выполняются над индексами
private void shiftDown(int k){
while( 2*k <= count ){
int j = 2*k;
if( j+1 <= count && data[indexes[j+1]].compareTo(data[indexes[j]]) > 0 )
j ++;
if( data[indexes[k]].compareTo(data[indexes[j]]) >= 0 )
break;
swapIndexes(k, j);
k = j;
}
}
// Тест IndexMaxHeap
public static void main(String[] args) {
int N = 1000000;
IndexMaxHeap<Integer> indexMaxHeap = new IndexMaxHeap<Integer>(N);
for( int i = 0 ; i < N ; i ++ )
indexMaxHeap.insert( i , (int)(Math.random()*N) );
}
}
В приведённом выше изменении позиции индекса мы использовали обход для поиска позиции индекса, что неэффективно. Мы можем дополнительно оптимизировать это, поддерживая наборreverse[i]массивов, которые представляют позицию индекса i в indexes (куче), уменьшая временную сложность поиска до O(1).

Он обладает следующими свойствами:
indexes[i] = j
reverse[j] = i

indexes[reverse[i]] = i
reverse[indexes[i]] = i
Другие расширения