Tipos de datos en R
El tipo de datos se refiere a un sistema amplio que se utiliza para declarar variables o funciones de diferentes tipos.
El tipo de una variable determina el espacio que ocupa su almacenamiento y cómo se interpreta el patrón de bits almacenado.
Los tipos de datos más básicos en R son principalmente tres:
- Numérico
- Lógico
- Texto
Las constantes numéricas son principalmente de dos tipos:
| Tipo general | 123 -0.125 |
|---|---|
| Notación científica | 1.23e2 -1.25E-1 |
El tipo lógico en muchos otros lenguajes de programación suele denominarse tipo booleano (Boolean); sus valores constantes son soloTRUEyFALSE。
Nota:R distingue entre mayúsculas y minúsculas; true o True no pueden representar TRUE.
El tipo de datos más intuitivo es el tipo de texto. El texto es la cadena (String) que suele aparecer en otros lenguajes; las constantes se encierran entre comillas dobles. En R, las constantes de texto pueden encerrarse tanto con comillas simples como con comillas dobles, por ejemplo:
Ejemplo
[1] TRUE
En cuanto a la definición de variables en R, no es como las reglas sintácticas de algunos lenguajes fuertemente tipados, donde es necesario establecer específicamente el nombre y el tipo de datos de la variable. Cada vez que se utiliza un operador de asignación en R, en realidad se está definiendo una nueva variable:
Ejemplo
b <- TRUE
b = "abc"
Según el tipo de objeto, se dividen en los siguientes 6 tipos (estos tipos se explicarán en detalle más adelante):
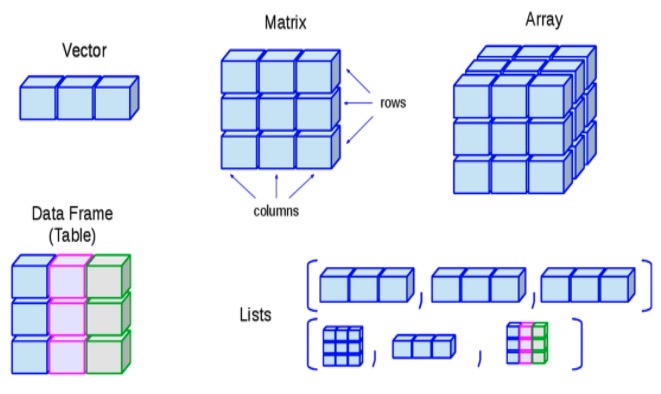
Vector
El vector suele estar disponible en las bibliotecas estándar de lenguajes de programación especializados como Java, Rust y C#, porque el vector es una herramienta indispensable en las operaciones matemáticas: el vector más común que vemos es el vector bidimensional, que se utiliza necesariamente en el sistema de coordenadas del plano.
Desde el punto de vista de la estructura de datos, un vector es una tabla lineal y puede considerarse como un arreglo.
En R, el hecho de que el vector exista como un tipo hace que las operaciones con vectores sean más fáciles:
Ejemplo
> b = c(5, 0)
> a + b
[1] 8 4
>
c()es una función que crea vectores.
Aquí se suman dos vectores bidimensionales y se obtiene un nuevo vector bidimensional (8, 4). Si se realiza una operación entre un vector bidimensional y un vector tridimensional, perderá su significado matemático; aunque no detendrá la ejecución, se mostrará una advertencia.
Recomiendo que, por hábito, eviten que esta situación ocurra.
Cada elemento de un vector puede extraerse individualmente mediante su índice:
Ejemplo
> a[2]
[1] 20
Nota:En R, el "índice" no representa un desplazamiento, sino el número ordinal, es decir, ¡comienza desde 1!
R también puede extraer fácilmente una parte de un vector:
Ejemplo
[1] 10 20 30 40
> a[c(1, 3, 5)] # Extraer los elementos 1, 3 y 5
[1] 10 30 50
> a[c(-1, -5)] # Eliminar los elementos 1 y 5
[1] 20 30 40
Estos tres métodos de extracción parcial son los más utilizados.
Los vectores admiten cálculos escalares:
Ejemplo
[1] 0.6 0.7 0.8
> a = c(1,2)
> a ^ 2
[1] 1 4
Las funciones matemáticas comunes mencionadas anteriormente, como sqrt, exp, etc., también pueden utilizarse para realizar operaciones escalares sobre vectores.
El "vector", como estructura de tabla lineal, debería tener algunas funciones comunes de procesamiento de tablas lineales; R ciertamente posee estas funciones:
Ordenamiento de vectores:
Ejemplo
> sort(a)
[1] 1 2 3 4 5 6
> rev(a)
[1] 6 4 2 5 3 1
> order(a)
[1] 1 4 2 5 3 6
> a[order(a)]
[1] 1 2 3 4 5 6
La función order() devuelve un vector de índices después de ordenar un vector.
Estadísticas de vectores
R tiene funciones estadísticas muy completas:
| Nombre de la función | Significado |
|---|---|
| sum | Suma |
| mean | Media (promedio) |
| var | Varianza |
| sd | Desviación estándar |
| min | Mínimo |
| max | Máximo |
| range | Rango (vector bidimensional, máximo y mínimo) |
Ejemplo de estadísticas de vectores:
Ejemplo
[1] 15
> sd(1:5)
[1] 1.581139
> range(1:5)
[1] 1 5
Generación de vectores
La generación de vectores se puede realizar conc()la función c(), o también se puede usar el operador min:max para generar secuencias continuas.
Si se desea generar una progresión aritmética con intervalos, se puede usar la función seq:
> seq(1, 9, 2)
[1] 1 3 5 7 9
seq también puede generar una progresión aritmética de m a n; solo es necesario especificar m, n y la longitud de la secuencia:
> seq(0, 1, length.out=3)
[1] 0.0 0.5 1.0
rep significa repeat (repetir); se puede utilizar para generar secuencias de números que se repiten:
> rep(0, 5)
[1] 0 0 0 0 0
En los vectores se utilizan a menudo NA y NULL; aquí se presentan estos dos términos y su diferencia:
- NA representa "valor perdido" (missing); NULL representa "no existe" (nothing).
- NA, como valor perdido, es como un marcador de posición: representa que aquí no hay un valor, pero la posición existe.
- NULL representa que los datos no existen.
Ejemplo ilustrativo:
Ejemplo
[1] 2
> c(NA, NA, NULL, NA)
[1] NA NA NA
Es evidente que NULL no tiene ningún significado en un vector.
Tipo lógico
Los vectores lógicos se utilizan principalmente para operaciones lógicas con vectores, por ejemplo:
Ejemplo
[1] FALSE FALSE TRUE
La función which es una función de procesamiento de vectores lógicos muy común; se puede utilizar para filtrar los índices de los datos que necesitamos:
Ejemplo
> b = a > 12
> print(b)
[1] FALSE FALSE TRUE
> which(b)
[1] 3
Por ejemplo, si necesitamos filtrar de una tabla lineal los datos mayores o iguales a 60 y menores que 70:
Ejemplo
> print(vector[which(vector >= 60 & vector < 70)])
[1] 64 62 69
Funciones similares son all y any:
Ejemplo
[1] TRUE
> all(c(TRUE, TRUE, FALSE))
[1] FALSE
> any(c(TRUE, FALSE, FALSE))
[1] TRUE
> any(c(FALSE, FALSE, FALSE))
[1] FALSE
all() se utiliza para comprobar si todos los elementos de un vector lógico son TRUE; any() se utiliza para comprobar si un vector lógico contiene algún TRUE.
Cadenas (strings)
El tipo de datos de cadena no es complejo en sí mismo; aquí nos centramos en presentar las funciones de operación con cadenas:
Ejemplo
[1] "EJEMPLO"
> tolower("Ejemplo") # Convertir a minúsculas
[1] "ejemplo"
> nchar("Chino", type="bytes") # Contar la longitud en bytes
[1] 4
> nchar("Chino", type="char") # Contar el número de caracteres
[1] 2
> substr("123456789", 1, 5) # Extraer la subcadena, del 1 al 5
[1] "12345"
> substring("1234567890", 5) # Extraer la subcadena, del 5 hasta el final
[1] "567890"
> as.numeric("12") # Convertir la cadena a número
[1] 12
> as.character(12.34) # Convertir el número a cadena
[1] "12.34"
> strsplit("2019;10;1", ";") # Dividir la cadena por un separador
[[1]]
[1] "2019" "10" "1"
> gsub("/", "-", "2019/10/1") # Reemplazar la cadena
[1] "2019-10-1"
En computadoras con Windows, se utiliza el estándar de codificación GBK, por lo que un carácter chino ocupa dos bytes. Si se ejecuta en una computadora con codificación UTF-8, la longitud en bytes de un solo carácter chino debería ser 3.
R admite expresiones regulares en formato del lenguaje Perl:
Ejemplo
[1] "$ $"
Para más contenido sobre cadenas, consulte:Introducción a las cadenas en R。
Matriz
R proporciona el tipo de matriz para el estudio del álgebra lineal. Esta estructura de datos es muy similar a los arreglos bidimensionales de otros lenguajes, pero R ofrece soporte a nivel de lenguaje para las operaciones con matrices.
Primero veamos la generación de matrices:
Ejemplo
> matrix(vector, 2, 3)
[,1] [,2] [,3]
[1,] 1 3 5
[2,] 2 4 6
El contenido de inicialización de la matriz se transmite mediante un vector; además, hay que indicar cuántas filas y cuántas columnas tiene la matriz.
Los valores del vector se rellenan en la matriz columna por columna. Si se desea rellenar por filas, es necesario especificar el atributo byrow:
Ejemplo
[,1] [,2] [,3]
[1,] 1 2 3
[2,] 4 5 6
Cada valor de la matriz puede ser accedido directamente:
Ejemplo
> m1[1,1] # Fila 1, columna 1
[1] 1
> m1[1,3] # Fila 1, columna 3
[1] 3
En R, cada columna y cada fila de una matriz pueden recibir nombres; este proceso se realiza de forma masiva mediante vectores de cadenas:
Ejemplo
> rownames(m1) = c("a", "b")
> m1
x y z
a 1 2 3
b 4 5 6
> m1["a", ]
x y z
1 2 3
Las operaciones aritméticas básicas con matrices son prácticamente iguales que con vectores; se puede operar con escalares o con matrices del mismo tamaño realizando operaciones en las posiciones correspondientes.
Multiplicación de matrices:
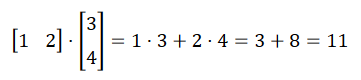
Ejemplo
> m2 = matrix(c(3, 4), 2, 1)
> m1 %*% m2
[,1]
[1,] 11
Matriz inversa:
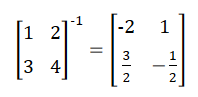
Ejemplo
> solve(A)
[,1] [,2]
[1,] -2.0 1.0
[2,] 1.5 -0.5
solve()La función se utiliza para resolver ecuaciones de álgebra lineal; su uso básico essolve(A,b), dondeAes la matriz de coeficientes del sistema de ecuaciones,bes el vector o matriz de la ecuación.
apply()La función puede operar tomando cada fila o cada columna de la matriz como un vector:
Ejemplo
[,1] [,2]
[1,] 1 2
[2,] 3 4
> apply(A, 1, sum) # El segundo parámetro es 1 para operar por filas, usando la función sum()
[1] 3 7
> apply(A, 2, sum) # El segundo parámetro es 2 para operar por columnas
[1] 4 6
Más contenido sobre matrices consulta:Matriz R。
Otras extensiones