Chinesische Kodierung in Python
In den vorherigen Kapiteln haben wir gelernt, wie man mit Python"Hello, World!"ausgibt. Englisch ist kein Problem, aber wenn Sie chinesische Zeichen"Hello, world"ausgeben, können chinesische Codierungsprobleme auftreten.
Wenn in einer Python-Datei keine Codierung angegeben ist, wird bei der Ausführung ein Fehler gemeldet:
#!/usr/bin/python

print ("你好,世界")
Die Ausgabe der obigen Programmausführung ist:
  File "test.py", line 2
SyntaxError: Non-ASCII character '\xe4' in file test.py on line 2, but no encoding declared; see http://www.python.org/peps/pep-0263.html for details
Das Standard-Codierungsformat in Python ist ASCII. Ohne Änderung des Codierungsformats können chinesische Zeichen nicht korrekt ausgegeben werden, daher wird beim Lesen chinesischer Zeichen ein Fehler gemeldet.
Die Lösung besteht darin, einfach am Anfang der Datei# -*- coding: UTF-8 -*-oder# coding=utf-8hinzuzufügen, und schon ist es erledigt.
Hinweis:# coding=utf-8von=Fügen Sie auf beiden Seiten des #-Zeichens keine Leerzeichen hinzu.
Beispiele (Python 2.0+)
Beispiel ausführen »
Das Ausgabeergebnis ist:
Hello, world
Wenn Ihr Code beim Lernen chinesische Zeichen enthält, müssen Sie daher die Kodierung oben angeben.
Weitere ErweiterungenHinweis:Python 3.x-Quelldateien verwenden standardmäßig UTF-8-Kodierung, daher können chinesische Zeichen normal geparst werden, ohne die UTF-8-Kodierung anzugeben.
Hinweis:Wenn Sie einen Editor verwenden, müssen Sie außerdem das Speicherformat der py-Datei auf UTF-8 einstellen, andernfalls erhalten Sie eine Fehlermeldung ähnlich der folgenden:
SyntaxError: (unicode error) ‘utf-8’ codec can’t decode byte 0xc4 in position 0:
invalid continuation byte
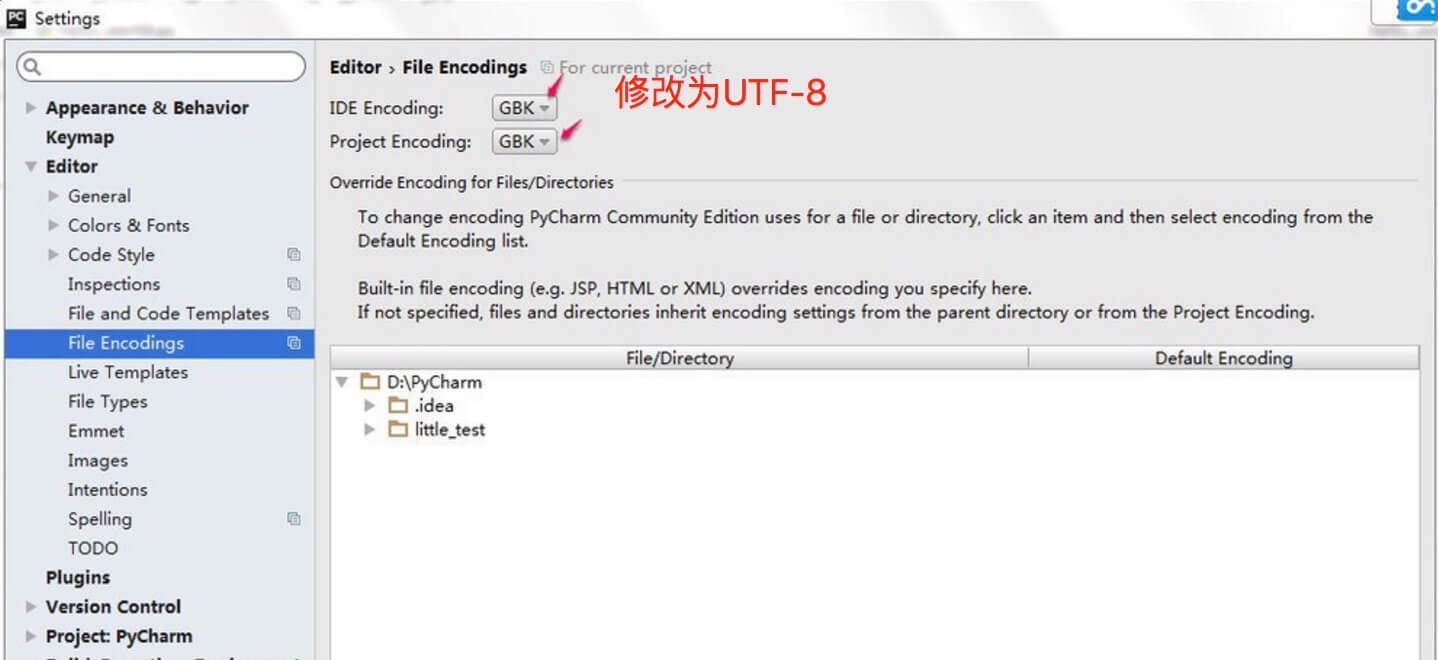
PyCharm-Einrichtungsschritte:
- Gehen Sie zufile > Settingssuchen Sie im Eingabefeld nachencoding。
- finden SieEditor > File encodingssetzen SieIDE EncodingundProject Encodingauf UTF-8.