Codificación china en Python
En los capítulos anteriores hemos aprendido cómo generar con Python"Hello, World!", no hay problema con el inglés"Hola, mundo"Entonces es posible que te encuentres con problemas de codificación china.
Si no se especifica la codificación en el archivo de Python, se producirá un error durante la ejecución:
#!/usr/bin/python

print ("你好,世界")
El resultado de la ejecución del programa anterior es:
  File "test.py", line 2
SyntaxError: Non-ASCII character '\xe4' in file test.py on line 2, but no encoding declared; see http://www.python.org/peps/pep-0263.html for details
El formato de codificación predeterminado en Python es ASCII; sin modificar el formato de codificación, no se pueden imprimir correctamente los caracteres chinos, por lo que se produce un error al leer chino.
La solución es simplemente añadir al inicio del archivo# -*- coding: UTF-8 -*-o# coding=utf-8es suficiente.
Nota:# coding=utf-8de=No pongas espacios a ambos lados del signo.
Ejemplo (Python 2.0+)
Ejecutar ejemplo »
El resultado de salida es:
Hola, mundo
Por lo tanto, si durante el estudio el código contiene chino, es necesario especificar la codificación en la cabecera.
Otras extensionesNota:Los archivos de código fuente de Python3.X usan codificación utf-8 por defecto, por lo que pueden analizar chino correctamente sin necesidad de especificar la codificación UTF-8.
Nota:Si usas un editor, también debes configurar el formato de almacenamiento del archivo .py como UTF-8; de lo contrario, aparecerá un mensaje de error similar al siguiente:
SyntaxError: (unicode error) ‘utf-8’ codec can’t decode byte 0xc4 in position 0:
invalid continuation byte
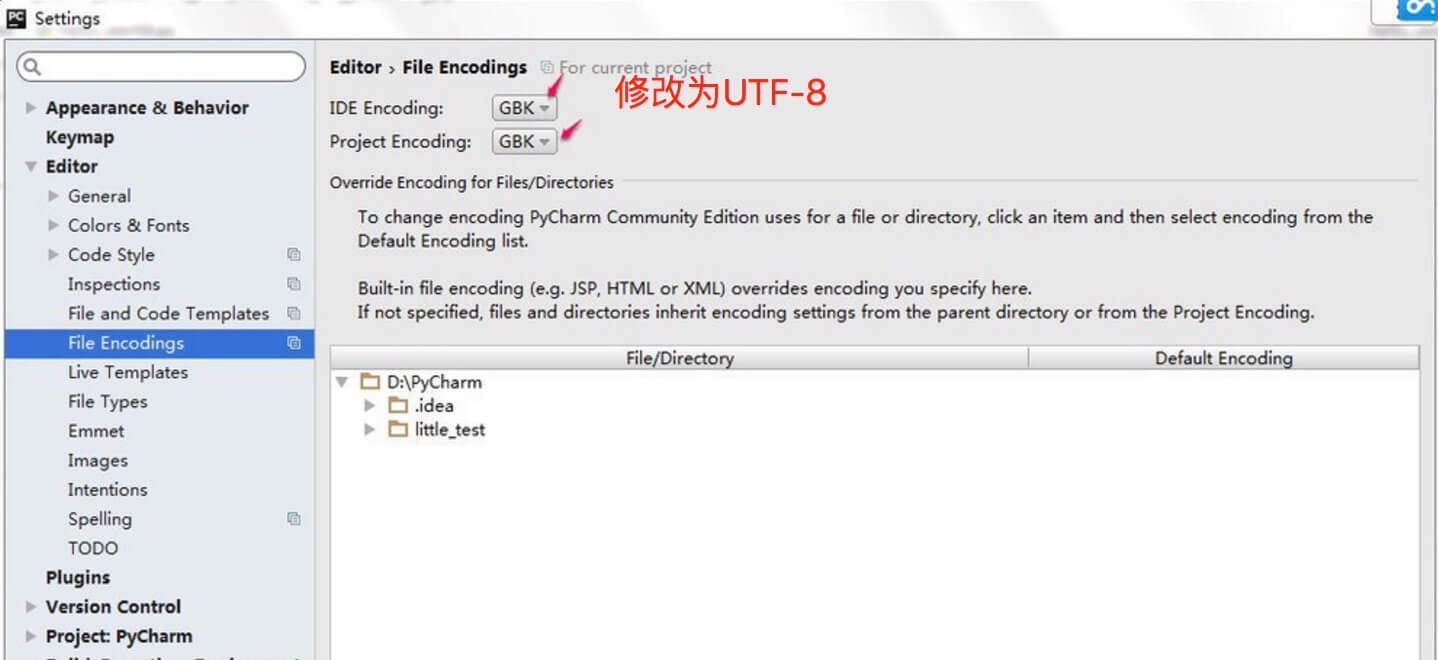
Pasos de configuración de Pycharm:
- Entra enfile > Settings, en el cuadro de entrada buscaencoding。
- EncuentraEditor > File encodings, configuraIDE EncodingyProject Encodingconfigúralo como utf-8.