Encodage chinois Python
Dans les chapitres précédents, nous avons appris à utiliser Python pour afficher"Hello, World!"L'anglais ne pose aucun problème, mais si vous affichez des caractères chinois"Hello, world"vous pouvez rencontrer des problèmes d'encodage chinois.
Si l'encodage n'est pas spécifié dans un fichier Python, une erreur sera signalée lors de l'exécution :
#!/usr/bin/python

print ("你好,世界")
La sortie de l'exécution du programme ci-dessus est :
  File "test.py", line 2
SyntaxError: Non-ASCII character '\xe4' in file test.py on line 2, but no encoding declared; see http://www.python.org/peps/pep-0263.html for details
Le format d'encodage par défaut dans Python est ASCII. Sans modifier le format d'encodage, les caractères chinois ne peuvent pas être imprimés correctement, donc une erreur est signalée lors de la lecture du chinois.
La solution consiste simplement à ajouter au début du fichier# -*- coding: UTF-8 -*-ou# coding=utf-8et c'est tout.
Remarque :# coding=utf-8:=N'ajoutez pas d'espaces de chaque côté du signe #.
Exemples (Python 2.0+)
Exécuter l'exemple »
Le résultat de sortie est:
Hello, world
Par conséquent, si votre code contient du chinois pendant votre apprentissage, vous devez spécifier l'encodage en haut.
Autres extensionsRemarque :les fichiers source Python 3.x utilisent l'encodage UTF-8 par défaut, donc le chinois peut être analysé normalement sans spécifier l'encodage UTF-8.
Remarque :Si vous utilisez un éditeur, vous devez également définir le format d'enregistrement du fichier py sur UTF-8, sinon vous obtiendrez un message d'erreur similaire à ce qui suit :
SyntaxError: (unicode error) ‘utf-8’ codec can’t decode byte 0xc4 in position 0:
invalid continuation byte
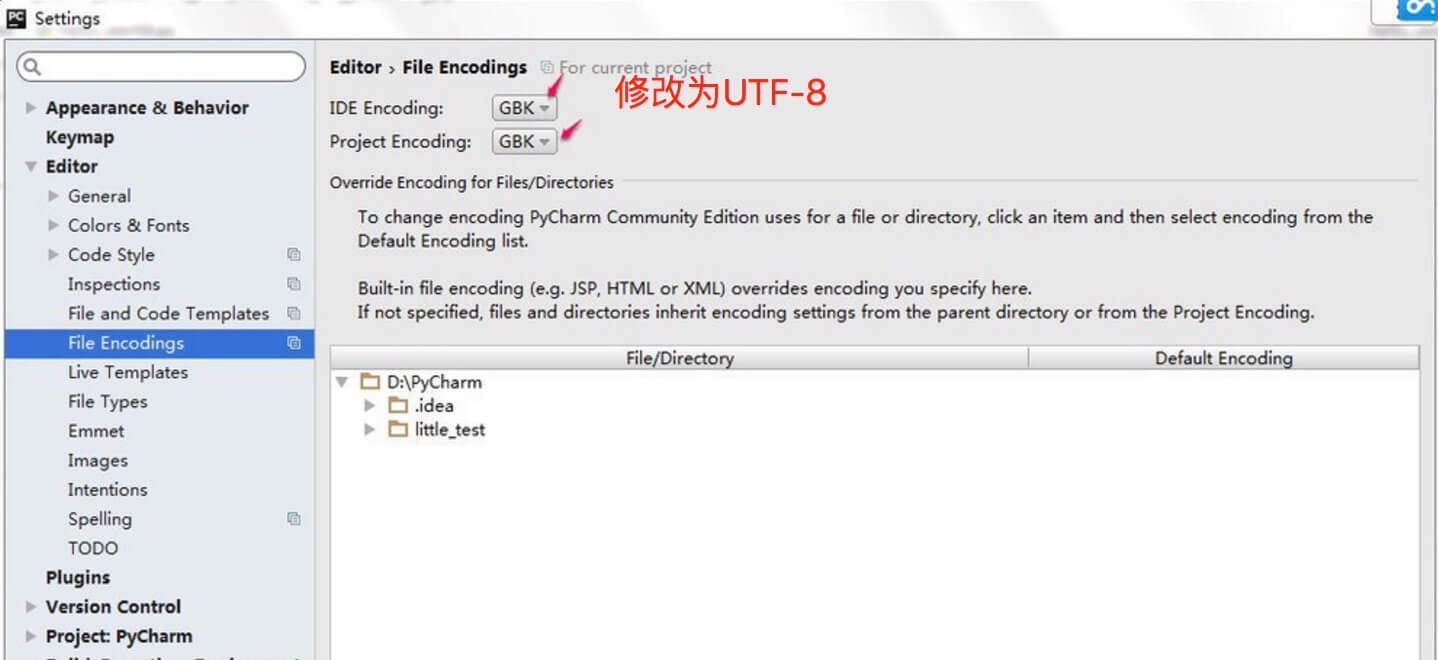
Étapes de configuration de PyCharm :
- Allez dansFichier > Paramètresrecherchez dans la zone de saisieencodage。
- trouvezÉditeur > Encodages de fichiersdéfinissezEncodage IDEetEncodage du projeten UTF-8.