Кодировка китайского языка в Python
В предыдущих главах мы узнали, как с помощью Python выводить"Hello, World!"С английским нет проблем, но если вы выводите китайские символы"Hello, world"вы можете столкнуться с проблемами кодировки китайского языка.
Если в файле Python не указана кодировка, при выполнении будет выдана ошибка:
#!/usr/bin/python

print ("你好,世界")
Вывод выполнения вышеуказанной программы:
  File "test.py", line 2
SyntaxError: Non-ASCII character '\xe4' in file test.py on line 2, but no encoding declared; see http://www.python.org/peps/pep-0263.html for details
Формат кодировки по умолчанию в Python — ASCII. Если не изменить формат кодировки, китайские символы нельзя будет напечатать правильно, поэтому при чтении китайского текста возникает ошибка.
Решение — просто добавить в начале файла# -*- coding: UTF-8 -*-или# coding=utf-8и всё.
Примечание:# coding=utf-8написание:=Не добавляйте пробелы с обеих сторон знака #.
Примеры (Python 2.0+)
Запустить пример »
Результат вывода:
Hello, world
Поэтому, если ваш код содержит китайские символы, пока вы учитесь, вам нужно указать кодировку в начале.
Другие расширенияПримечание:Исходные файлы Python 3.x по умолчанию используют кодировку UTF-8, поэтому китайские символы можно нормально разобрать без указания кодировки UTF-8.
Примечание:Если вы используете редактор, вам также нужно установить формат сохранения py-файла в UTF-8, иначе вы получите сообщение об ошибке, подобное следующему:
SyntaxError: (unicode error) ‘utf-8’ codec can’t decode byte 0xc4 in position 0:
invalid continuation byte
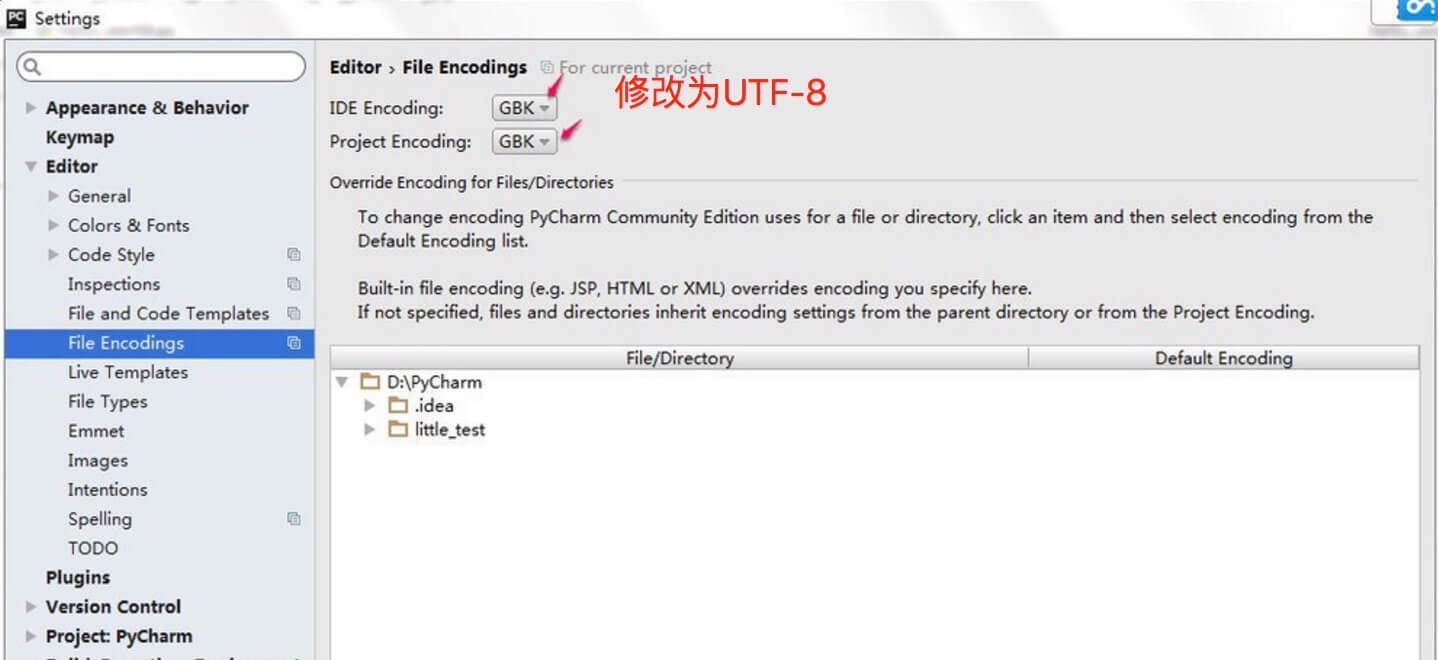
Шаги настройки PyCharm:
- Перейдите вfile > Settingsпоищите в поле вводаencoding。
- найдитеEditor > File encodingsустановитеIDE EncodingиProject Encodingв UTF-8.