Python 中国語エンコーディング
前の章では、Pythonを使用して出力する方法をすでに学びました"Hello, World!"、英語は問題ありませんが、中国語の文字を出力する場合は"こんにちは、世界"中国語のエンコーディングの問題に遭遇する可能性があります。
Pythonファイルでエンコーディングが指定されていない場合、実行中にエラーが発生します:
#!/usr/bin/python

print ("你好,世界")
上記プログラムの実行出力結果は次のとおりです:
  File "test.py", line 2
SyntaxError: Non-ASCII character '\xe4' in file test.py on line 2, but no encoding declared; see http://www.python.org/peps/pep-0263.html for details
Pythonのデフォルトのエンコーディング形式はASCII形式であり、エンコーディング形式を変更していない場合、漢字を正しく出力できないため、中国語を読み取る際にエラーが発生します。
解決方法は、ファイルの先頭に追加するだけです# -*- coding: UTF-8 -*-または# coding=utf-8でOKです
注意:# coding=utf-8の=#の両側にスペースを入れないでください。
例(Python 2.0+)
#!/usr/bin/python
# -*- coding: UTF-8 -*-
print( "你好,世界" )
例を実行 »
出力結果は次のとおりです:
こんにちは、世界
したがって、みなさんが学習中にコードに中国語が含まれる場合は、先頭でエンコーディングを指定する必要があります。
その他の拡張注意:Python3.Xのソースファイルはデフォルトでutf-8エンコーディングを使用するため、中国語を正常に解析でき、UTF-8エンコーディングを指定する必要はありません。
注意:エディタを使用する場合は、pyファイルの保存形式をUTF-8に設定する必要もあります。そうしないと、以下のようなエラーメッセージが表示されます:
SyntaxError: (unicode error) ‘utf-8’ codec can’t decode byte 0xc4 in position 0:
invalid continuation byte
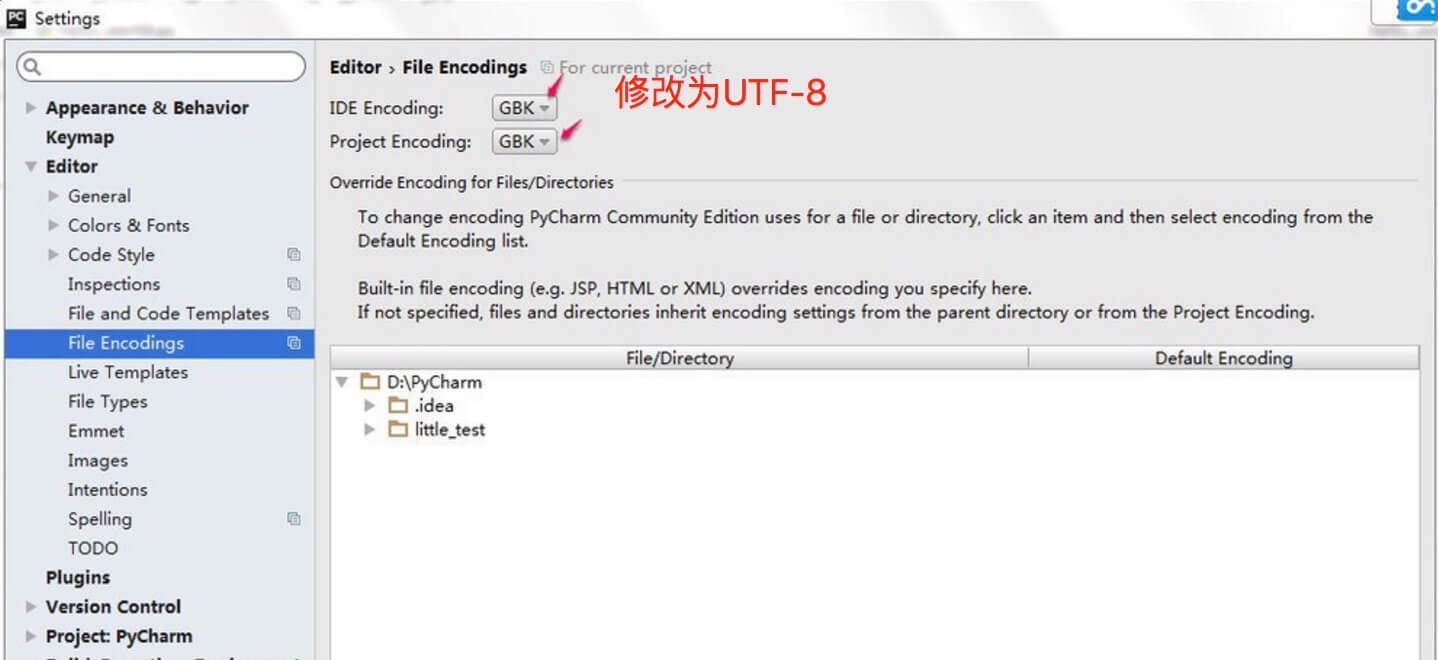
Pycharmの設定手順:
- 開いてfile > Settings、入力ボックスで検索してencoding。
- 見つけたらEditor > File encodings、それをIDE EncodingとProject Encodingutf-8に設定します。