AI Agent の動作原理
AI Agent を深く理解し始める前に、根本的な質問に答えましょう:LLM があるのに、なぜ Agent が必要なのか?
想像してみてください。あなたには非常に博学な友人がいるとします。彼は膨大な本を読み、ほとんどすべての質問に答えられますが、2024 年以降は新しい情報に触れておらず、携帯電話もなく、インターネットもできず、出前の注文もしてくれず、今日の天気も調べられません。これが大規模言語モデル(LLM)です。知識は豊富ですが、知識は学習データで止まっています能動的にリアルタイム情報を取得できず、具体的な操作も実行できません。
而 AI Agentまるでこの友人に、インターネットに接続できる携帯電話、電卓、カレンダーなどを与えたようなものです。彼は考えるだけでなく、実際に手を動かして物事を行うことができます。AI Agent は LLM とツール・記憶を組み合わせることで、この制限を突破し、以下を実現します。思考と行動の統一。
AI Agent の三大核心構成
典型的な AI Agent は、3 つの重要な部分が連携して動作します。上記の比喩を使って理解を続けましょう。
1、脳 (The Brain) - 大規模言語モデル (LLM)
- 役割:Agent の意思決定センターおよび推論エンジン。
- 機能:ユーザー入力の目標とコンテキストを理解し、現在の状況を分析して、次に何をするべきか(直接質問に答えるか、ツールを呼び出すか)を決定します。複雑なタスクの計画と分解を担当します。
- 比喩:会社のCEO または指揮官のようなもので、戦略的思考、タスク計画、指示の伝達を担当します。何をすべきかは分かっていますが、実際に実行するにはツールを借りる必要があります。
2、ツール (Tools) - 実行可能なアクション
- 役割:Agent の手と足であり、能力の延長です。
- 機能:具体的な関数や API のひとつひとつであり、Agent が外部世界とやり取りできるようにします。例えば:
search_web(ウェブ検索)、execute_python_code(コード実行)、read_file(ファイル読み取り)、send_email(メール送信)などです。 - 比喩:従業員の机の上にあるさまざまなオフィスソフトウェアやデバイスのようなものです。Excel、ブラウザ、電話、プリンターなどです。CEO(脳)が指示を出し、従業員(ツール)が実行を担当します。
- 重要な理解:ツールがなければ LLM は言うだけで、ツールがあって初めて Agent は実際に行うことができます。
3、記憶 (Memory) - 対話と経験の保存
- 役割:作業プロセスを記録し、タスクの一貫性を保証します。
- 機能:
- 短期記憶:現在の対話履歴を保存し、Agent が以前に何を言ったか、何をしたかを覚えているようにします。友達と話すとき、毎回自己紹介し直す必要がないのと同じです。
- 長期記憶:より永続的な情報(ユーザーの好み、過去のタスク結果など)を保存し、将来のタスクの参考にできます。あなた専用のユーザーファイルを持っているようなものです。
- 比喩:従業員の作業メモやプロジェクトファイルのようなもので、重複作業を避け、毎回の作業を以前の経験に基づいて前進させることができます。
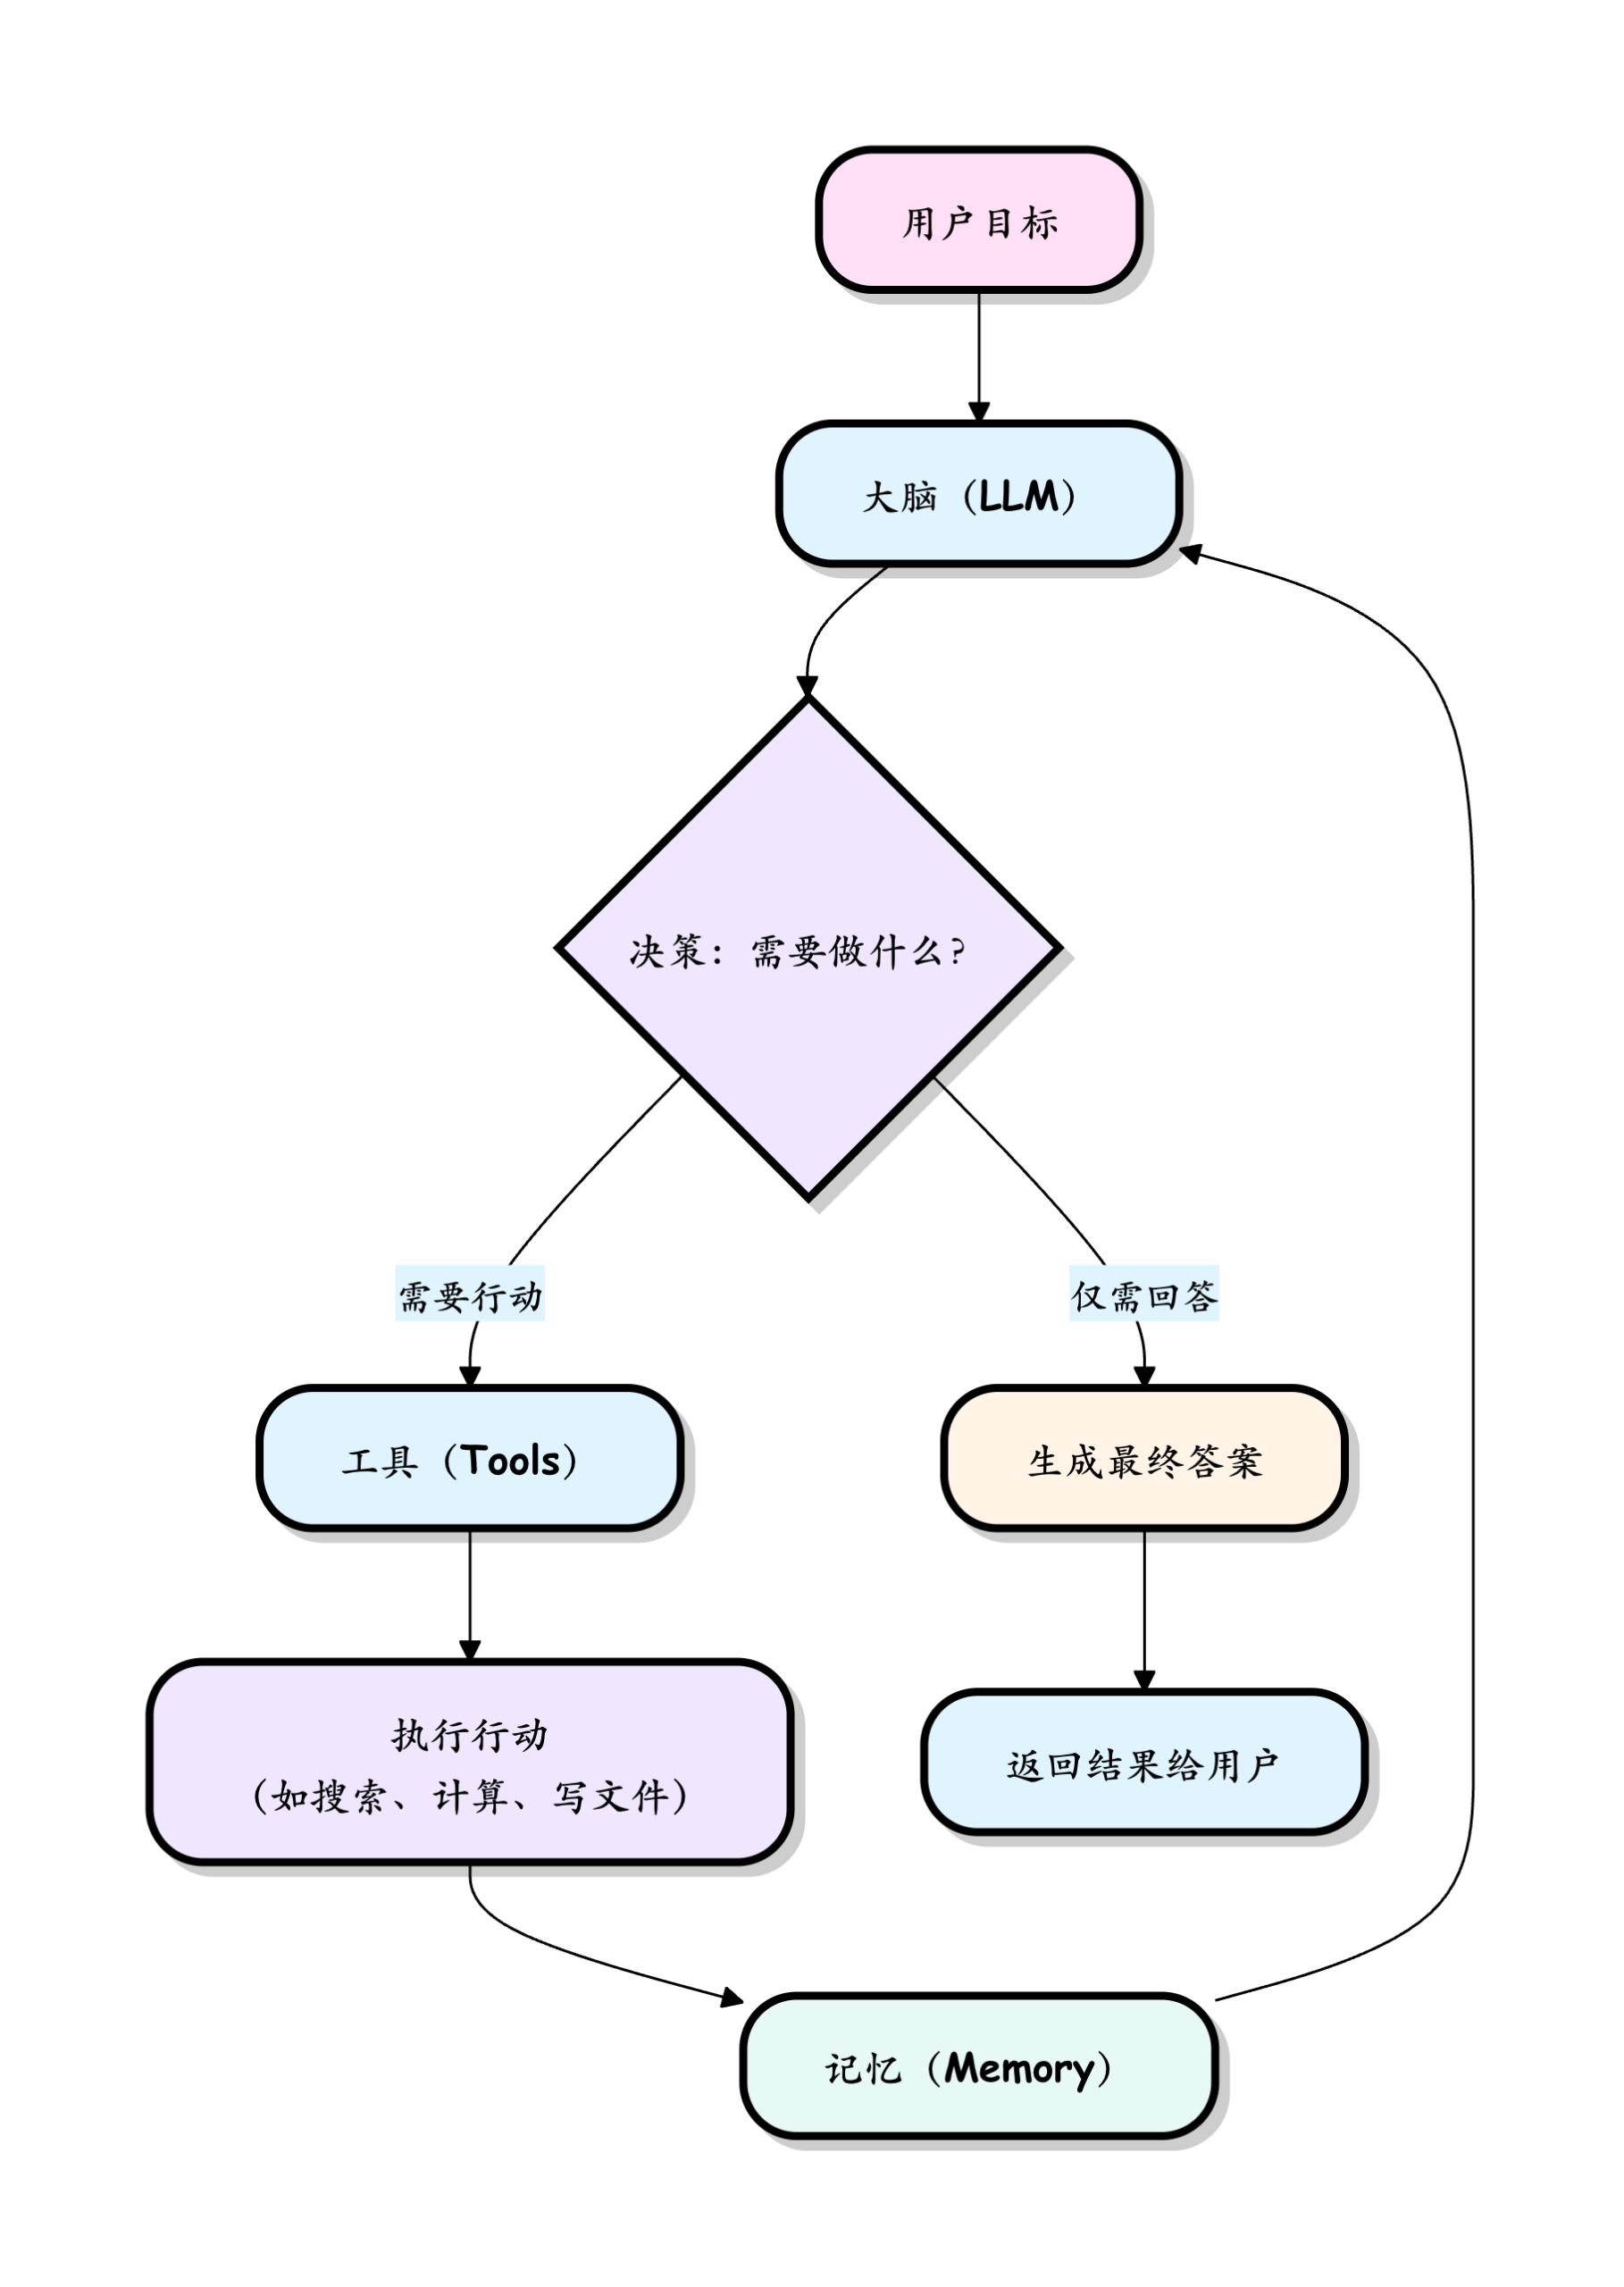
💡 一言でまとめると:脳は思考を担当し、ツールは行動を担当し、記憶は一貫性を保証します。この 3 つはどれも欠かせません。
AI Agent の種類
設計目標と複雑さに応じて、AI Agent はさまざまな種類に分類できます:
| Agent の種類 | 特徴 | 代表的な応用 |
|---|---|---|
| 反応型 Agent (Reactive Agent) | 現在の知覚に基づいて即座に応答し、内部状態を保持しません。目先のことだけを見て過去を覚えないカスタマーサービスのようなものです。 | 簡単な Q&A、ゲーム AI |
| 目標指向 Agent (Goal-based Agent) | 特定の目標を中心に行動を計画し、目標が達成されたかどうかを評価できます。KPI を持つ従業員のように、何の目標を達成するために何をしているのかを把握しています。 | タスクアシスタント、自動化ワークフロー |
| 実用型 Agent (Utility-based Agent) | 「効用関数」を使って複数の可能な行動にスコアを付け、最適な選択肢を選びます。利害を天秤にかけ、最適解を追求する意思決定者のようなものです。 | リソース最適化、経路計画 |
| 学習型 Agent (Learning Agent) | 経験から学習し、意思決定戦略を継続的に最適化できます。使うほど賢くなり、振り返りを怠らない従業員のようなものです。 | レコメンドシステム、パーソナライズアシスタント |
| マルチエージェントシステム (Multi-Agent) | 複数の Agent が協力して役割を分担し、それぞれが自分の責務を果たします。役割分担が明確なチームのように、各自が一部分を担当します。 | 複雑なタスク分解、チーム協力 |
初心者はまず最初の 2 つを習得するだけで十分です。それらは最も一般的な基本的な形態です。
ワークフロー:ReAct ループ
Agent の構成を理解したところで、次の質問は、それがどのように動き出すのかということです。
AI Agent は通常、ReAct = Reasoning(推論)+ Acting(行動)という古典的な思考パラダイムに従います。名前の通り、考えてから行動し、また考えてから行動する……このループをタスクが完了するまで繰り返します。
これは、責任感の強い新入社員がタスクを受け取ったときの仕事のやり方に例えられます:「どうやるかを考えて → 資料を調べに行って → 何が分かったかを見て → 次のステップを考えて → また行動する……」と、思い付きで適当にやるのではありません。
SVG 可視化:ReAct ループのフローチャート完全な例を使ってこのループを追跡する
ユーザーが Agent に指令を出します:「北京で評価が 4.5 以上のイタリアンレストランを探して、その住所と名物料理を教えてください。」
それでは、Agent の「思考」に一歩ずつ従ってみましょう:
ステップ 1:思考 (Think/Reason)
- 脳が目標を分析する:Agent の脳(LLM)はこのタスクを受け取ると、まず頭の中で整理します:「これは情報検索タスクで、2 種類の情報が必要です。① 条件に合うレストランを見つける、② 住所と名物料理を取得する。私は今何も知らないので、まず検索すべきだ。」
- 行動指示を生成する:脳が決定します:「
search_webツールを呼び出して、キーワードを「北京 イタリアンレストラン 評価 4.5 以上」に設定します。」
💡 注意:このステップでは、Agent はまだ「何もしていません」。ただ「考えている」だけです。LLM の価値はまさにここにあります。意図を理解し、タスクを分解し、計画を立てることができるのです。
ステップ2: 行動 (Act)
- ツールを呼び出す:Agent は前のステップの決定に基づいて、実際にツールを
search_web呼び出し、キーワードを渡します。 - ツールの実行:検索ツールはインターネット上で検索を実行し、生の検索結果(Webページのタイトル、概要、リンクなど)を返します。
💡 注意:ツール自体は「考え」ません。ツールは忠実に実行するだけです。考えるのは脳の仕事であり、実行するのはツールの仕事です。役割分担が明確です。
ステップ3: 観察 (Observe)
- フィードバックを受け取る:Agent はツールが返した検索結果を取得し、結果をメモリに保存し、次の推論ラウンドで使用できるようにします。
- 検索結果にはいくつかのレストランが含まれているとします:Bottega 意库(評価 4.7)、Da Vittorio、Le Marche など。
ステップ4: 再思考 (Think Again)
- 脳の再分析:検索結果を見た後、脳はさらに推論を続けます:「よし、候補のレストランをいくつか見つけた。しかしユーザーが求めているのは住所と看板メニューで、これらは検索サマリーにはない。Bottega 意库の詳細情報をさらに調べる必要がある。」
- 新しい指示を生成する:「ツールを
get_restaurant_details呼び出して、『Bottega 意库』の詳細情報を照会します。」
ステップ5: 再行動 → 再観察(ループ継続)
- この思考 → 行動 → 観察というループは繰り返され、毎回 Agent を目標に一歩ずつ近づけます。脳が「ユーザーに答えるための十分な情報が得られた」と判断するまで続きます。
ステップ6: 最終回答の出力 (Final Answer)
- 脳がタスク完了を確認すると、収集したすべての情報(メモリに保存されている)を統合し、構造化された人間らしい応答を生成します:
- 「条件に合うレストランを見つけました:Bottega 意库(評価 4.7)。住所:北京市朝陽区三里屯路 XX 号。看板メニュー:黒トリュフピザ、手作りティラミス。」
この思考 → 行動 → 観察 → 再思考…というループこそ、AI Agent が複雑なタスクを自律的に完了するための中核となる駆動メカニズムです。一度に答えを出すのではなく、人間のように段階的に進め、やりながら考える。
Python で AI Agent を実装する
理論は説明し終えたので、次にコードを見てみましょう。AI Agent システムは通常、いくつかのコアモジュールが協調して動作します。このアーキテクチャを理解することで、Agent がどのように考え行動するのかを把握できます。

各モジュールを分解して、簡単な Python コードでその役割を示します。初心者はすべてのコード行を深く追う必要はありません。重要なのは各モジュールが何をしているかを理解することです。。
1. 感知モジュール —— Agent の「目と耳」
知覚モジュールは環境から情報を取得します。つまり「どのような入力を受け取ったか」です。環境には次のものがあります:
- デジタル世界:テキスト、Webページ、データベースのレコード、API が返すデータ。
- 物理世界(ハードウェア経由):カメラ画像、マイク音声、センサーデータ。
最も一般的なテキスト型 Agent の場合、知覚とは「ユーザーが入力した一文を受け取る」ことです。
サンプル
def perceive_from_environment():
"""
環境から情報を知覚します。
この例では、環境とはコマンドラインでユーザーが入力したテキストです。
"""
user_input = input("指示または質問を入力してください:")
print(f"[知覚モジュール] 情報を受信しました:'{user_input}'")
return user_input # 知覚した内容を次のモジュール(意思決定モジュール)に渡す
# 知覚情報を取得する
current_observation = perceive_from_environment()
2. 決定モジュール(脳)—— Agent の「指揮官」
これは Agent の核心であり、通常はAI モデル(大規模言語モデル LLM など)によって駆動されます。知覚モジュールから渡された情報を受け取り、次の3つのことを行います:
- 理解:この情報はどういう意味か? ユーザーは何を求めているか?
- 推論:現在の状況で、どう行動すべきか?
- 計画:次のステップ(または今後数ステップ)でどのツールを呼び出し、どの操作を行うべきか?
以下のコードは、最も簡単な「キーワードマッチング」で意思決定プロセスをシミュレートしています。実際の Agent では、このステップは LLM によって行われ、はるかに複雑な意味理解を処理できます。
サンプル
def make_decision(observation):
"""
知覚情報に基づいて簡単な意思決定を行います。
ここではキーワードマッチングでシミュレートしていますが、実際には LLM がより複雑な推論を行います。
"""
print(f"[意思決定モジュール] 情報を分析中:'{observation}'")
# ユーザー入力のキーワードに基づいて、どのツールを呼び出すべきか判断する
if "天気" in observation:
decision = "天気検索ツールを呼び出します"
elif "計算" in observation:
decision = "計算機ツールを呼び出します"
elif "終了" in observation:
decision = "終了アクションを実行します"
else:
decision = "一般的な対話応答を行います" # ツールにマッチしなければ、直接対話する
print(f"[意思決定モジュール] 意思決定結果:{decision}")
return decision # 意思決定結果を行動モジュールに渡す
# 知覚に基づいて意思決定する
current_decision = make_decision(current_observation)
3. 行動モジュール —— Agent の「実行者」
意思決定モジュールが出力するのは「考え」(何をするか)であり、行動モジュールはその考えを「現実」(実際に行うこと)に変える役割を担います。具体的な操作を実行して外部環境に影響を与えます。一般的な行動には次のものがあります:
- デジタル行動:画面上に回答を出力する、関数を呼び出す、API リクエストを送信する、ファイルに書き込む。
- 物理行動(ハードウェアの制御による):ロボットアームの動きを制御する、スピーカーで音声を再生する。
サンプル
def execute_action(decision):
"""
意思決定モジュールから与えられた指示を実行し、実行結果を返します。
実行結果はメモリに保存され、次の推論ラウンドで使用されます。
"""
print(f"[行動モジュール] 実行中:{decision}")
if decision == "天気検索ツールを呼び出します":
# ここは実際の天気 API 呼び出しに置き換えることができます
result = "北京:晴れ、25℃。"
elif decision == "計算機ツールを呼び出します":
result = "1+1=2"
elif decision == "終了アクションを実行します":
result = "タスク終了。"
print(result)
exit() # プログラム全体を終了する
else:
result = f"ご意図を理解しました:'{decision}'"
print(f"[行動モジュール] 行動結果:{result}")
return result # 結果を返し、「観察」フェーズに入る
# 決定を実行して、結果を得る
action_result = execute_action(current_decision)
4. 記憶モジュール —— Agent の「仕事のメモ」
メモリがなければ、Agent は毎回「記憶喪失」状態で応答します——あなたが以前に何を言ったかも、自分が何をしたかも忘れてしまいます。メモリモジュールはこの問題を解決します。メモリには2種類あります:
- 短期メモリ / 会話履歴:今回の会話で話した内容を記録し、Agent がマルチターン会話で一貫性を保つようにします。友人と話すとき、毎文の背景を説明し直す必要がないのと同じです。
- 長期メモリ / 知識ベース:ベクトルデータベースなどの技術を通じて保存された専用知識(例:社内文書、ユーザーの好み)であり、モデルの能力を強化するために使用されます。初心者はひとまずこの部分を無視して、まず短期メモリを理解すれば十分です。
以下の完全な例では、Python のリストを使って短期メモリをシミュレートします。
5. ツールモジュール —— Agent の「スイスアーミーナイフ」
モデル自体の能力には限界があります(例:リアルタイムの天気を知らない、複雑な計算ができない、ファイルを操作できない)。ツールモジュールは Agent に「外部スキル」のセットを提供し、能力の範囲を大幅に拡張します。ツールは Python 関数、サードパーティ API、または完全な外部ソフトウェアの場合があります。
以下は最も簡単なツールの例です:
サンプル
def calculator_tool(expression):
"""
数式の文字列を受け取り、計算結果を返します。
これが「ツール」です——Agent の脳が必要に応じて呼び出すのを待っています。
"""
try:
# 注意:eval() は本番環境ではセキュリティリスクがあります。ここではデモのみを目的としています。
result = eval(expression)
return f"計算結果:{expression} = {result}"
except Exception as e:
return f"計算エラー:{e}"
# シミュレーション:脳が決定した後、このツールを呼び出す
tool_result = calculator_tool("3 + 5 * 2")
print(tool_result) # 出力:計算結果:3 + 5 * 2 = 13
# 注意:Python は乗算と除算を加算と減算より先に計算するため、3 + 10 = 13 となり、8 * 2 = 16 にはなりません。
実践演習:シンプルなコマンドライン AI Agent を構築する
上記では各モジュールを個別に紹介しました。ここで、それらを組み合わせて、継続的な対話とツール呼び出しができる完全なミニエージェントを作成しましょう。
実行する前に、まずこの構造を頭の中で確認してください:
- ユーザー入力 →知覚 → 意思決定(キーワードマッチング)→行動(ツール呼び出しまたは対話)→ 出力結果 →記憶(履歴に保存)→ 次の入力待ち
サンプル
import random
# ==================== ツール定義 ====================
def get_weather(city):
"""ツール1:天気照会のシミュレーション(実際には実際の天気APIに置き換え可能)"""
weather_options = ["晴れ", "曇り", "小雨", "強風"]
temperature = random.randint(15, 35)
return f"{city}の天気は{random.choice(weather_options)}、気温{temperature}℃です。"
def simple_calculator(a, b, operator):
"""ツール2:簡易計算機"""
if operator == '+':
return f"{a} + {b} = {a + b}"
elif operator == '-':
return f"{a} - {b} = {a - b}"
else:
return "この演算は現在サポートされていません。"
# ==================== 記憶(短期)====================
# リストで対話履歴をシミュレートし、各項目は文字列
conversation_history = []
# ==================== Agent メインループ ====================
def run_simple_agent():
print(【シンプルAIエージェント起動】終了と入力すると対話を終了します。)
print("ヒント:天気を尋ねる(例:「北京の天気」)か、計算を行う(例:「計算1+1」)ことができます。\n")
while True:
# ---- 知覚フェーズ:ユーザー入力を取得 ----
user_input = input("あなた:")
conversation_history.append(f"ユーザー:{user_input}")
# 特別な指示:終了
if user_input.lower() in ["終了", "exit", "quit"]:
print("Agent:さようなら!")
break
# ---- 意思決定 + 行動フェーズ:入力に基づいてツールまたは対話を選択 ----
response = ""
if "天気" in user_input:
# 入力から都市名の識別を試み、デフォルトは北京
city = "北京"
for c in ["北京", "上海", "広州", "深セン"]:
if c in user_input:
city = c
break
# 天気ツールを呼び出す
response = get_weather(city)
elif "計算" in user_input or "+" in user_input or "-" in user_input:
# 単純なパターンマッチングで、いくつかの固定された計算式を認識
if "1+1" in user_input:
response = simple_calculator(1, 1, '+')
elif "10-5" in user_input:
response = simple_calculator(10, 5, '-')
else:
response = "「計算1+1」または「計算10-5」と入力してみてください。"
else:
# ツールにマッチしない場合は、通常の対話にフォールバック
default_responses = [
"おっしゃる意味を理解しました。",
"これは面白い話題ですね!",
私の現在のスキルは限られています。天気や簡単な計算を試してみてください。,
"うん、続けてください。"
]
response = random.choice(default_responses)
# ---- 出力 + 記憶フェーズ:返信を表示し、履歴に保存 ----
print(f"Agent:{response}")
conversation_history.append(f"Agent:{response}")
# 対話終了後、完全な対話履歴を表示(短期記憶の内容をシミュレート)
print("\n=== 今回の対話履歴(短期記憶の内容) ===")
for line in conversation_history:
print(line)
# Agent を起動
if __name__ == "__main__":
run_simple_agent()
このプログラムを実行すると、次のようなことを体験できます:
- 継続的に多輪対話ができるループ(知覚モジュールが絶えず動作します)。
- 入力キーワード(例:「天気」「計算」)に基づいてさまざまなツールが自動的に起動される(行動モジュール)。
- 対話終了後、完全な対話履歴を確認できる(記憶モジュール)。
💡 考えてみてください:このエージェントをさらに強力にしたい場合は、次のことを試せます:① ツールを追加する(例:為替レートの確認、翻訳);② 意思決定モジュールのキーワードマッチングを実際のLLM API呼び出しに置き換えると、エージェントは自然言語を理解できるようになります!
まとめと展望
この記事を通じて、AIエージェントの基本概念をすでに習得できているはずです:
- それは知覚、意思決定(脳)、行動、記憶、ツールなどのモジュールから構成されるインテリジェントなプログラムです;
- それはReActループ(思考 → 行動 → 観察 → 再思考)を通じて自律的に目標を追求します;
- LLMはその頭脳であり、ツールは手足、記憶は一貫性を保ちます。
核心を一言で覚える:LLMは「話す」だけで、Agentは「実行できる」。
次のステップの学習アドバイス
- 大規模言語モデル(LLM)APIを深く学ぶ:OpenAI GPT、DeepSeek、通义千问などのモデルのAPI呼び出し方法を学び、それらをエージェントの真の頭脳として使って、サンプル内の簡素なキーワードマッチングを置き換えましょう。
- Agent開発フレームワークを学ぶ:探索するLangChain、LlamaIndex 或 AutoGenなどの成熟したフレームワーク。これらは記憶、ツールチェーン、タスクオーケストレーションなどのモジュールをすべてカプセル化しているため、これらを使えば労力は半分で効果は2倍になり、車輪の再発明を避けられます。
- 実際のツールを統合する:エージェントをデータベース、メールシステム、天気サービスなどの実際のAPIに接続して、現実の問題を解決してみましょう。このステップにより、「ツール」の概念を新たに体感できるはずです。
- プロンプトエンジニアリング(Prompt Engineering)を学ぶ:LLMに高品質な「指示」を書く方法は、エージェントの頭脳の発揮レベルを直接決定します。これは効率的なAgentを開発する上で無視できない重要なスキルです。
AIエージェントの世界は広大で可能性に満ちています。自動化されたパーソナルアシスタントからエンタープライズ向けインテリジェントソリューションまで、人とコンピュータの相互作用の新しいパラダイムになりつつあります。この記事を出発点に、自分自身のインテリジェントエージェントの構築を始めてください。
その他の拡張