Fichiers CSV en R
En tant qu'outil statistique professionnel, si R ne pouvait importer et exporter des données que manuellement, ses fonctionnalités n'auraient plus de sens. Par conséquent, R prend en charge la récupération par lots de données à partir de fichiers de format de stockage tabulaire courants (tels que CSV, Excel, XML, etc.).
Interaction avec les tableaux CSV
CSV (Comma-Separated Values, CSV, parfois aussi appelé valeurs séparées par des caractères car le caractère séparateur ne doit pas nécessairement être une virgule) est un format de fichier de stockage tabulaire très populaire, adapté au stockage de données de petite ou moyenne taille.
Étant donné que la plupart des logiciels prennent en charge ce format de fichier, il est souvent utilisé pour le stockage et l'échange de données.
CSV est essentiellement du texte, et son format de fichier est extrêmement simple : les données sont enregistrées ligne par ligne sous forme de texte, chaque enregistrement est séparé en champs par des délimiteurs, et chaque enregistrement a la même séquence de champs.
Ce qui suit est un simple fichier sites.csv (stocké dans le même répertoire que le programme de test) :
id,name,url,likes
1,Google,www.google.com,111
2,Example,www.example.com,222
3,Taobao,www.taobao.com,333
CSV utilise des virgules pour séparer les colonnes. Si les données contiennent des virgules, le bloc de données entier doit être placé entre guillemets doubles.
Remarque :Pour du texte contenant des caractères non anglais, faites attention à l'encodage enregistré. Comme de nombreux ordinateurs utilisent couramment l'encodage UTF-8, je l'ai enregistré en UTF-8.
Remarque :La dernière ligne du fichier CSV doit conserver une ligne vide ; sinon, le programme produira un message d'avertissement.
Warning message:
In read.table(file = file, header = header, sep = sep, quote = quote,  :
  incomplete final line found by readTableHeader on 'sites.csv'

Lecture des fichiers CSV
Ensuite, nous pouvons utiliser la fonction read.csv() pour lire les données d'un fichier CSV :
Exemple
print(data)
Si l'attribut encoding n'est pas défini, la fonction read.csv effectuera la lecture en utilisant l'encodage de texte par défaut du système d'exploitation. Si vous utilisez la version chinoise de Windows et que vous n'avez pas défini l'encodage par défaut du système, alors l'encodage par défaut du système devrait être GBK. Par conséquent, essayez autant que possible d'unifier l'encodage du texte afin d'éviter les erreurs.
L'exécution du code ci-dessus produit la sortie suivante :
  id   name            url likes
1  1 Google www.google.com   111
2  2 Example www.example.com   222
3  3 Taobao www.taobao.com   333
La fonction read.csv() renvoie un data frame, ce qui nous permet d'effectuer commodément un traitement statistique sur les données. Dans l'exemple suivant, nous affichons le nombre de lignes et de colonnes :
Exemple
print(is.data.frame(data)) # Vérifier s'il s'agit d'un data frame
print(ncol(data)) # Nombre de colonnes
print(nrow(data)) # Nombre de lignes
L'exécution du code ci-dessus produit la sortie suivante :
[1] TRUE
[1] 4
[1] 3
Voici les données avec le champ likes maximal dans le data frame :
Exemple
# Données avec le maximum de likes
like <- max(data$likes)
print(like)
L'exécution du code ci-dessus produit la sortie suivante :
[1] 333
Nous pouvons également spécifier des conditions de recherche pour interroger des données similaires à la clause WHERE de SQL. La fonction à utiliser estsubset()。
L'exemple suivant recherche les données dont likes est égal à 222 :
Exemple
# Données avec likes égal à 222
retval <- subset(data, likes == 222)
print(retval)
L'exécution du code ci-dessus produit la sortie suivante :
  id   name            url likes
2  2 Example www.example.com   222
Remarque: Les instructions conditionnelles utilisent égal à==。
Plusieurs conditions utilisent&comme séparateur. L'exemple suivant recherche des données où likes est supérieur à 1 et name est Example :
Exemple
# Données avec likes > 1 et name Example
retval <- subset(data, likes > 1 & name=="Example")
print(retval)
L'exécution du code ci-dessus produit la sortie suivante :
  id   name            url likes
2  2 Example www.example.com   222
Enregistrer en tant que fichier CSV
Le langage R peut utiliser la fonctionwrite.csv()pour enregistrer les données dans un fichier CSV.
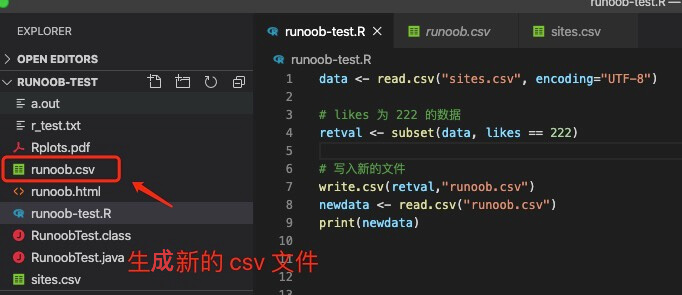
En poursuivant l'exemple ci-dessus, nous enregistrons les données dont la valeur de likes est égale à 222 dans le fichier example.csv :
Exemple
# Données avec likes égal à 222
retval <- subset(data, likes == 222)
# Écrire dans un nouveau fichier
write.csv(retval,"example.csv")
newdata <- read.csv("example.csv")
print(newdata)
L'exécution du code ci-dessus produit la sortie suivante :
 X id   name            url likes
1 2  2 Example www.example.com   222
X vient du jeu de données newper, et il peut être supprimé à l'aide du paramètre row.names = FALSE :
Exemple
# Données avec likes égal à 222
retval <- subset(data, likes == 222)
# Écrire dans un nouveau fichier
write.csv(retval,"example.csv", row.names = FALSE)
newdata <- read.csv("example.csv")
print(newdata)
L'exécution du code ci-dessus produit la sortie suivante :
  id   name            url likes
1  2 Example www.example.com   222
Après l'exécution, nous pouvons voir que le fichier example.csv est généré :