Tri de Shell
Le tri de Shell est une version améliorée efficace du tri par insertion, proposé par Donald Shell en 1959.
L'idée centrale du tri de Shell estEn divisant la liste d'origine en plusieurs sous-séquences, d'effectuer d'abord un tri par insertion sur chaque sous-séquence, puis de réduire progressivement l'intervalle entre les sous-séquences, et enfin d'effectuer un tri par insertion standard sur la liste entière.Cette méthode permet aux éléments de se déplacer sur de grands écarts, éliminant ainsi un grand nombre d'inversions dès les premières étapes et améliorant considérablement l'efficacité du tri.
Imaginez que vous triez un jeu de cartes mélangé. Le tri par insertion consiste à prendre les cartes une par une et à insérer chacune à la bonne position dans la main déjà triée. Le tri de Shell, quant à lui, consiste d'abord à tirer une carte toutes les quelques cartes pour former un petit paquet, puis à le trier, puis à réduire l'intervalle de tirage et à répéter le processus. Lorsque l'intervalle est réduit à 1, cela devient un tri par insertion standard, mais à ce moment-là la séquence entière est déjà pratiquement ordonnée, donc le tri par insertion final sera très rapide.
Fonctionnement
La clé du tri de Shell réside dans ce que l'on appelleséquence d'incrémentsLe concept. La séquence d'incréments détermine l'intervalle de division des sous-séquences à chaque fois. L'algorithme effectue plusieurs tours de tri sur la liste selon une séquence d'incréments progressivement décroissante.
Étapes de l'algorithme
- Sélectionnez la séquence d'incréments.Déterminez une séquence d'entiers du plus grand au plus petit, et le dernier incrément doit être 1. L'incrément initial le plus couramment utilisé est la moitié de la longueur du tableau, puis il est divisé par deux à chaque fois.
- Regrouper par incrément: pour l'incrément courant
gap, divisez la liste entière engapsous-séquences. Chaque sous-séquence est constituée de tous les éléments avec un intervalle degapLa composition des éléments. - effectuer un tri par insertion sur les sous-séquencesEffectuez un tri par insertion sur chaque sous-séquence séparément.
- Réduire l'incrémentObtenez un nouvel incrément, plus petit, et répétez les étapes 2 et 3.
- Tri finalLorsque l'incrément est réduit à 1, effectuez un tri par insertion standard sur la liste entière ; à ce stade, la liste est déjà pratiquement ordonnée, donc le tri se termine rapidement.
Applicabilité
La complexité temporelle du tri de Shell estO(n^(1.3-2)), et la complexité spatiale est d'ordre constantO(1). Le tri de Shell n'est pas aussi rapide queO(n(logn))le tri rapide est rapide, donc il donne de bons résultats pour des échelles moyennes, mais ce n'est pas le choix optimal pour trier de très grands ensembles de données. En bref, comparé auxO(n^2 )algorithmes ordinaires ayant cette complexité temporelle sont bien plus rapides.
Diagramme du processus
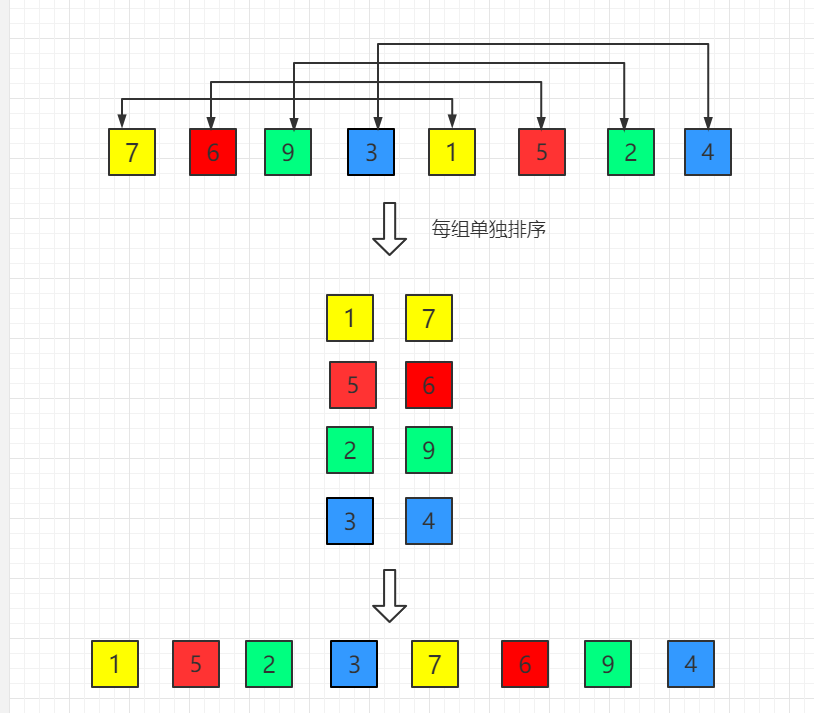
Le but du tri de Shell est d'améliorer le tri par insertion pour une plus grande rapidité. Il échange des éléments non adjacents pour trier des parties du tableau, et utilise finalement le tri par insertion pour trier le tableau localement ordonné.
Ici, nous choisissons l'incrémentgap=length/2, réduisons l'incrément àgap = gap/2méthode, en utilisant la séquence{n/2,(n/2)/2...1}pour représenter.
Comme le montre l'exemple :
(1) Le premier passage avec l'incrément initialgap = length/2 = 4
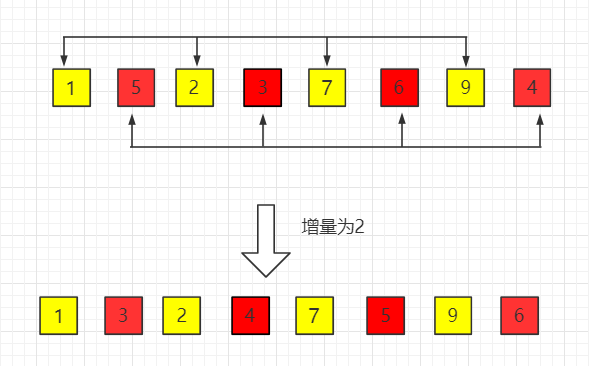
(2) Le deuxième passage, l'incrément est réduit à 2
(3) Le troisième passage, l'incrément est réduit à 1, obtenant le résultat final trié

Exemple de code Java
Téléchargement du paquet de code source :Télécharger
La boucle la plus interne est en fait un tri par insertion :
Code du fichier ShellSort.java :
// Code principal --- début
public static void sort(Comparable[] arr) {
int j;
for (int gap = arr.length / 2; gap > 0; gap /= 2) {
for (int i = gap; i < arr.length; i++) {
Comparable tmp = arr[i];
for (j = i; j >= gap && tmp.compareTo(arr[j - gap]) < 0; j -= gap) {
arr[j] = arr[j - gap];
}
arr[j] = tmp;
}
}
}
// Code principal --- fin
public static void main(String[] args) {
int N = 2000;
Integer[] arr = SortTestHelper.generateRandomArray(N, 0, 10);
ShellSort.sort(arr);
for( int i = 0 ; i < arr.longueur ; i ++ ){
System.out.print(arr[i]);
System.out.print(' ');
}
}
}
Implémentation de l'algorithme en Python
Nous utiliserons Python pour implémenter le tri de Shell, et adopterons le paramètre d'incrément le plus courant (séquence originale de Shell) :gap = n // 2, et continuer àgapeffectuer une division entière par 2, jusqu'àgapest 1.
Exemple
"""
Utiliser l'algorithme de tri de Shell pour trier la liste par ordre croissant sur place.
Paramètres :
arr (list) : La liste à trier.
Retourne :
list : La liste triée (modifiée sur place, également renvoyée).
"""
n = len(arr)
# Définir l'écart d'incrément initial à la moitié de la longueur du tableau
gap = n // 2
# Boucler jusqu'à ce que l'écart soit réduit à 0
while gap > 0:
# En partant de l'écart, effectuer un « tri par insertion » sur chaque élément
# Remarque : ici i va de gap à n-1, en itérant sur tous les éléments
for i in range(gap, n):
# Enregistrer arr[i] dans une variable temporaire temp
temp = arr[i]
j = i
# Effectuer un tri par insertion sur la sous-séquence correspondant à l'écart actuel
# Si l'élément précédent dans la même sous-séquence est supérieur à temp, le déplacer vers l'arrière
while j >= gap and arr[j - gap] > temp:
arr[j] = arr[j - gap]
j -= gap
# Insérer temp à la position correcte
arr[j] = temp
# Réduire l'incrément, p. ex. diviser le gap par deux
gap //= 2
return arr
# Code de test
if __name__ == "__main__":
# Données de test 1 : ordre aléatoire mélangé
test_array = [8, 3, 5, 1, 4, 2, 7, 6]
print("Avant le tri :", test_array)
sorted_array = shell_sort(test_array.copy()) # Utiliser copy pour éviter de modifier le tableau d'origine
print("Après le tri :", sorted_array)
# Données de test 2 : contient des éléments en double
test_array2 = [5, 2, 9, 5, 2, 3, 5]
print("\nAvant le tri :", test_array2)
print("Après le tri :", shell_sort(test_array2.copy()))
# Données de test 3 : tableau inversé
test_array3 = [10, 9, 8, 7, 6, 5, 4, 3, 2, 1]
print("\nAvant le tri :", test_array3)
print("Après le tri :", shell_sort(test_array3.copy()))
Analyse du code :
def shell_sort(arr):Définir la fonction de tri de Shell.n = len(arr)Obtenir la longueur du tableau.gap = n // 2Initialiser l'incrément. C'est le point de départ le plus classique pour la séquence d'incréments dans le tri de Shell.while gap > 0:Boucle externe, contrôlant l'incrément pour qu'il diminue progressivement jusqu'à devenir 0 (après avoir effectivement été 1 et terminé l'exécution,gap //= 2il devient 0 et sort).for i in range(gap, n):Boucle interne. En partant de l'indicegapCommencer le parcours.ipointe vers l'élément actuel à insérer. Notez que cette boucle gère astucieusement tous les éléments avecgapsous-séquences avec ... comme intervalle.temp = arr[i]etj = i: enregistrer la valeur de l'élément courant, et utiliserjpour enregistrer la position où il doit être inséré dans la sous-séquence courante.while j >= gap and arr[j - gap] > temp:C'est le cœur du tri par insertion. Au sein de la même sous-séquence (enj - gapindexant pour accéder à l'élément précédent), si l'élément précédent est plus grand quetemps'il est plus grand, déplacer l'élément précédent vers l'arrièregapposition.arr[j] = temp: la valeur enregistréetempinsérer la valeur à la position correcte.gap //= 2Après une passe de tri, diviser l'incrément par deux et effectuer la passe suivante de tri plus fin.return arr: renvoyer le tableau trié.
Sélection de la séquence d'incréments.
Le choix de la suite d'incréments affecte les performances du tri de Shell. Ci-dessus, nous avons utilisé la suite originale de Shell (n/2, n/4, ..., 1, mais elle n'est pas optimale. Voici plusieurs suites d'incréments courantes :
| Nom de la suite | Formule de génération | Caractéristiques et avantages. |
|---|---|---|
| Suite originale de Shell | $gap = \lfloor \frac{n}{2} \rfloor, gap = \lfloor \frac{gap}{2} \rfloor...$ | Simple à implémenter, avec une complexité temporelle dans le pire des cas de $O(n^2)$. |
| Suite de Hibbard | $1, 3, 7, 15, ..., 2^k - 1$ | La complexité temporelle dans le pire des cas peut être améliorée jusqu'à $O(n^{3/2})$. |
| Suite de Knuth | $1, 4, 13, 40, ..., (3^k - 1) / 2$ (inférieurs à n) | La complexité temporelle moyenne est d'environ $O(n^{1.25})$, et elle est couramment utilisée en pratique. |
| Séquence de Sedgewick | $1, 5, 19, 41, 109, ...$ (un mélange de $9 \times 4^k - 9 \times 2^k + 1$ et $4^k - 3 \times 2^k + 1$) | C'est l'une des séquences les plus connues, avec une complexité dans le pire des cas atteignant $O(n^{4/3})$. |
Exemple d'implémentation utilisant la séquence de Knuth
Exemple
n = len(arr)
# Générer la séquence d'incréments de Knuth : 1, 4, 13, 40, 121, ...
gap = 1
while gap < n // 3:
gap = 3 * gap + 1 # Générer l'incrément initial maximal
while gap > 0:
for i in range(gap, n):
temp = arr[i]
j = i
while j >= gap and arr[j - gap] > temp:
arr[j] = arr[j - gap]
j -= gap
arr[j] = temp
gap //= 3 # Knuth suggère de diviser par 3 à chaque fois
return arr
# Tester la version de la séquence de Knuth
test_array = [33, 12, 56, 78, 2, 45, 67, 89, 1, 23]
print(Avant le tri avec la séquence de Knuth :, test_array)
print(Après le tri avec la séquence de Knuth :, shell_sort_knuth(test_array.copy()))
Caractéristiques de l'algorithme et analyse de complexité
Complexité temporelle
L'analyse de la complexité temporelle du tri de Shell est très complexe car elle dépend de la séquence d'incréments choisie.
- Pire casLorsque l'on utilise la séquence originale de Shell, la complexité temporelle dans le pire cas est $O(n^2)$.
- Cas moyen: Pour de meilleures séquences d'incréments (telles que Knuth, Sedgewick), la complexité temporelle moyenne est comprise entre $O(n^{1.25})$ et $O(n^{1.5})$.
- Meilleur casLorsque le tableau est déjà trié, la complexité peut s'approcher de $O(n \log n)$.
Complexité spatiale
- Le tri de Shell estun algorithme de tri en place, nécessitant uniquement une quantité constante d'espace supplémentaire (comme
temp,gap,i,jdes variables), donc la complexité spatiale est $O(1)$.
Stabilité
- Le tri de Shell est un algorithme de triinstable. Car lorsque l'on trie par groupes selon l'incrément, des éléments égaux peuvent être placés dans différentes sous-séquences et leur ordre relatif peut être modifié en raison des déplacements.
Comparaison simple avec d'autres algorithmes de tri
| Fonctionnalités | Tri de Shell | Tri par insertion | Tri par fusion | Tri rapide |
|---|---|---|---|---|
| Complexité temporelle moyenne. | $O(n^{1.25})$ ~ $O(n^{1.5})$ | $O(n^2)$ | $O(n \log n)$ | $O(n \log n)$ |
| Complexité spatiale | $O(1)$ | $O(1)$ | $O(n)$ | $O(\log n)$ |
| Stabilité | instable | Stable | Stable | instable |
| Avantages | Bonnes performances pour des données de taille moyenne, tri en place | Simple, efficace pour de petites données ou des données presque triées | Stable, excellente complexité temporelle | Le plus rapide dans les cas moyens. |
| Inconvénients | L'analyse de complexité est difficile, et le choix de la séquence d'incréments a un grand impact. | Faible efficacité avec de grands volumes de données. | Nécessite de l'espace supplémentaire. | Dans le pire des cas, il dégénère en $O(n^2)$. |