Tutorial de Ollama
Ollama es un framework de ejecución local de código abierto para modelos de lenguaje grandes, diseñado específicamente para implementar y ejecutar modelos de lenguaje grandes (LLM) de manera conveniente en máquinas locales.
Ollama admite múltiples sistemas operativos, incluyendo macOS, Windows, Linux, y también se puede ejecutar mediante contenedores Docker.
En términos simples, si servicios como ChatGPT, Claude y DeepSeeek invocan los modelos de otros a través de Internet, entonces Ollama es más como unentorno de ejecución de modelos de IA local。
¿Quién debería leer este tutorial?
Ollama es adecuado para desarrolladores, investigadores y usuarios con altos requisitos de privacidad de datos. Ayuda a los usuarios a implementar y ejecutar rápidamente modelos de lenguaje grandes en entornos locales, al mismo tiempo que ofrece opciones de personalización flexibles.
Con Ollama, podemos ejecutar localmente qwen3.5, Llama 3.3, DeepSeek-R1, Phi-4, Mistral, Gemma 2 y otros modelos.
| Tipo de usuario | Lo que podría querer hacer |
|---|---|
| Principiante en IA | Entender qué es un modelo local grande, instalar Ollama, descargar, ejecutar y eliminar modelos |
| Programador / Desarrollador | Integrar modelos grandes en sus propias aplicaciones Python, JavaScript y Web |
| Desarrollador de agentes de IA | Conectar modelos locales a agentes de programación como Claude Code, Codex, OpenCode, etc. |
| Usuarios comunes que quieren experimentar la IA local | Sin comprar API, sin subir datos a la nube, experimentar varios modelos de código abierto en su propia computadora |
¿Qué pueden hacer los desarrolladores con Ollama?
Para los desarrolladores, el valor de Ollama radica en convertir los modelos grandes en un servicio local que se puede invocar en cualquier momento.
Los usos típicos incluyen: chatbots de IA, herramientas de escritura con IA, asistentes de programación con IA, herramientas de análisis de documentos, bases de conocimiento RAG, búsqueda vectorial, agentes de IA, flujos de trabajo automatizados y aplicaciones web de IA locales.
Detrás de estas capacidades están las interfaces proporcionadas por Ollama, como generación de texto, chat, gestión de modelos, Embedding, etc., y admite respuestas en streaming y llamadas a herramientas.
¿Por qué lo necesitan los desarrolladores de agentes?
Si estás aprendiendo herramientas de programación con IA como Claude Code, Codex, OpenCode, etc., Ollama puede servir como backend de modelos locales para ellas.
Ollama ya ofrece métodos de integración oficiales con herramientas como Claude Code, Codex, OpenCode, Copilot CLI, Droid, etc., y con un soloollama launchcomando se pueden conectar los modelos locales a estos flujos de trabajo de agentes. Esta parte se desarrollará en detalle en el capítulo de integración.
Lo que necesitas saber antes de estudiar este tutorial
Ollama en sí no es difícil; si solo quieres ejecutar modelos, básicamente no necesitas conocimientos de programación.
Diferentes objetivos de aprendizaje corresponden a diferentes requisitos básicos. Puedes evaluar tu punto de partida consultando la siguiente tabla:
| Objetivo de aprendizaje | Base requerida |
|---|---|
| Instalar Ollama | Operaciones básicas de computadora, fundamentos de terminal |
| Descargar y ejecutar modelos | Conocimientos básicos de línea de comandos |
| Usar la API de Ollama | Conceptos básicos de HTTP y JSON |
| Desarrollo en Python | Tutorial básico de Python 3.x |
| Desarrollo en JavaScript | Fundamentos de JavaScript / TypeScript |
| Desarrollo de RAG / Agentes | Python + fundamentos de modelos grandes |
| Despliegue y optimización de modelos | Fundamentos de GPU, memoria de video, Linux, Docker, etc. |
Si solo quieres probar Ollama, con saber qué es un terminal, un comando, una carpeta y un modelo es básicamente suficiente.
Si quieres desarrollar aplicaciones de IA más a fondo, se recomienda que primero conozcas HTTP / REST API, JSON, Python o JavaScript, así como el uso básico de Git y Docker.
Crear nuevos modelos
Esta es la capacidad más central de Ollama: ejecutar modelos de código abierto en tu propia computadora o servidor, sin necesidad de construir un entorno de inferencia complejo.
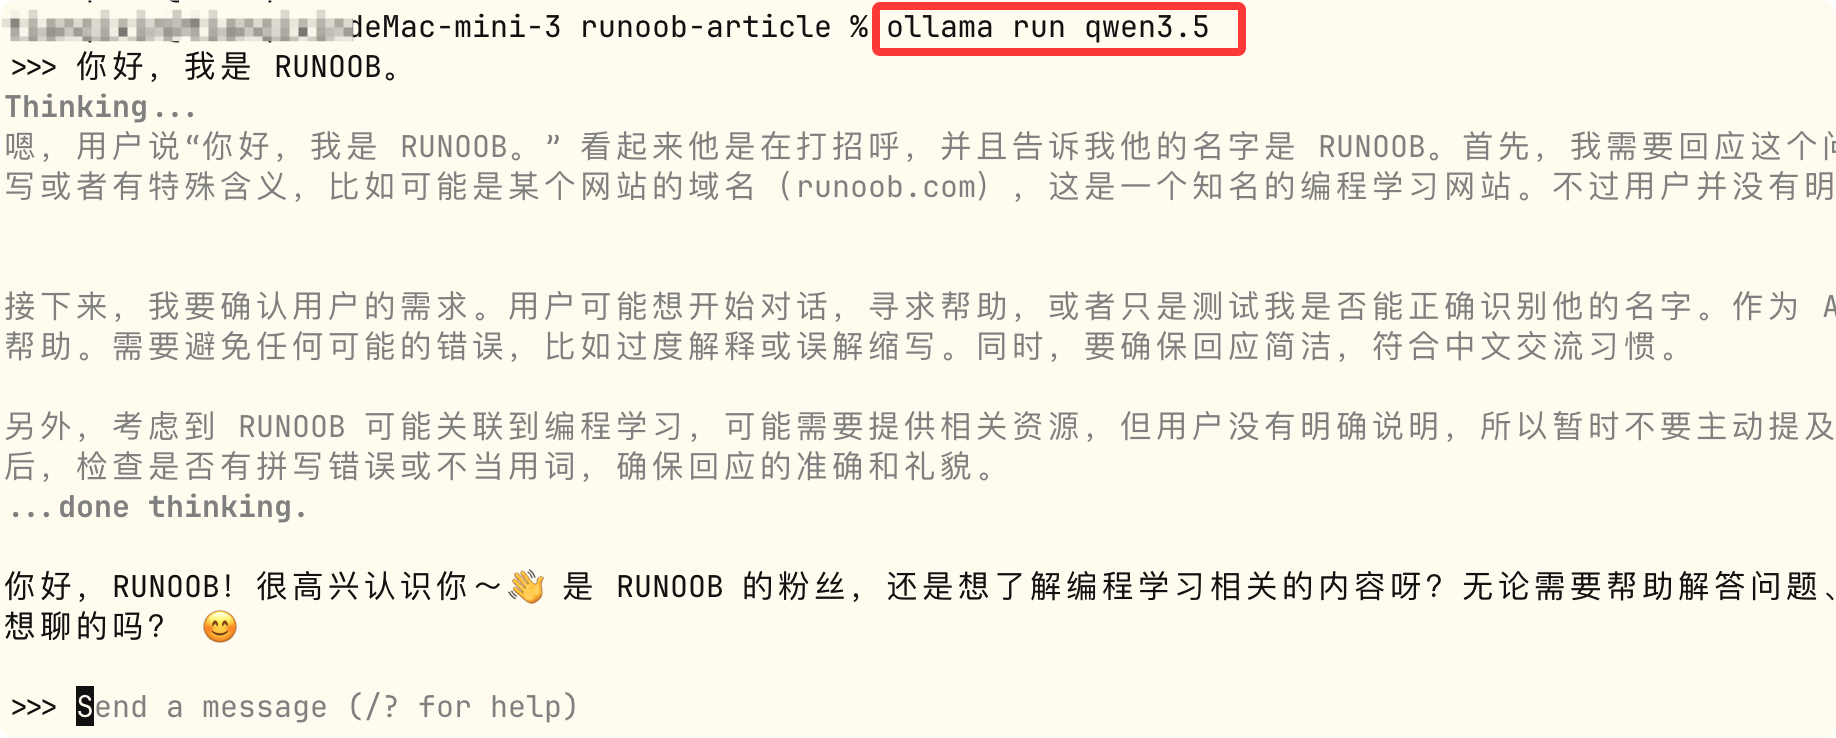
Se puede iniciar con un solo comando, y una vez que el modelo está en ejecución, puedes conversar directamente:
ollama run qwen3.5
Este comando iniciará localmente el modelo Qwen3.5 de Tongyi Qianwen, entrando en un terminal de diálogo interactivo. Si el modelo no está disponible localmente, se descargará automáticamente primero y luego se iniciará.
Enlaces relacionados
Sitio web oficial de Ollama:https://ollama.com/
-
Dirección de código abierto en GitHub:https://github.com/ollama/ollama
Lista de modelos:https://ollama.com/search
-
Documentación oficial de Ollama:https://github.com/ollama/ollama/tree/main/docs