Entraînement de modèles TensorFlow
TensorFlow fournit un ensemble complet d'outils pour construire et entraîner des modèles de réseaux de neurones.
L'entraînement du modèle est le processus d'ajustement automatique des paramètres du modèle à travers les données afin d'acquérir une capacité prédictive.
Éléments essentiels de l'entraînement du modèle
- Données: ensemble d'entraînement, ensemble de validation et ensemble de test
- Architecture du modèle: la structure des couches et les méthodes de connexion du réseau de neurones
- Fonction de perte: une métrique qui mesure la différence entre les prédictions du modèle et les valeurs réelles
- Optimiseur: un algorithme pour ajuster les paramètres du modèle
- Métriques d'évaluation: critères de mesure de la performance du modèle
Flux de travail d'entraînement
1. Préparation des données
Exemple
from tensorflow.keras import datasets
# Charger le jeu de données (en utilisant MNIST comme exemple) # Prétraitement des données # Convertir en TensorFlow Dataset
(train_images, train_labels), (test_images, test_labels) = datasets.mnist.load_data()
2. Construction du modèle
train_images = train_images.reshape((60000, 28, 28, 1)).astype('float32') / 255
test_images = test_images.reshape((10000, 28, 28, 1)).astype('float32') / 255
Exemple
train_dataset = tf.data.Dataset.from_tensor_slices((train_images, train_labels))
train_dataset = train_dataset.shuffle(10000).batch(64)
2. Construction du modèle
Exemple
Exemple
model = models.Sequential([
layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
layers.MaxPooling2D((2, 2)),
layers.Conv2D(64, (3, 3), activation='relu'),
layers.MaxPooling2D((2, 2)),
layers.Conv2D(64, (3, 3), activation='relu'),
layers.Flatten(),
layers.Dense(64, activation='relu'),
layers.Dense(10, activation='softmax')
])
Description des paramètres de compilation
model.summary()
3. Compilation du modèle
Exemple
loss='sparse_categorical_crossentropy',
metrics=['accuracy'])
Description
| 'adam', 'sgd', 'rmsprop', etc. | Sélection de l'algorithme d'optimisation | 'mse', 'categorical_crossentropy', etc. |
|---|---|---|
| optimizer | Type de fonction de perte | ['accuracy'], ['mse'], etc. |
| loss | Liste des métriques d'évaluation | 4. Entraînement du modèle |
| metrics | Exemple | Paramètres principaux de la méthode fit() |
4. Entraînement du modèle
Exemple
époques=10,
validation_data=(test_images, test_labels))
Description
| Données d'entrée | Données d'entraînement | Données cibles |
|---|---|---|
| x | Données d'étiquettes | Integer |
| y | Nombre d'époques | Integer |
| époques | Taille du lot | Tuple |
| batch_size | Jeu de données de validation | Liste |
| validation_data | Liste de callbacks | Visualisation du processus d'entraînement |
| callbacks | Courbes d'entraînement | Exemple |
Visualisation du processus d'entraînement
Courbes d'entraînement
Exemple
Boucle d'entraînement personnalisée
plt.plot(history.history['accuracy'], label='Précision d'entraînement')
plt.plot(history.history['val_accuracy'], label='Précision de validation')
plt.xlabel('Époque')
plt.ylabel('Précision')
plt.legend()
plt.show()
Organigramme d'entraînement
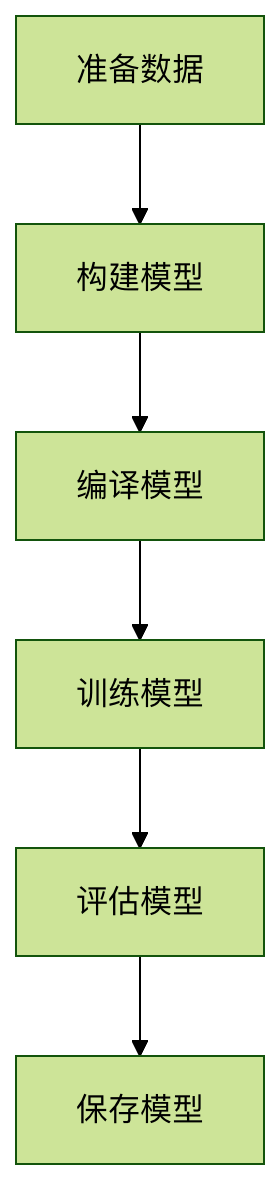
Techniques d'entraînement avancées
Boucle d'entraînement personnalisée
Exemple
loss_fn = tf.keras.losses.SparseCategoricalCrossentropy()
optimizer = tf.keras.optimizers.Adam()
Problèmes courants et solutions
@tf.function
def train_step(images, labels):
with tf.GradientTape() as tape:
predictions = model(images)
loss = loss_fn(labels, predictions)
gradients = tape.gradient(loss, model.trainable_variables)
optimizer.apply_gradients(zip(gradients, model.trainable_variables))
return loss
Tableau de dépannage d'entraînement
for epoch in range(10):
for images, labels in train_dataset:
loss = train_step(images, labels)
print(f'Époque {epoch}, Perte : {loss.numpy()}')
Utilisation des callbacks
Exemple
Solution
callbacks = [
ModelCheckpoint('best_model.h5', save_best_only=True),
EarlyStopping(patience=3, monitor='val_loss')
]
La perte ne diminue pas
model.fit(train_dataset,
époques=20,
validation_data=(test_images, test_labels),
callbacks=callbacks)
Problèmes courants et solutions
Tableau de dépannage d'entraînement
| La précision fluctue fortement | La taille du lot est inappropriée | Ajuster batch_size |
|---|---|---|
| Surapprentissage | Le modèle est trop complexe | Ajouter une régularisation ou Dropout |
| Vitesse d'entraînement lente | Limitations matérielles | Utiliser l'accélération GPU ou réduire la taille du modèle |
| Conseils d'optimisation des performances | Optimisation du pipeline de données | Exemple |
| # Utiliser prefetch et cache pour accélérer le chargement des données | Entraînement en précision mixte | Exemple |
Conseils d'optimisation des performances
Exemple:
Exemple
Exercice 1 : Entraînement de base
train_dataset = train_dataset.cache().prefetch(buffer_size=tf.data.AUTOTUNE)
Utilisez le jeu de données Fashion MNIST, construisez un modèle CNN et terminez l'entraînement. Exigences ::
Exemple
policy = tf.keras.mixed_precision.Policy('mixed_float16')
tf.keras.mixed_precision.set_global_policy(policy)
Entraîner pendant 10 époques:
Exemple
strategy = tf.distribute.MirroredStrategy()
with strategy.scope():
model = create_model()
model.compile(...)
Exercices pratiques
Exercice 1 : Entraînement de base
Ajouter le callback EarlyStopping
- Implémenter la décroissance du taux d'apprentissage
- Utiliser ModelCheckpoint pour enregistrer le meilleur modèle
- Exercice 3 : Entraînement personnalisé
Exercice 2 : Techniques avancées
À travers cet article, vous devriez avoir maîtrisé le flux de travail essentiel et les techniques clés de l'entraînement des modèles TensorFlow. Dans les applications pratiques, vous devez ajuster la stratégie d'entraînement en fonction du problème spécifique et des caractéristiques des données. Il est recommandé de commencer par un modèle simple, d'augmenter progressivement la complexité et de trouver la meilleure configuration d'entraînement par expérimentation.
- Autres extensions
- Réflexion de l'IA...
- Traitement des données textuelles TensorFlow
Exercice 3 : Entraînement personnalisé
Liste des notes
Cliquez ici pour partager des notes
La note doit être un prolongement de cet article !
Soumission d'article, cliquez ici
Comment obtenir le code d'invitation à l'inscription