Обучение модели в TensorFlow
TensorFlow предоставляет полный набор инструментов для построения и обучения моделей нейронных сетей.
Обучение модели — это процесс автоматической настройки параметров модели с помощью данных для получения способности к прогнозированию.
Основные элементы обучения модели
- Данные: обучающая выборка, валидационная выборка и тестовая выборка
- Архитектура модели: структура слоёв и способы соединения нейронной сети
- Функция потерь: метрика, измеряющая разницу между предсказаниями модели и истинными значениями
- Оптимизатор: алгоритм настройки параметров модели
- Метрики оценки: критерии измерения эффективности модели
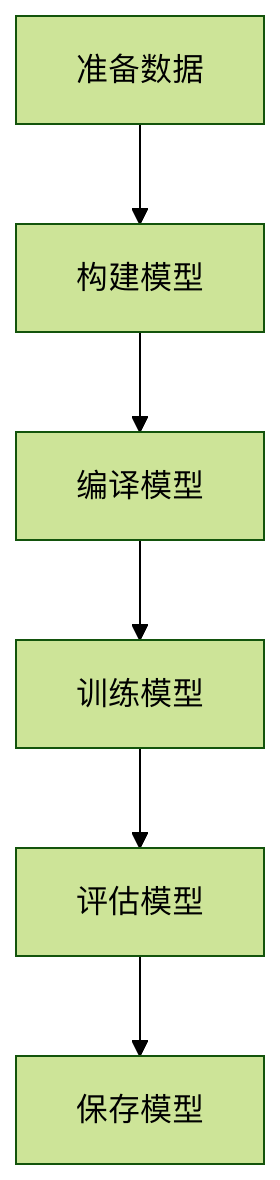
Рабочий процесс обучения
1. Подготовка данных
Пример
from tensorflow.keras import datasets
# Загрузить набор данных (на примере MNIST) # Предобработка данных # Преобразовать в TensorFlow Dataset
(train_images, train_labels), (test_images, test_labels) = datasets.mnist.load_data()
2. Построение модели
train_images = train_images.reshape((60000, 28, 28, 1)).astype('float32') / 255
test_images = test_images.reshape((10000, 28, 28, 1)).astype('float32') / 255
Пример
train_dataset = tf.data.Dataset.from_tensor_slices((train_images, train_labels))
train_dataset = train_dataset.shuffle(10000).batch(64)
2. Построение модели
Пример
Пример
model = models.Sequential([
layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
layers.MaxPooling2D((2, 2)),
layers.Conv2D(64, (3, 3), activation='relu'),
layers.MaxPooling2D((2, 2)),
layers.Conv2D(64, (3, 3), activation='relu'),
layers.Flatten(),
layers.Dense(64, activation='relu'),
layers.Dense(10, activation='softmax')
])
Описание параметров компиляции
model.summary()
3. Компиляция модели
Пример
loss='sparse_categorical_crossentropy',
metrics=['accuracy'])
Описание
| 'adam', 'sgd', 'rmsprop' и т. д. | Выбор алгоритма оптимизатора | 'mse', 'categorical_crossentropy' и т. д. |
|---|---|---|
| optimizer | Тип функции потерь | ['accuracy'], ['mse'] и т. д. |
| loss | Список метрик оценки | 4. Обучение модели |
| metrics | Пример | Основные параметры метода fit() |
4. Обучение модели
Пример
epochs=10,
validation_data=(test_images, test_labels))
Описание
| Входные данные | Обучающие данные | Целевые данные |
|---|---|---|
| x | Данные меток | Integer |
| y | Количество эпох | Integer |
| epochs | Размер батча | Tuple |
| batch_size | Набор данных для валидации | Список |
| validation_data | Список колбэков | Визуализация процесса обучения |
| callbacks | Кривые обучения | Пример |
Визуализация процесса обучения
Кривые обучения
Пример
Пользовательский цикл обучения
plt.plot(history.history['accuracy'], label='Точность обучения')
plt.plot(history.history['val_accuracy'], label='Точность валидации')
plt.xlabel('Эпоха')
plt.ylabel('Точность')
plt.legend()
plt.show()
Блок-схема обучения
Продвинутые методы обучения
Пользовательский цикл обучения
Пример
loss_fn = tf.keras.losses.SparseCategoricalCrossentropy()
optimizer = tf.keras.optimizers.Adam()
Распространённые проблемы и решения
@tf.function
def train_step(images, labels):
with tf.GradientTape() as tape:
predictions = model(images)
loss = loss_fn(labels, predictions)
gradients = tape.gradient(loss, model.trainable_variables)
optimizer.apply_gradients(zip(gradients, model.trainable_variables))
return loss
Таблица устранения проблем обучения
for epoch in range(10):
for images, labels in train_dataset:
loss = train_step(images, labels)
print(f'Epoch {epoch}, Loss: {loss.numpy()}')
Использование колбэков
Пример
Решение
callbacks = [
ModelCheckpoint('best_model.h5', save_best_only=True),
EarlyStopping(patience=3, monitor='val_loss')
]
Функция потерь не уменьшается
model.fit(train_dataset,
epochs=20,
validation_data=(test_images, test_labels),
callbacks=callbacks)
Распространённые проблемы и решения
Таблица устранения проблем обучения
| Точность сильно колеблется | Размер пакета не подходит | Настройте batch_size |
|---|---|---|
| Переобучение | Модель слишком сложна | Добавьте регуляризацию или Dropout |
| Медленная скорость тренировки | Аппаратные ограничения | Используйте ускорение на GPU или уменьшите размер модели |
| Советы по оптимизации производительности | Оптимизация конвейера данных | Пример |
| # Используйте prefetch и cache для ускорения загрузки данных | Обучение со смешанной точностью | Пример |
Советы по оптимизации производительности
Пример:
Пример
Упражнение 1: Базовое обучение
train_dataset = train_dataset.cache().prefetch(buffer_size=tf.data.AUTOTUNE)
Используйте набор данных Fashion MNIST, постройте модель CNN и завершите обучение. Требования::
Пример
policy = tf.keras.mixed_precision.Policy('mixed_float16')
tf.keras.mixed_precision.set_global_policy(policy)
Обучите модель в течение 10 эпох:
Пример
strategy = tf.distribute.MirroredStrategy()
with strategy.scope():
model = create_model()
model.compile(...)
Практические упражнения
Упражнение 1: Базовое обучение
Добавьте колбэк EarlyStopping
- Реализуйте затухание скорости обучения
- Используйте ModelCheckpoint для сохранения лучшей модели
- Упражнение 3: Пользовательское обучение
Упражнение 2: Продвинутые техники
Благодаря этой статье вы должны были освоить основной рабочий процесс и ключевые техники обучения моделей TensorFlow. В практических приложениях вам нужно корректировать стратегию обучения в зависимости от конкретной задачи и характеристик данных. Рекомендуется начинать с простой модели, постепенно увеличивать сложность и находить лучшую конфигурацию обучения с помощью экспериментов.
- Другие расширения
- ИИ думает...
- Обработка текстовых данных в TensorFlow
Упражнение 3: Пользовательское обучение
Список заметок
Нажмите, чтобы поделиться заметками
Заметка должна быть продолжением этой статьи!
Отправка статьи, нажмите здесь
Как получить код приглашения для регистрации