NLP 入門
自然言語処理(Natural Language Processing, NLP)コンピュータ科学、人工知能、言語学の交差領域であり、コンピュータが人間の自然言語を理解・処理・生成できるようにすることに取り組んでいる。
中核となる目標:
- 理解:コンピュータが人間の言語の意味を理解できるようにする
- 処理:テキストと音声を分析・変換・操作する
- 生成:コンピュータが自然で流暢な人間の言語を生成できるようにする

自然言語の特徴
人間の言語には以下のような独特な特徴があり、これらの特徴がNLPを非常に挑戦的な分野にしている:
1. 曖昧性(Ambiguity)
- 語彙の曖昧性:1つの単語が複数の意味を持つ
- 例:"bank" は金融機関を指すこともあれば、川岸を指すこともある
- 構文の曖昧性:文の文法構造が複数の解釈を持つことができる
- 例:「望遠鏡を持っているあの人を見た」(その人が望遠鏡を持っているのか、私が望遠鏡でその人を見たのか?)
- 意味の曖昧性:文の全体的な意味が明確でない
- 例:「彼らはりんごを買った」(果物なのか、Apple社の製品なのか?)
2. 文脈依存性(Context Dependency)
- 同じ単語や文でも異なる文脈では意味が異なる
- 例:「この考えはcoolだ」の「cool」は「素晴らしい」という意味だが、「今日はcoolだ」は「涼しい」という意味だ
3. 創造性と変化性
- 言語は絶えず発展しており、新しい語彙や新しい表現方法が次々と生まれている
- ネット用語や流行語の急速な普及
- 例:「给力(すごい)」から「yyds(永遠の神)」まで
4. 文化と社会的背景
- 言語は深い文化的な意味合いを担っている
- 同じ言語でも地域によって方言の違いがある
- 例:中国語の「食べた?」は質問であるだけでなく、一種の挨拶の仕方でもある
5. 非標準化
- 口語的な表現、略語、誤字
- 文法が規範的でない、文が不完全
- 例:微博(Weibo)やチャット履歴における非公式な表現
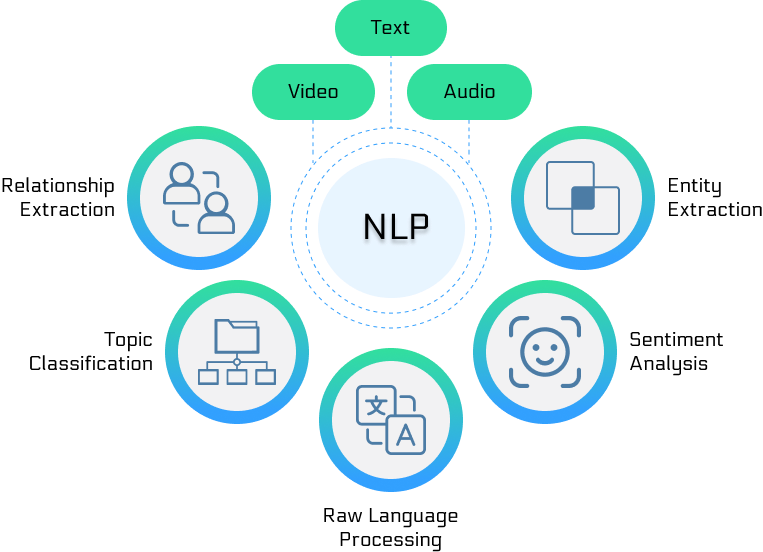
NLPの主要タスク
1. 基礎タスク
- トークン化(Tokenization):テキストを意味のある単位に分解する
- 品詞タグ付け(POS Tagging):各単語の文法カテゴリを識別する
- 構文解析(Parsing):文の文法構造を分析する
- 固有表現認識(NER):人名、地名、組織名などを識別する
2. 理解タスク
- 意味役割ラベリング:文中の意味的関係を識別する
- 共参照解決:テキスト内で同じ実体を指す異なる表現を特定する
- 関係抽出:エンティティ間の意味的関係を識別する
- イベント抽出:テキストからイベント情報を抽出する
3. 応用タスク
- テキスト分類:テキストを定義済みのカテゴリに分類する
- 感情分析:テキストの感情的な傾向を判断する
- 機械翻訳:ある言語を別の言語に翻訳する
- テキスト要約:テキストの簡潔な要約を生成する
- 質問応答システム:質問に基づいて回答を検索または生成する
NLPの発展の歴史
第一段階:ルールベース手法の時代(1950年代-1980年代)
特徴:
- 人手で作成された文法規則と知識ベースに基づく
- エキスパートシステム手法が主流だった
- 処理能力は限られていたが、特定の分野では優れた性能を発揮した
代表的な取り組み:
- 1950年- チューリングテストが提案され、機械知能の評価の基礎を築いた
- 1954年- Georgetown-IBM実験、初の機械翻訳の試み
- 1960s- ELIZAチャットボット、パターンマッチング技術を使用
- 1970s- ATN(拡張遷移ネットワーク)などの構文解析器の発展
代表的なシステム:
- SHRDLU(1970):積み木の世界で自然言語の指示を理解し実行する
- LUNAR(1972):月の岩石に関する質問に回答する
限界:
- ルールの適用範囲が限られており、言語の複雑さを処理するのが難しい
- メンテナンスコストが高く、拡張性が低い
- 曖昧性や異常なケースをうまく処理できない
第二段階:統計的手法の時代(1980年代-2010年代)
特徴:
- 大規模コーパスに基づく統計的学習手法
- 機械学習アルゴリズムの広範な応用
- データ駆動型の方法論
主要な技術の発展:
1980年代-1990年代:統計的手法の台頭
- 隠れマルコフモデル(HMM):品詞タグ付け、音声認識に使用
- 確率文脈自由文法(PCFG):構文解析に使用
- 統計的機械翻訳:フレーズと文のアライメントに基づく
2000年代:機械学習手法の成熟
- サポートベクターマシン(SVM):テキスト分類で優れた性能を発揮
- 条件付き確率場(CRF):系列ラベリングタスクに使用
- ナイーブベイズ:シンプルで効果的な分類手法
- 最大エントロピーモデル:複数の特徴を扱う問題に使用
重要なマイルストーン:
- 1988年- Brownコーパスの公開、統計NLPの発展を促進
- 1993年- Penn Treebankの公開、構文解析に標準データを提供
- 2000年- WordNetの公開、大規模な語彙意味ネットワークを提供
- 2005年- Googleが統計的機械翻訳システムを公開
利点:
- 大規模な実テキストを処理できる
- 一定の汎化能力を持つ
- データから自動的にパターンを学習できる
限界:
- 大量のラベル付きデータが必要
- 特徴エンジニアリングの作業量が大きい
- 深い意味情報を捉えるのが難しい
第三段階:ディープラーニングの時代(2010年代-2020年代)
特徴:
- ニューラルネットワークモデルの復活と発展
- エンドツーエンドの学習手法
- 表現学習のブレークスルー
主要な技術の発展:
2010年代初期:ニューラルネットワークの復興
- 2010年- リカレントニューラルネットワーク(RNN)の言語モデリングへの応用
- 2013年- Word2Vecの公開、単語ベクトル表現のブレークスルー
- 2014年- Sequence-to-Sequenceモデル、機械翻訳の革命
2010年代半ば:アテンション機構
- 2015年- アテンション機構の提案と応用
- 2016年- ニューラル機械翻訳が実用レベルに到達
- 2017年- Transformerアーキテクチャの発表、「Attention is All You Need」
2010年代後期:事前学習モデル
- 2018年- BERT発表、双方向事前学習のブレークスルー
- 2019年- GPT-2発表、大規模生成モデル
- 2020年- GPT-3発表、驚異的な言語能力を発揮
重要なブレークスルー:
- 単語ベクトル技術:Word2Vec, GloVe, FastText
- 系列モデル:LSTM、GRU、双方向RNN
- 注意力メカニズム:長い系列の依存問題を解決
- Transformerアーキテクチャ:並列化トレーニングにより、効果が大幅に向上
- 事前学習モデル:BERT、GPTシリーズ、汎用言語理解
第四段階:大規模言語モデルの時代(2020年代-現在)
特徴:
- モデル規模が急速に拡大
- 汎用人工知能の兆し
- 少数サンプルおよびゼロサンプル学習能力
重要な発展:
- 2020年- GPT-3(1750億パラメータ)が強力なfew-shot学習能力を発揮
- 2021年- PaLM(5400億パラメータ)が複数のタスクで新たな高みに到達
- 2022年- ChatGPT発表、AIアプリケーションのブームを巻き起こす
- 2023年- GPT-4発表、マルチモーダル能力が顕著に向上
- 2024年〜現在- Claude、Geminiなどの競合他社が台頭
技術的特徴:
- スケール効果:モデルのパラメータ数が億単位から兆単位に増加
- 創発能力:モデルが一定の規模に達すると予期しない能力を発現する
- マルチモーダル融合:テキスト、画像、音声の統一的処理
- 指示追従:指示チューニングによりモデルの制御性を向上
NLPの主要な応用分野
機械翻訳(Machine Translation)
発展の歴史:
- 統計的機械翻訳(SMT):フレーズアライメントと統計モデルに基づく
- ニューラル機械翻訳(NMT):エンドツーエンドのニューラルネットワーク手法
- 大規模モデル翻訳:GPT-3/4などの大規模モデルが示す翻訳能力
技術的課題:
- 言語ペア間の差異
- 文脈の理解と保持
- 専門分野の用語翻訳
- 言語スタイルと文化への適応
応用例:
- Google Translate、百度翻訳
- リアルタイム音声翻訳
- 文書翻訳サービス
- 言語横断的情報検索
検索エンジンと情報検索
中核技術:
- クエリ理解:ユーザーの検索意図を理解
- 文書ランキング:関連性に基づいて検索結果を順位付け
- 意味マッチング:キーワードを超えた意味的類似度計算
- パーソナライズドレコメンデーション:ユーザーの履歴と嗜好に基づく
技術の発展:
- キーワードマッチングから意味理解へ
- 静的ランキングから動的パーソナライズへ
- テキスト検索からマルチモーダル検索へ
代表的なシステム:
- Google検索のRankBrainアルゴリズム
- 百度のERNIEの検索への応用
- Bing Chatの対話型検索
インテリジェントカスタマーサービスと対話システム
システムの種類:
- タスク指向型:特定のタスクを完了する(予約、照会など)
- 雑談型:オープンドメインの対話を行う
- ハイブリッド型:タスク完了と雑談機能を組み合わせる
重要な技術:
- 意図認識:ユーザーの真の意図を理解
- スロットフィリング:タスクに関連する重要な情報を抽出
- 対話管理:対話のフローと状態を制御
- 応答生成:自然で関連性のある応答を生成
応用シナリオ:
- 銀行、ECサイトのスマートカスタマーサービス
- スマートスピーカー(Alexa、Siri)
- チャットボット
- バーチャルアシスタント
テキスト分析と感情分析
テキスト分析タスク:
- トピック分類:文書をトピックカテゴリに分類
- キーワード抽出:文書の核となる語彙を識別
- テキストクラスタリング:類似した文書をグループ化
- トレンド分析:テキスト内容の時間的変化を分析
感情分析のレベル:
- 文書レベル:文書全体の全体的な感情
- 文レベル:各文の感情傾向
- アスペクトレベル:特定のアスペクトに対する感情
- きめ細かい粒度:感情の強度と複雑さ
ビジネス応用:
- ソーシャルメディア監視
- 製品レビュー分析
- ブランド評判管理
- 株式市場の感情指標
情報抽出
抽出タスク:
- 固有表現認識:人名、地名、組織名など
- 関係抽出:エンティティ間の意味的関係
- イベント抽出:イベントの参加者、時間、場所など
- 属性抽出:エンティティの特徴属性
技術的手法:
- ルールベースのパターンマッチング
- 教師あり学習手法
- 遠隔監視と弱教師あり学習
- 事前学習モデルのファインチューニング
応用価値:
- 知識グラフ構築
- スマートQAシステム
- ニュースイベント監視
- 金融リスク分析
自動要約
要約の種類:
- 抽出型要約:原文から重要な文を選択
- 生成型要約:新しい要約テキストを生成
- ハイブリッド型要約:抽出と生成の手法を組み合わせる
技術的課題:
- 重要情報の識別
- 要約の一貫性と可読性
- 複数文書要約の一貫性
- 要約の長さの制御
応用シナリオ:
- ニュース要約
- 学術論文の要約
- 法律文書の要約
- 会議議事録の生成
NLPが直面する主な課題
言語の曖昧性
語彙の曖昧性(Lexical Ambiguity)
- 多義語:
- 「打」:叩く、買う、開くなど
- 「行」:よい/銀行/歩くなど
- 同音異義:
- 中国語:「的、地、得」の使い分け
- 英語:"there, their, they're"
構文の曖昧性(Syntactic Ambiguity)
- 修飾関係が不明確:
- 「美しい花の香り」(花が美しいのか、香りが美しいのか?)
- 構造分析が多様:
- 「私は傘を持っている女の子を見た」
意味の曖昧性(Semantic Ambiguity)
- 指示が不明確:
- 「李明は張華に彼はとても賢いと言った」(誰が賢いのか?)
- スコープの曖昧性:
- 「すべての学生がこの先生を好きではない」
解決方法:
- 文脈情報の活用
- 言語モデルによる確率的判断
- 知識ベースの補助
- マルチタスク学習
文脈理解
局所的文脈
- 文内の意味的依存関係
- 句や節の理解
- 語彙間の意味的関係
大局的文脈
- 段落や文書レベルの意味的一貫性
- 話題の連続性
- 長距離の意味的依存関係
対話の文脈
- 複数ターンの対話の履歴情報
- 暗黙情報の推論
- 対話意図の変遷
技術的課題:
- 長距離依存:従来のRNNは長いシーケンスを処理するのが難しい
- 意味的一貫性:生成テキストの論理的一貫性を保つ
- 常識推論:豊富な背景知識が必要
解決策:
- 注意力メカニズムとTransformer
- 事前学習言語モデル
- 知識強化モデル
- マルチモーダル情報融合
文化と言語の違い
言語横断的な課題
- 言語系統の違い:
- シナ・チベット語族 vs インド・ヨーロッパ語族
- 形態変化が豊か vs 語順が重要
- 文字体系の違い:
- 文字セットの大きさが異なる
- 分かち書きの方法が異なる
文化的背景
- 慣用句とことわざ:
- 「画蛇添足」 vs 「don't count your chickens before they hatch」
- 文化特有の表現:
- 中国語の「面子」の概念
- 日本語の敬語システム
社会言語学的要因
- 方言の違い:
- 標準中国語 vs 各地の方言
- 標準英語 vs 方言英語
- 言語使用域の変化:
- 正式 vs 非公式な文体
- 口語 vs 文語
解決戦略:
- 多言語事前学習モデル
- 言語横断的転移学習
- 文化適応性の調整
- ローカライズされたデータ収集
データ不足の問題
低リソース言語
- 世界には7000以上の言語があるが、豊富なデジタルリソースを持つものは少数
- 絶滅危惧言語の保護と研究
- 方言と少数民族言語
専門分野
- 医学、法律などの専門分野の用語
- 業界固有の表現方法
- アノテーションデータの取得が困難
新興分野
- 新技術によって生まれた新語彙
- ソーシャルメディアの新しい表現
- 異文化コミュニケーションの新しい形態
時間的変遷
- 言語の歴史的変遷
- 新語彙の急速な出現
- 意味の漸進的変化
解決策:
- 転移学習:高リソース言語から低リソース言語への転移
- データ拡張:さまざまな技術でトレーニングデータを拡充
- 少数サンプル学習:少数のサンプルで迅速に適応
- 教師なし学習と自己教師あり学習:アノテーションデータへの依存を減らす
- クラウドソーシングによるアノテーション:集合知を活用してデータを収集
- 合成データ:ルールやモデルでトレーニングデータを生成
計算の複雑さ
モデル規模の課題
- パラメータ数の爆発的増加(GPT-3: 1750億パラメータ)
- トレーニングコストの急激な上昇
- 推論の遅延とリソース消費
リアルタイム性の要件
- 検索エンジンのミリ秒レベルの応答
- 対話システムのリアルタイム対話
- モバイルデバイスのリソース制限
スケーラビリティの問題
- 膨大なユーザーリクエストの処理
- 多言語・マルチタスクの統一的処理
- パーソナライズサービスの計算要件
評価と定量化の難しさ
主観性の問題
- テキスト品質の主観的判断
- 翻訳品質の文化差
- 創造的ライティングの評価基準
評価指標の限界
- BLEU、ROUGEなどの指標の不完全さ
- 自動評価と人間による評価の違い
- 多次元評価の複雑さ
ベンチマークデータセット
- データセットの代表性の問題
- 評価タスクと実用化のギャップ
- データセットの鮮度と更新
まとめと展望
自然言語処理は人工知能の中核的分野として、ルール駆動からデータ駆動、そして大規模モデル主導の発展の過程を経てきた。各段階には独自の技術的特徴と歴史的貢献がある。
現在の状況:
- 大規模言語モデルは驚異的な言語理解と生成能力を示している
- マルチモーダル融合が新たな発展の方向性となっている
- 応用分野は拡大し続け、商業的価値がますます顕在化している
将来のトレンド:
- 汎用人工知能:より汎用的で、よりインテリジェントなAIシステムへ発展
- マルチモーダル融合:テキスト、視覚、聴覚の全面的統合
- パーソナライズサービス:より精密なパーソナライズ言語理解と生成
- 説明可能性:モデルの意思決定プロセスの透明性を向上
- 効率最適化:性能を維持しながら計算コストを削減
- 倫理と安全:AIシステムの公平性、安全性、制御可能性を確保
学習アドバイス:
NLPの学習者へのアドバイス:
- 確固たる基礎:言語学とコンピュータ科学の基礎を深く理解
- 実践指向:プロジェクト実践を通じて理解を深める
- 最前線の追跡:最新の技術発展と研究動向に注目
- 学際的思考:言語学、心理学、社会学などの多分野の知識を組み合わせる
- エンジニアリング能力:研究成果を実用化に転換する能力を育成
自然言語処理の未来は機会と課題に満ちている。技術の絶え間ない進歩に伴い、機械が人間の言語を理解・生成する能力は向上し続け、人間社会により多くの利便性と価値をもたらすと信じるに足る理由がある。
その他の拡張