Введение в NLP
Обработка естественного языка (NLP)— это междисциплинарная область, объединяющая информатику, искусственный интеллект и лингвистику и посвящённая тому, чтобы компьютеры могли понимать, обрабатывать и генерировать естественный человеческий язык.
Основные цели:
- Понимание: обеспечение способности компьютеров понимать смысл человеческого языка
- Обработка: анализ, преобразование и манипулирование текстом и речью
- Генерация: обеспечение способности компьютеров создавать естественный, плавный человеческий язык

Особенности естественного языка
Человеческий язык обладает следующими уникальными особенностями, которые делают NLP крайне сложной областью:
1. Неоднозначность
- Лексическая неоднозначность: слово имеет несколько значений
- Пример: "bank" может означать финансовое учреждение или берег реки
- Синтаксическая неоднозначность: грамматическая структура предложения может иметь несколько интерпретаций
- Пример: "Я видел человека с телескопом" (человек держит телескоп или я использовал телескоп, чтобы увидеть человека?)
- Семантическая неоднозначность: общий смысл предложения неясен
- Пример: "Они купили яблоки" (это фрукты или продукция Apple Inc.?)
2. Контекстная зависимость
- Одно и то же слово или предложение имеет разные значения в разных контекстах
- Пример: "cool" в "This idea is very cool" означает "классно", а "It's cool today" означает "прохладно" (температура)
3. Инновации и вариативность
- Язык постоянно развивается, новые слова и выражения появляются одно за другим
- Быстрое распространение интернет-сленга и крылатых выражений
- Пример: от "Give力" (geili/круто) до "yyds" (永farof神, означающее "вечный бог")
4. Культурный и социальный контекст
- Язык несёт глубокие культурные коннотации
- Один и тот же язык имеет диалектные различия в разных регионах
- Пример: в китайском языке "eatalready吗?" (Вы уже ели?) — это не только вопрос, но и форма приветствия
5. Нестандартность
- Разговорные выражения, сокращения, опечатки
- Нестандартная грамматика, неполные предложения
- Пример: неформальные выражения в Weibo и записях чатов
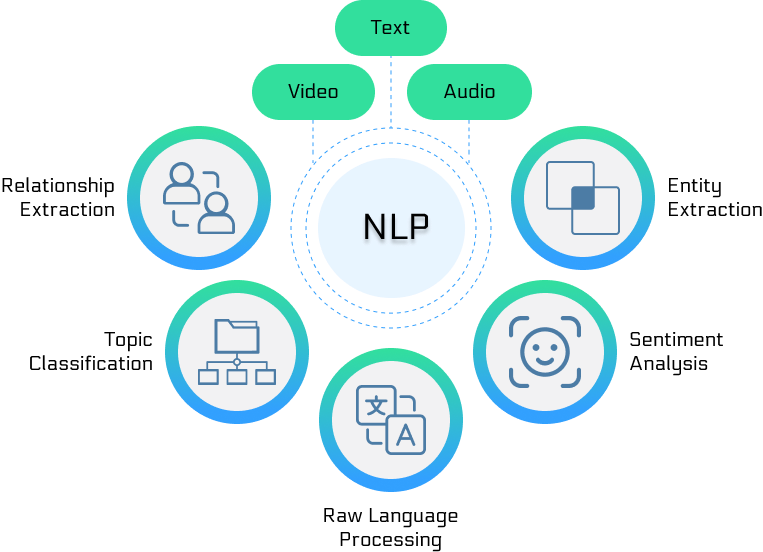
Основные задачи NLP
1. Базовые задачи
- Токенизация: разбиение текста на смысловые единицы
- Разметка частей речи (POS Tagging): определение грамматической категории каждого слова
- Синтаксический анализ (Parsing): анализ грамматической структуры предложений
- Распознавание именованных сущностей (NER): идентификация имён людей, названий мест, названий организаций и т. д.
2. Задачи понимания
- Разметка семантических ролей: определение семантических отношений в предложениях
- Разрешение кореферентности: определение различных выражений в тексте, которые ссылаются на одну и ту же сущность
- Извлечение отношений: выявление семантических отношений между сущностями
- Извлечение событий: извлечение информации о событиях из текста
3. Прикладные задачи
- Классификация текстов: отнесение текста к заранее заданным категориям
- Анализ тональности: определение тональной направленности текста
- Машинный перевод: перевод с одного языка на другой
- Суммаризация текста: создание кратких резюме текста
- Системы ответов на вопросы: поиск или генерация ответов на основе вопросов
История развития NLP
Этап 1: Эра методов, основанных на правилах (1950-е–1980-е)
Характеристики:
- Основаны на вручную сформулированных грамматических правилах и базах знаний
- Доминировали методы экспертных систем
- Ограниченные вычислительные возможности, но хорошие результаты в определённых предметных областях
Характерные работы:
- 1950- Был предложен тест Тьюринга, заложивший основу для оценки машинного интеллекта
- 1954- Эксперимент Georgetown-IBM, первая попытка машинного перевода
- 1960s- Чат-бот ELIZA, использующий технологию сопоставления с образцом
- 1970s- Разработка парсеров, таких как ATN (сеть с расширенными переходами)
Типичные системы:
- SHRDLU(1970): понимание и выполнение команд на естественном языке в мире блоков
- LUNAR(1972): ответы на вопросы о лунных породах
Ограничения:
- Ограниченный охват правил, что затрудняет работу со сложностью языка
- Высокие затраты на поддержку и плохая масштабируемость
- Неспособность хорошо обрабатывать неоднозначности и исключительные случаи
Этап 2: Эра статистических методов (1980-е–2010-е)
Характеристики:
- Методы статистического обучения, основанные на крупномасштабных корпусах
- Широкое применение алгоритмов машинного обучения
- Методология, основанная на данных
Ключевые технологические разработки:
1980-е–1990-е: подъём статистических методов
- Скрытые марковские модели (HMM): используются для разметки частей речи и распознавания речи
- Вероятностные контекстно-свободные грамматики (PCFG): используются для синтаксического анализа
- Статистический машинный перевод: основан на выравнивании фраз и предложений
2000-е: становление методов машинного обучения
- Машины опорных векторов (SVM): отличная производительность в классификации текста
- Условные случайные поля (CRF): используются для задач разметки последовательностей
- Наивный Байес: простой и эффективный метод классификации
- Модели максимальной энтропии: обработка задач с множеством признаков
Важные вехи:
- 1988- Был выпущен Brown Corpus, что способствовало развитию статистического NLP
- 1993- Был выпущен Penn Treebank, предоставивший стандартные данные для синтаксического анализа
- 2000- Был выпущен WordNet, предоставивший крупномасштабную лексико-семантическую сеть
- 2005- Google выпустил систему статистического машинного перевода
Преимущества:
- Способен обрабатывать крупномасштабный текст из реального мира
- Обладает определённой способностью к обобщению
- Способен автоматически выявлять закономерности в данных
Ограничения:
- Требует больших объёмов размеченных данных
- Высокая трудоёмкость инженерии признаков
- Трудно уловить глубинную семантическую информацию
Этап 3: Эпоха глубокого обучения (2010-е–2020-е)
Характеристики:
- Возрождение и развитие моделей нейронных сетей
- Методы сквозного обучения
- Прорывы в обучении представлений
Ключевые технологические разработки:
Начало 2010-х: возрождение нейронных сетей
- 2010- Применение рекуррентных нейронных сетей (RNN) в языковом моделировании
- 2013- Выпущен Word2Vec — прорыв в векторных представлениях слов
- 2014- Модели Sequence-to-Sequence — революция в машинном переводе
Середина 2010-х: механизм внимания
- 2015- Предложение и применение механизма внимания
- 2016- Нейронный машинный перевод достиг практического уровня
- 2017- Выпущена архитектура Transformer, «Attention is All You Need»
Конец 2010-х: предобученные модели
- 2018- Выпущен BERT — прорыв в двунаправленном предобучении
- 2019- Выпущен GPT-2, крупномасштабная генеративная модель
- 2020- Выпущен GPT-3, продемонстрировавший поразительные языковые возможности
Ключевые прорывы:
- Технология векторных представлений слов:Word2Vec, GloVe, FastText
- Модели последовательностей: LSTM, GRU, двунаправленная RNN
- Механизм внимания: решает проблемы зависимостей в длинных последовательностях
- Архитектура Transformer: распараллеленное обучение, значительно улучшенная производительность
- Предобученные модели: BERT, серия GPT, общее понимание языка
Этап 4: Эра больших языковых моделей (2020-е — настоящее время)
Характеристики:
- Быстрый рост масштаба моделей
- Заря общего искусственного интеллекта
- Возможности обучения на нескольких примерах и без примеров
Ключевые события:
- 2020- GPT-3 (175 миллиардов параметров) продемонстрировала сильные возможности обучения на нескольких примерах
- 2021- PaLM (540 миллиардов параметров) достигла новых высот в нескольких задачах
- 2022- Выпущен ChatGPT, вызвавший бум приложений ИИ
- 2023- Выпуск GPT-4, значительно улучшенные мультимодальные возможности
- 2024 — настоящее время- Рост таких конкурентов, как Claude и Gemini
Технические характеристики:
- Эффекты масштаба: количество параметров модели выросло с сотен миллионов до триллионов
- Эмерджентные способности: модели демонстрируют неожиданные способности после достижения определённого масштаба
- Мультимодальное слияние: унифицированная обработка текста, изображений и аудио
- Следование инструкциям: повышение управляемости модели с помощью тонкой настройки на инструкциях
Основные области применения NLP
Машинный перевод
История развития:
- Статистический машинный перевод (SMT): основан на выравнивании фраз и статистических моделях
- Нейронный машинный перевод (NMT): сквозные нейросетевые подходы
- Перевод с помощью больших моделей: возможности перевода, продемонстрированные большими моделями, такими как GPT-3/4
Технические проблемы:
- Различия между языковыми парами
- Понимание и сохранение контекста
- Перевод терминологии в специализированных областях
- Языковой стиль и культурная адаптация
Примеры применения:
- Google Translate, Baidu Translate
- Перевод речи в реальном времени
- Сервисы перевода документов
- Межъязыковой информационный поиск
Поисковые системы и информационный поиск
Ключевые технологии:
- Понимание запроса: понимание поискового намерения пользователя
- Ранжирование документов: ранжирование результатов поиска по релевантности
- Семантическое сопоставление: вычисление семантического сходства за пределами ключевых слов
- Персонализированная рекомендация: на основе истории и предпочтений пользователя
Технологическое развитие:
- От сопоставления ключевых слов к семантическому пониманию
- От статического ранжирования к динамической персонализации
- От текстового поиска к мультимодальному поиску
Представительные системы:
- Алгоритм RankBrain в Google Поиске
- Применение ERNIE от Baidu в поиске
- Диалоговый поиск Bing Chat
Интеллектуальное обслуживание клиентов и диалоговые системы
Типы систем:
- Ориентированные на задачи: выполнение конкретных задач (бронирование билетов, запросы и т.д.)
- Свободная беседа: ведение разговора на открытые темы
- Гибридные: сочетание выполнения задач и функций свободной беседы
Ключевые технологии:
- Распознавание намерений: понимание истинного намерения пользователя
- Заполнение слотов: извлечение ключевой информации, связанной с задачей
- Управление диалогом: управление потоком и состоянием диалога
- Генерация ответов: генерация естественных и релевантных ответов
Сценарии применения:
- Интеллектуальное обслуживание клиентов в банковской сфере и электронной коммерции
- Умные колонки (Alexa, Siri)
- Чат-боты
- Виртуальные помощники
Анализ текста и анализ тональности
Задачи анализа текста:
- Тематическая классификация: классификация документов по тематическим категориям
- Извлечение ключевых слов: определение основной лексики документов
- Кластеризация текстов: группировка похожих документов
- Анализ тенденций: анализ временных изменений в содержании текста
Уровни анализа тональности:
- Уровень документа: общая тональность всего документа
- Уровень предложения: тональная направленность каждого предложения
- Уровень аспектов: тональность по отношению к конкретным аспектам
- Детализированный анализ: интенсивность и сложность тональности
Применение в бизнесе:
- Мониторинг социальных сетей
- Анализ отзывов о продуктах
- Управление репутацией бренда
- Индикаторы настроений фондового рынка
Извлечение информации
Задачи извлечения:
- Распознавание именованных сущностей: имена людей, названия мест, названия организаций и т. д.
- Извлечение отношений: семантические отношения между сущностями
- Извлечение событий: участники, время, место и т. д. событий
- Извлечение атрибутов: характерные атрибуты сущностей
Технические подходы:
- Сопоставление шаблонов на основе правил
- Методы обучения с учителем
- Дистанционное обучение и слабое обучение
- Тонкая настройка предварительно обученных моделей
Прикладная ценность:
- Построение графов знаний
- Интеллектуальные системы вопросов и ответов
- Мониторинг новостных событий
- Анализ финансовых рисков
Автоматическое реферирование
Типы реферирования:
- Экстрактивная суммаризация: выбор важных предложений из исходного текста
- Абстрактивная суммаризация: генерация нового текста сводки
- Гибридная суммаризация: сочетание экстрактивных и генеративных методов
Технические проблемы:
- Выявление важной информации
- Связность и читабельность сводок
- Согласованность в многодокументной суммаризации
- Контроль длины сводки
Сценарии применения:
- Суммаризация новостей
- Аннотации научных статей
- Суммаризация юридических документов
- Генерация протоколов совещаний
Основные вызовы, стоящие перед NLP
Неоднозначность языка
Лексическая неоднозначность
- Полисемия:
- «打» (dǎ): ударить, купить, включить и т. д.
- «行» (xíng/háng): ладно / банк / ходить и т. д.
- Омофоны:
- Китайский: употребление «的, 地, 得»
- Английский: «there, their, they're»
Синтаксическая неоднозначность
- Неясные отношения модификации:
- «美丽of花儿of香味» (Красив ли цветок или красив аромат?)
- Множественные структурные анализы:
- Я увидел девушку, держащую зонт
Семантическая неоднозначность
- Неясная референция:
- "Ли Мин сказал Чжан Хуа, что он очень умный" (Кто умный?)
- Неоднозначность области действия:
- Все студенты не любят этого учителя
Решения:
- Использование контекстной информации
- Вероятностное суждение языковых моделей
- Помощь от баз знаний
- Многозадачное обучение
Понимание контекста
Локальный контекст
- Семантические зависимости внутри предложения
- Понимание словосочетаний и клауз
- Семантические отношения между словами
Глобальный контекст
- Семантическая связность на уровне абзаца и документа
- Тематическая непрерывность
- Дальние семантические зависимости
Контекст диалога
- Историческая информация в многоходовом диалоге
- Рассуждение о неявной информации
- Эволюция намерения диалога
Технические проблемы:
- Дальние зависимостиТрадиционные RNN с трудом справляются с длинными последовательностями
- Семантическая связностьПоддержание логической согласованности в сгенерированном тексте
- Рассуждения на основе здравого смыслаТребуются обширные фоновые знания
Решения:
- Механизмы внимания и Трансформеры
- Предобученные языковые модели
- Модели, дополненные знаниями
- Слияние мультимодальной информации
Культурные и языковые различия
Межъязыковые проблемы
- Различия языковых семей:
- Сино-тибетские vs индоевропейские
- Богатая морфология vs важность порядка слов
- Различия систем письма:
- Разные размеры наборов символов
- Различные методы токенизации
Культурный фон
- Идиомы и разговорные выражения:
- "Нарисовать змее ноги" vs "не делите шкуру неубитого медведя"
- Культурно-специфичные выражения:
- Китайское понятие "лица" (мяньцзы)
- Японская система гоноративов
Социолингвистические факторы
- Диалектные различия:
- Путунхуа vs различные региональные диалекты
- Стандартный английский vs диалектный английский
- Регистровая вариативность:
- Формальный и неформальный стили речи
- Устная и письменная речь
Стратегии решения:
- Многоязычные предварительно обученные модели
- Кросс-языковое трансферное обучение
- Культурная адаптация
- Сбор локализованных данных
Проблемы нехватки данных
Низкоресурсные языки
- В мире насчитывается более 7,000 языков, но лишь немногие имеют обширные цифровые ресурсы
- Сохранение и исследование исчезающих языков
- Диалекты и языки меньшинств
Профессиональные области
- Терминология в специализированных областях, таких как медицина и право
- Отраслевые выражения
- Сложность получения размеченных данных
Новые области
- Новая лексика, порождаемая новыми технологиями
- Новые выражения в социальных сетях
- Новые формы межкультурной коммуникации
Эволюция во времени
- Исторические изменения в языке
- Быстрое появление новых слов
- Постепенные семантические сдвиги
Решения:
- Перенос обучения: перенос от высокоресурсных языков к низкоресурсным языкам
- Аугментация данных: расширение обучающих данных с помощью различных методов
- Обучение на малом числе примеров: быстрая адаптация при небольшом количестве образцов
- Обучение без учителя и самоконтролируемое обучение: снижение зависимости от размеченных данных
- Краудсорсинговая разметка: использование коллективного интеллекта для сбора данных
- Синтетические данные: генерация обучающих данных с помощью правил или моделей
Вычислительная сложность
Проблемы масштаба модели
- Взрывной рост числа параметров (GPT-3: 175 миллиардов параметров)
- Быстрорастущие затраты на обучение
- Задержка вывода и потребление ресурсов
Требования реального времени
- Ответы на уровне миллисекунд для поисковых систем
- Взаимодействие в реальном времени в диалоговых системах
- Ограничения ресурсов на мобильных устройствах
Проблемы масштабируемости
- Обработка массовых запросов пользователей
- Унифицированная обработка множества языков и задач
- Вычислительные требования персонализированных сервисов
Проблемы оценки и количественного измерения
Проблемы субъективности
- Субъективная оценка качества текста
- Культурные различия в качестве перевода
- Критерии оценки творческого письма
Ограничения метрик оценки
- Несовершенства метрик, таких как BLEU и ROUGE
- Различия между автоматической оценкой и оценкой человеком
- Сложность многомерной оценки
Эталонные наборы данных
- Репрезентативность наборов данных
- Разрыв между задачами оценки и реальными приложениями
- Своевременность и обновление наборов данных
Итоги и перспективы
Обработка естественного языка как ключевая ветвь искусственного интеллекта прошла путь развития от управляемого правилами к управляемому данными, а затем к управляемому большими моделями. Каждый этап имеет свои уникальные технические характеристики и исторический вклад.
Текущее состояние:
- Большие языковые модели демонстрируют удивительные способности к пониманию и генерации языка
- Мультимодальное слияние становится новым направлением развития
- Сферы применения продолжают расширяться, а коммерческая ценность становится всё более заметной
Будущие тенденции:
- Общий искусственный интеллект: На пути к более универсальным и интеллектуальным системам ИИ
- Мультимодальное слияние: Комплексная интеграция текста, визуальной и звуковой информации
- Персонализированные сервисы: Более точное персонализированное понимание и генерация языка
- Объяснимость: Повышение прозрачности процессов принятия решений моделью
- Оптимизация эффективности: Снижение вычислительных затрат при сохранении производительности
- Этика и безопасность: Обеспечение справедливости, безопасности и управляемости систем ИИ
Рекомендации по обучению:
Для изучающих NLP рекомендуется:
- Прочная основа: Глубокое понимание основ лингвистики и информатики
- Практическая направленность: Углубление понимания через проектную практику
- Отслеживание передовых направлений: уделяйте внимание последним технологическим достижениям и исследовательским тенденциям
- Междисциплинарное мышление: объединяйте знания из лингвистики, психологии, социологии и других дисциплин
- Инженерные компетенции: развивайте способность превращать результаты исследований в практические приложения
Будущее обработки естественного языка полно возможностей и вызовов. Благодаря непрерывному технологическому прогрессу у нас есть основания полагать, что способность машин понимать и генерировать человеческий язык будет продолжать улучшаться, принося человеческому обществу больше удобства и ценности.
Дополнительные расширения