Django ORM – 多テーブルの例(集約とグループ化クエリ)
集約クエリ(aggregate)
集約クエリ関数は、値のグループに対して計算を実行し、単一の値を返します。
Django で集約クエリを使用する前に、django.db.models から Avg、Max、Min、Count、Sum(先頭は大文字)をインポートする必要があります。
from django.db.models import Avg,Max,Min,Count,Sum # 引入函数
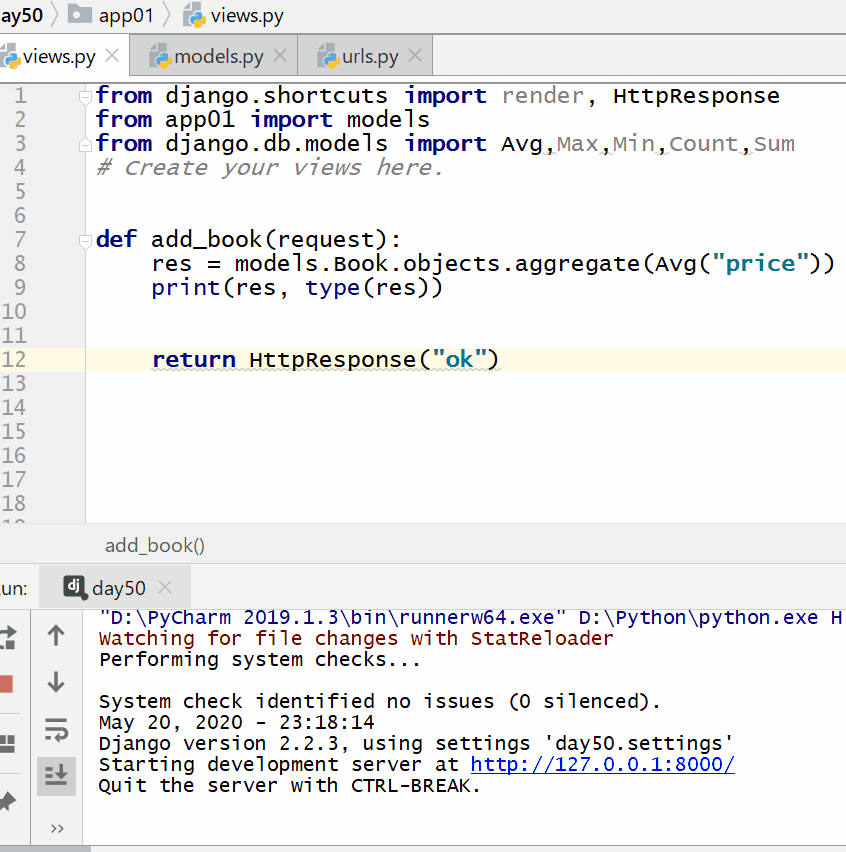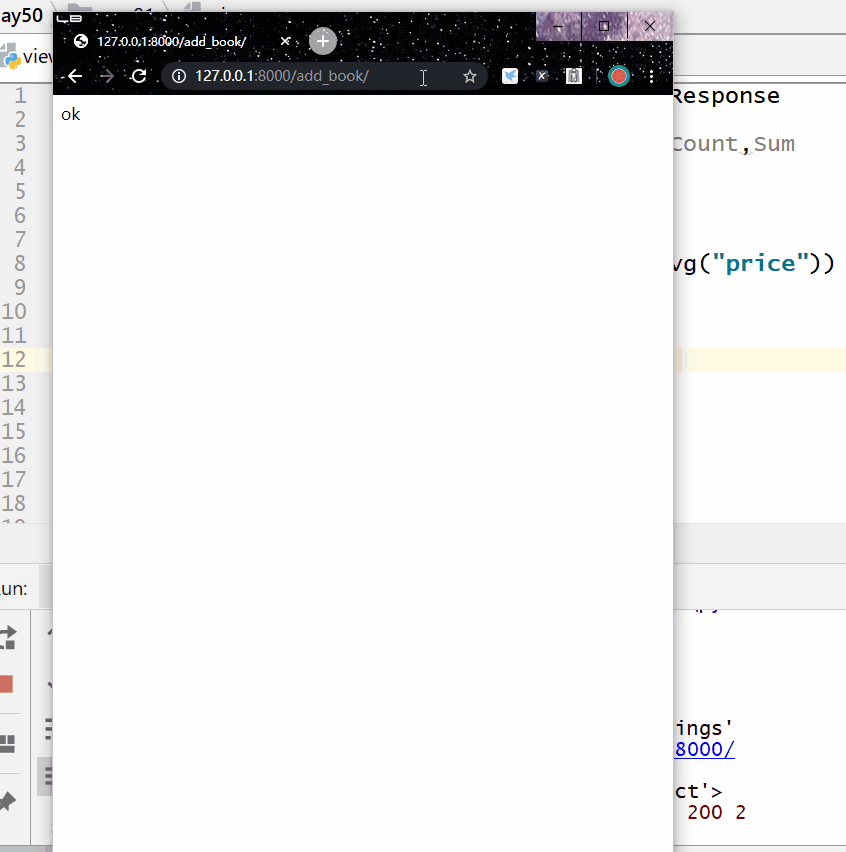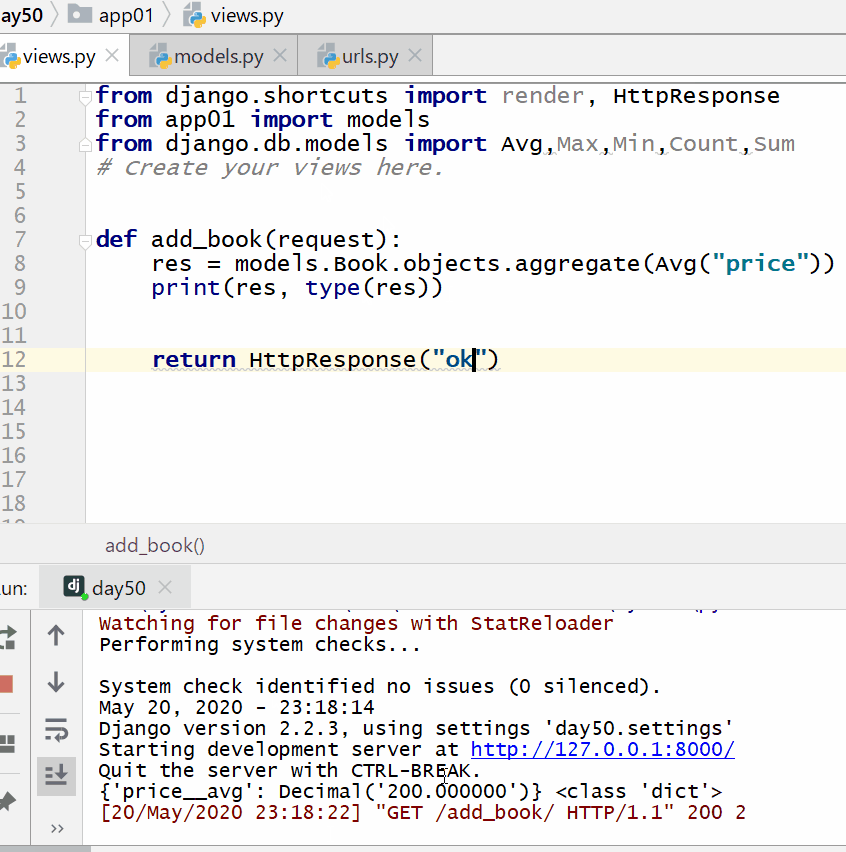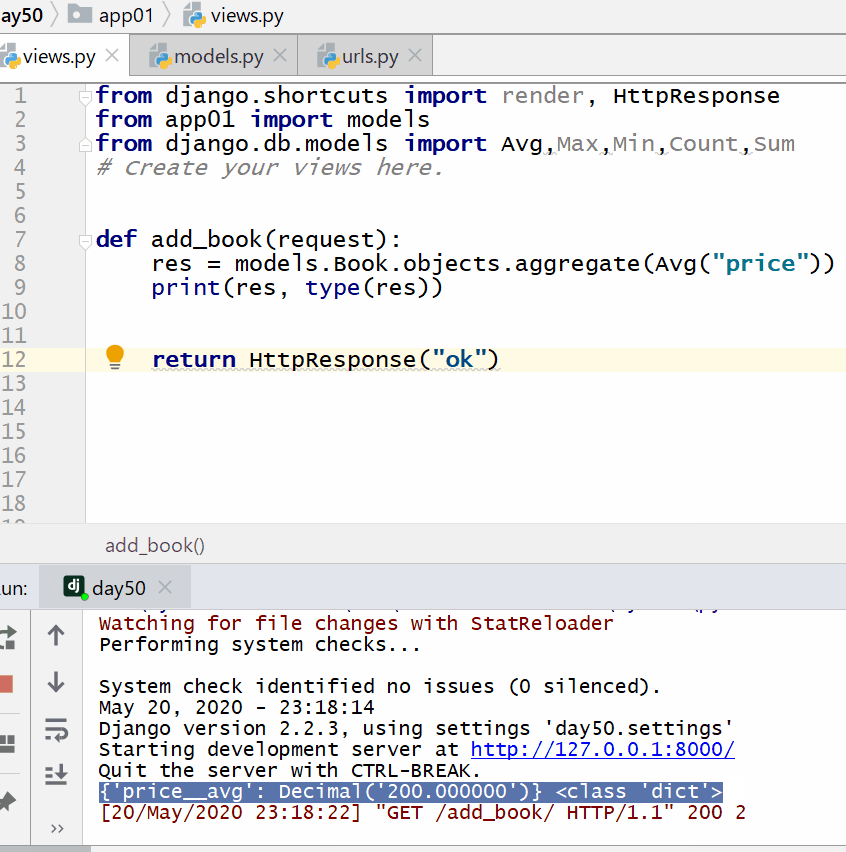
集約クエリの戻り値のデータ型は辞書です。
集約関数 aggregate() は QuerySet の終端句であり、集計値を生成します。これは count() に相当します。
aggregate() を使用すると、データ型は辞書になるため、QuerySet データ型の一部の API は使用できなくなります。
日付データ型(DateField)には Max と Min を使用できます。
返される辞書では、キーの名前はデフォルトで(属性名に __ と集約関数名を加えたもの)になり、値は計算された集約値です。
返される辞書のキー名をカスタマイズする場合は、エイリアスを設定できます:
aggregate(别名 = 聚合函数名("属性名称"))
すべての書籍の平均価格を計算する:
例
...
res = models.Book.objects.aggregate(Avg("price"))
print(res, type(res))
...
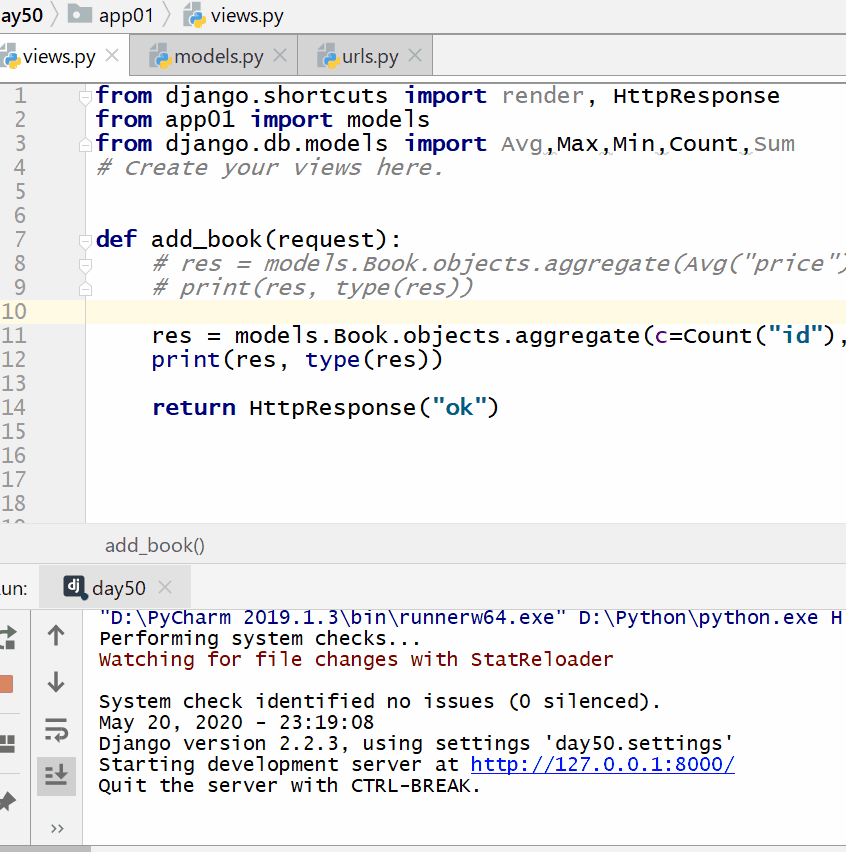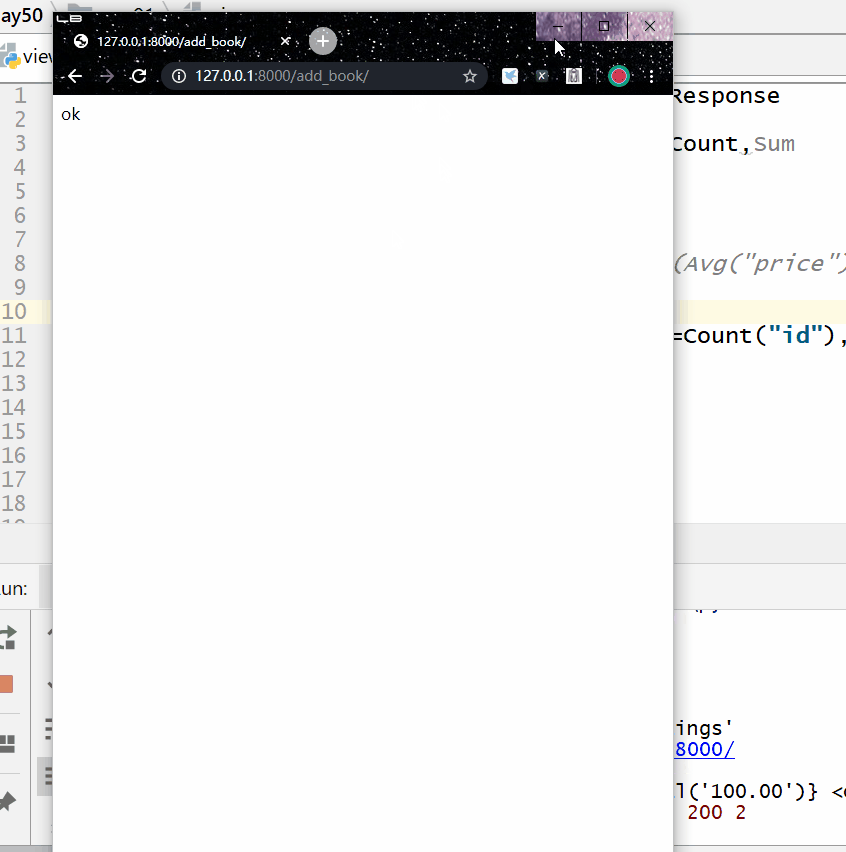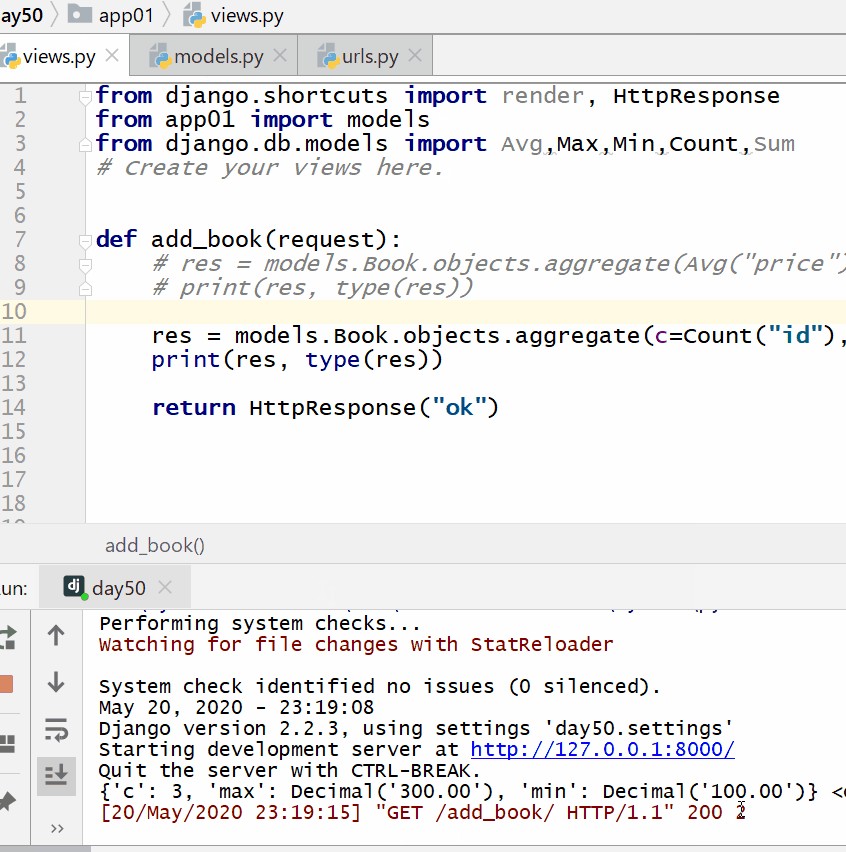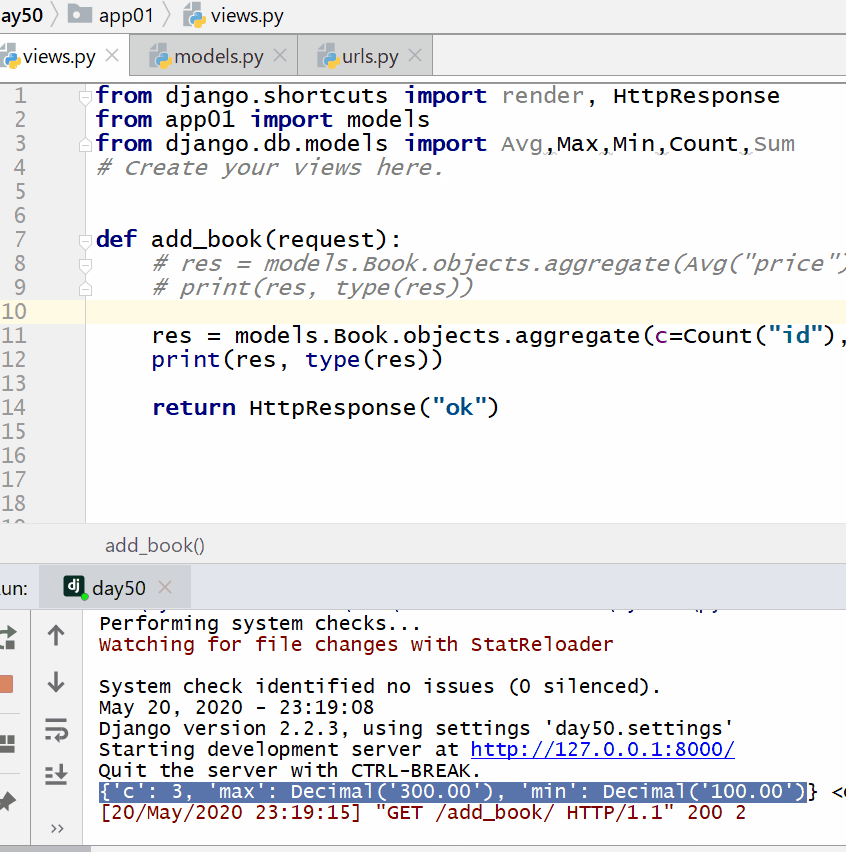
すべての書籍の数、最高価格、最低価格を計算する:
例
print(res,type(res)
グループ化クエリ(annotate)
グループ化クエリでは通常、集約関数を使用するため、使用前に django.db.models から Avg, Max, Min, Count, Sum(先頭は大文字)をインポートする必要があります。
from django.db.models import Avg,Max,Min,Count,Sum # 引入函数
戻り値:
- グループ化後、values で値を取得すると、戻り値は QuerySet データ型内の辞書の集合になります。
- グループ化後、values_list で値を取得すると、戻り値は QuerySet データ型内のタプルの集合になります。
MySQL の limit は ORM の QuerySet データ型のスライスに相当します。
注意:
annotate には集約関数を置きます。
-
values または values_list は annotate の前に置きます:values または values_list はどのフィールドでグループ化するかを宣言し、annotate がグループ化を実行します。
-
values または values_list を annotate の後ろに置く場合:annotate は現在のテーブルの pk で直接グループ化を実行することを示し、values または values_list はどのフィールドをクエリするかを示します。また、annotate 内の集約関数にエイリアスを付け、values または values_list にそのエイリアスを記述する必要があります。
データの準備とモデルの作成
models.py
name = models.CharField(max_length=32)
age = models.IntegerField()
salary = models.DecimalField(max_digits=8, decimal_places=2)
dep = models.CharField(max_length=32)
province = models.CharField(max_length=32)
class Emps(models.Model):
name = models.CharField(max_length=32)
age = models.IntegerField()
salary = models.DecimalField(max_digits=8, decimal_places=2)
dep = models.ForeignKey("Dep", on_delete=models.CASCADE)
province = models.CharField(max_length=32)
class Dep(models.Model):
title = models.CharField(max_length=32)
データ:
MySQL コマンドラインで実行する:
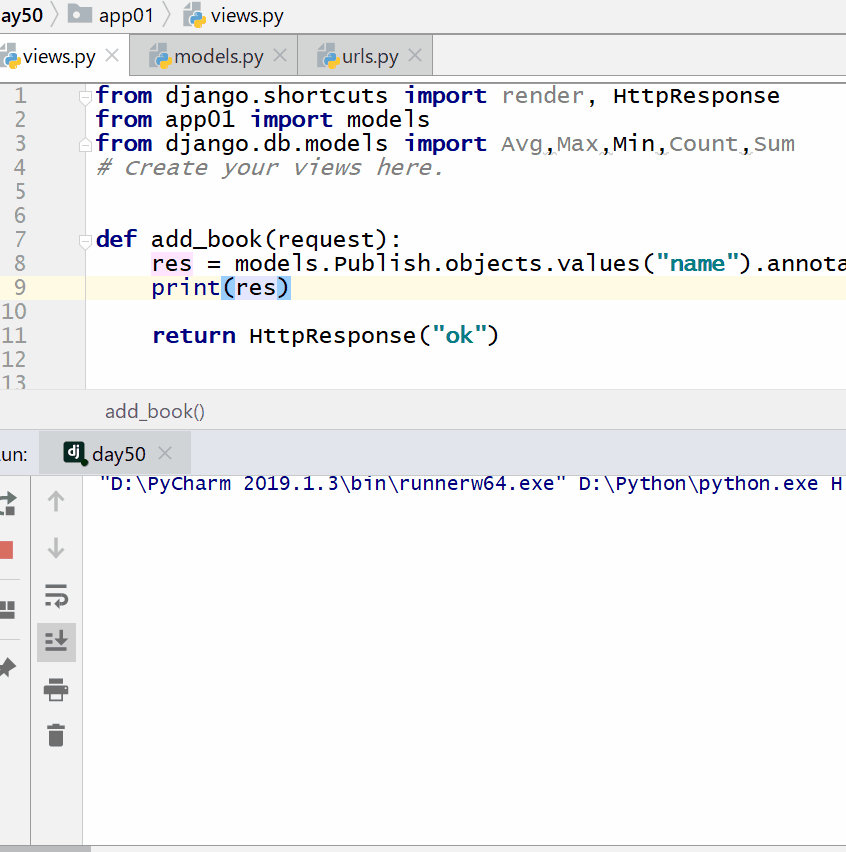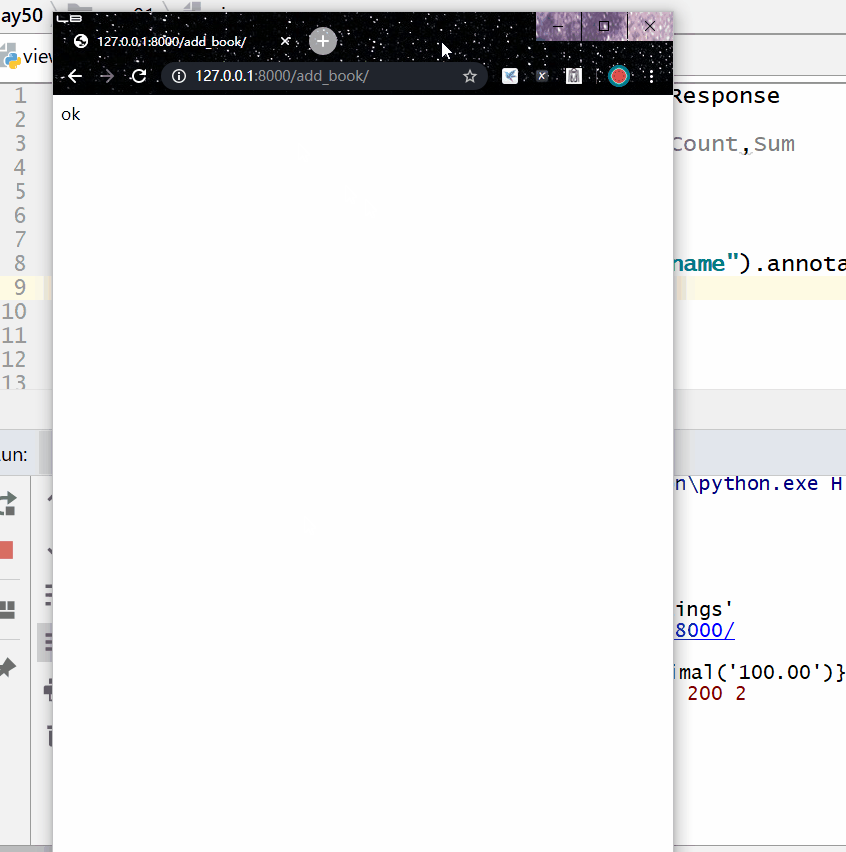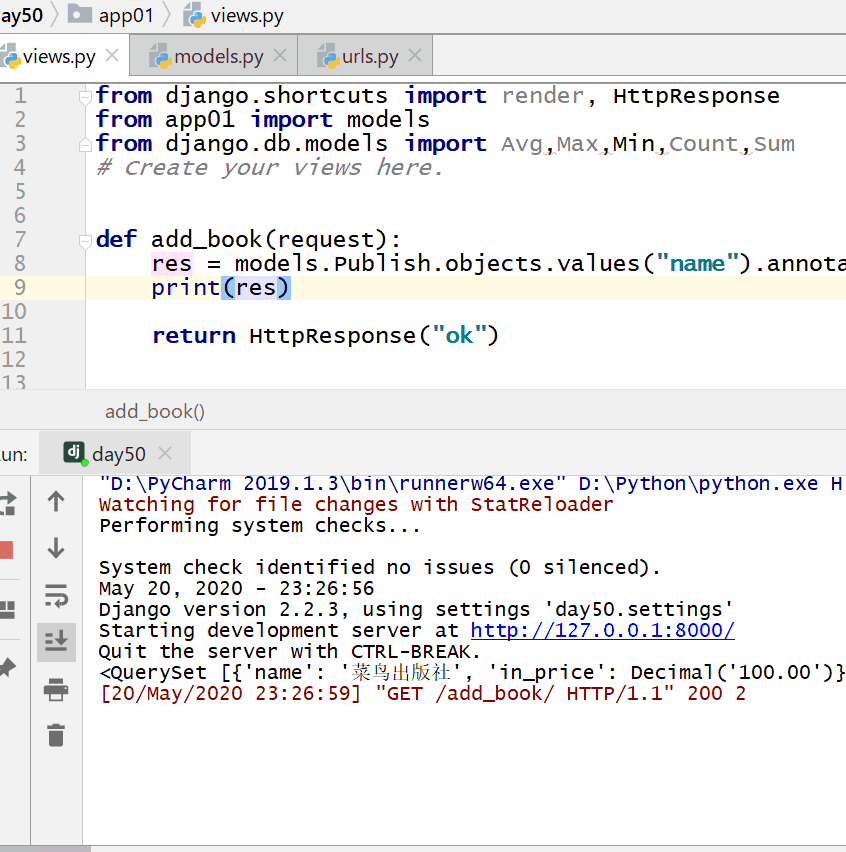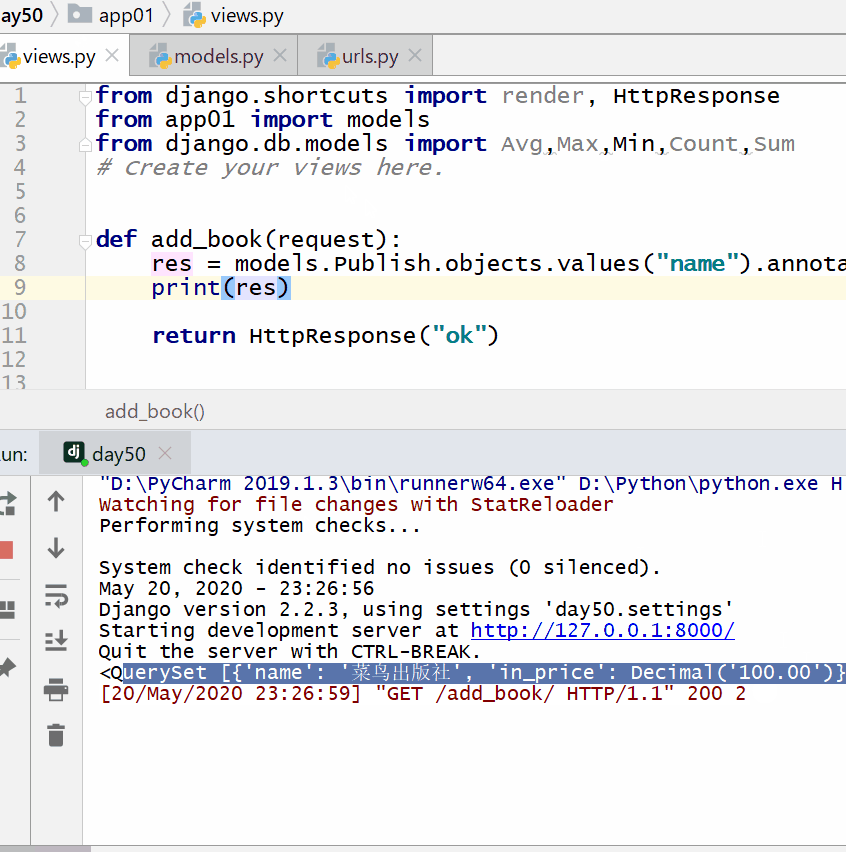
各出版社の最も安い本の価格を集計する:
例
print(res)
コマンドラインで以下の出力を確認できます:
<QuerySet [{'name': 'サンプル出版社', 'in_price': Decimal('100.00')}, {'name': '明教出版社', 'in_price': Decimal('300.00')}]>
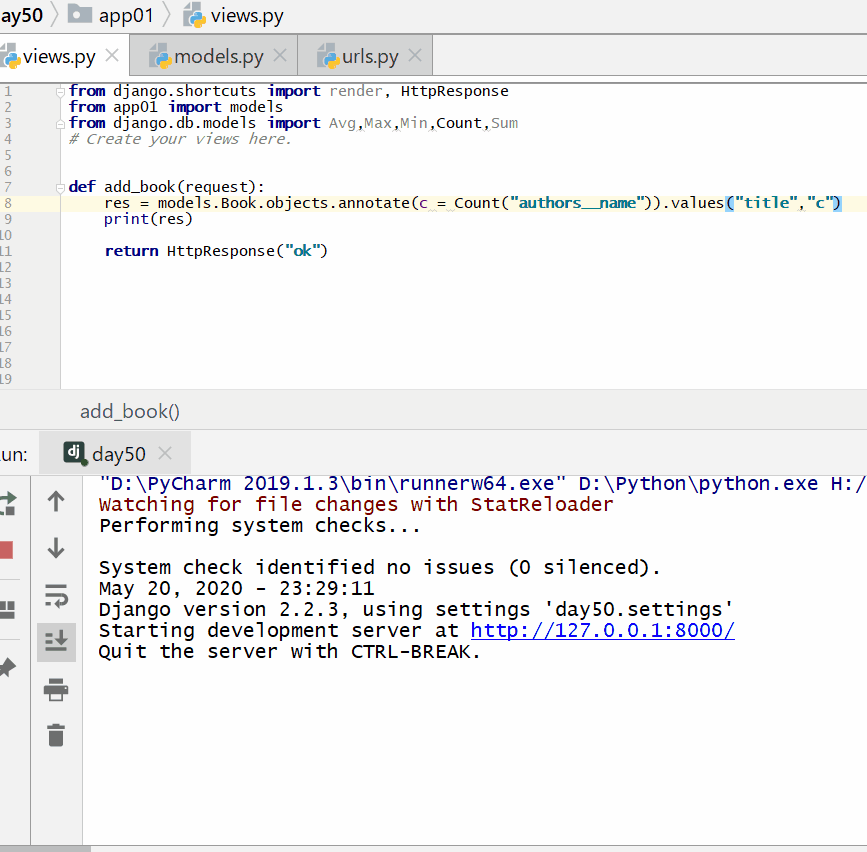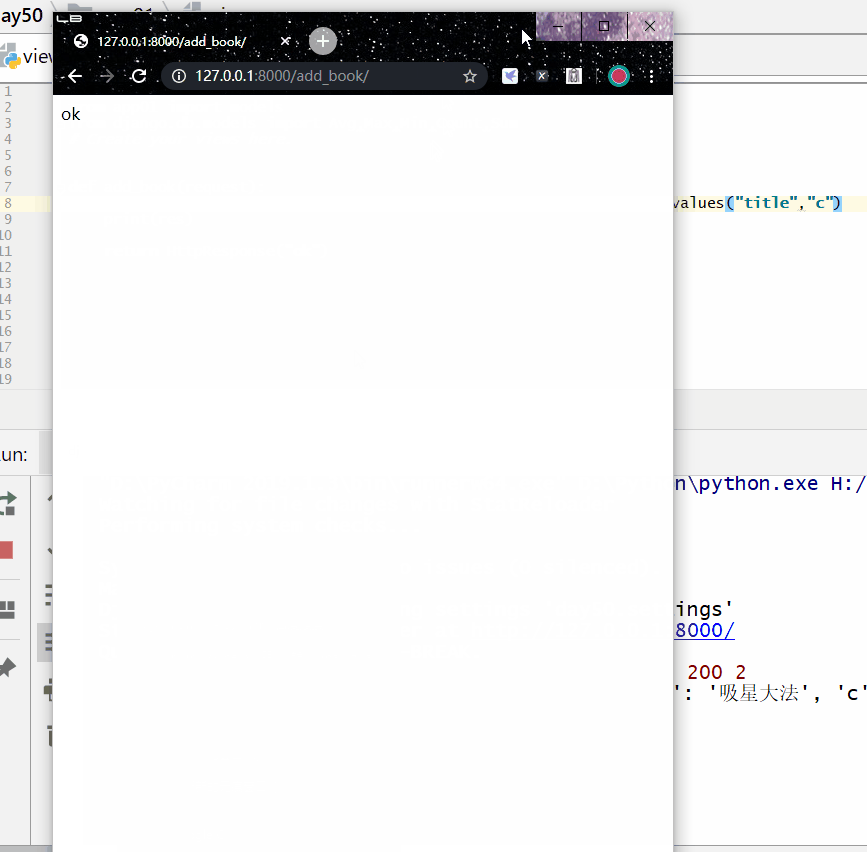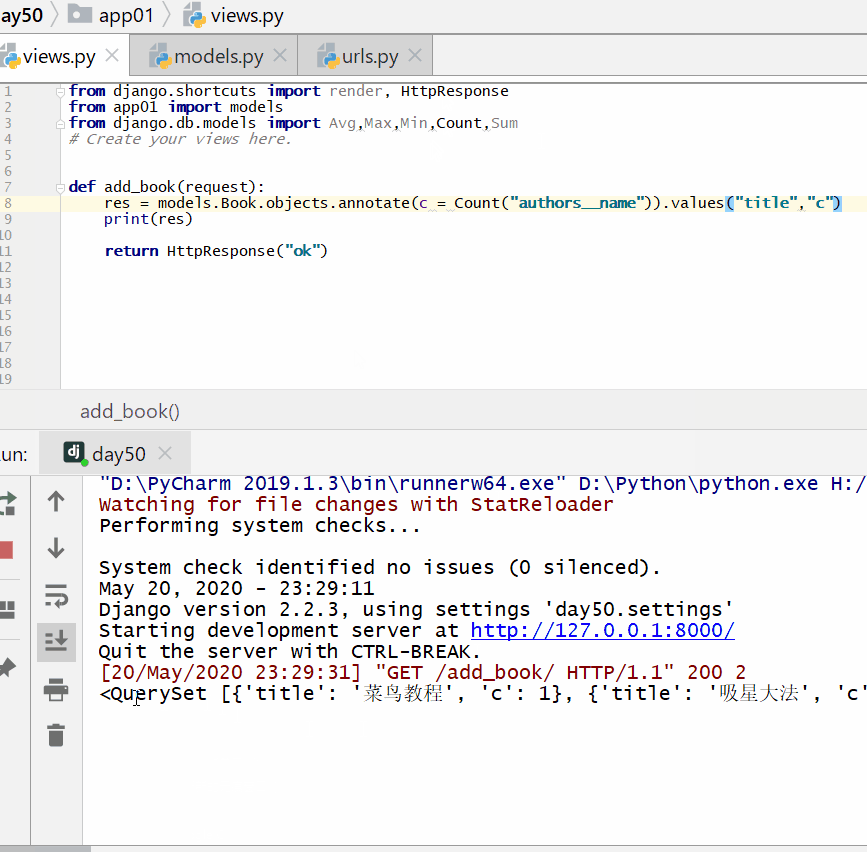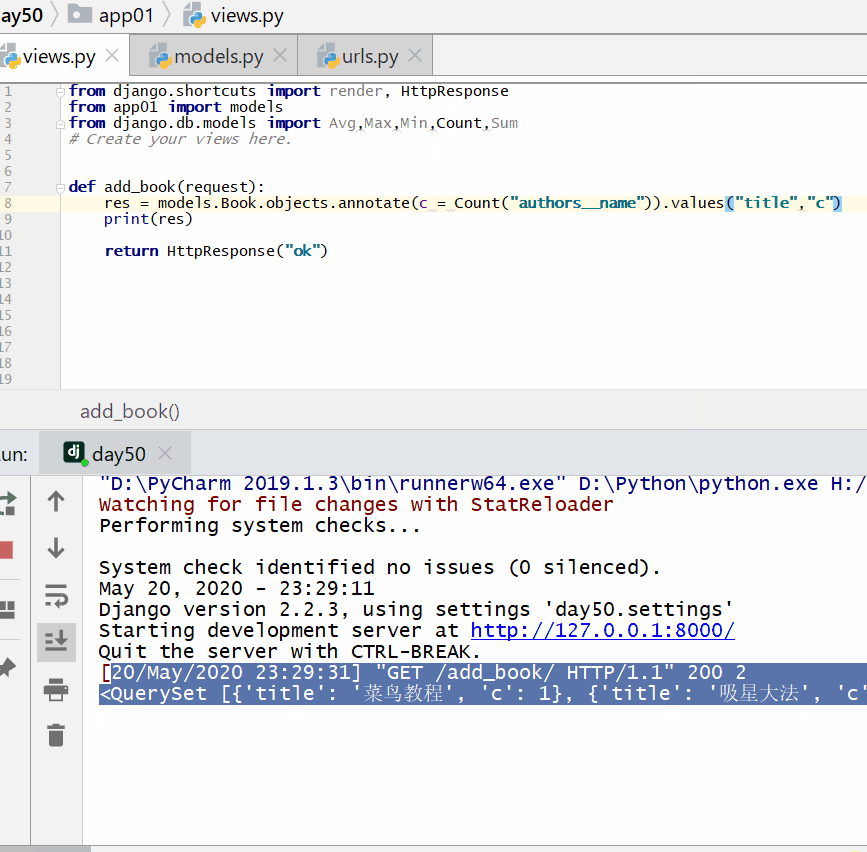
各本の著者数を集計する:
例
print(res)
<QuerySet [{'title': 'サンプル', 'c': 1}, {'title': '吸星大法', 'c': 1}, {'title': '冲灵剑法', 'c': 1}]>
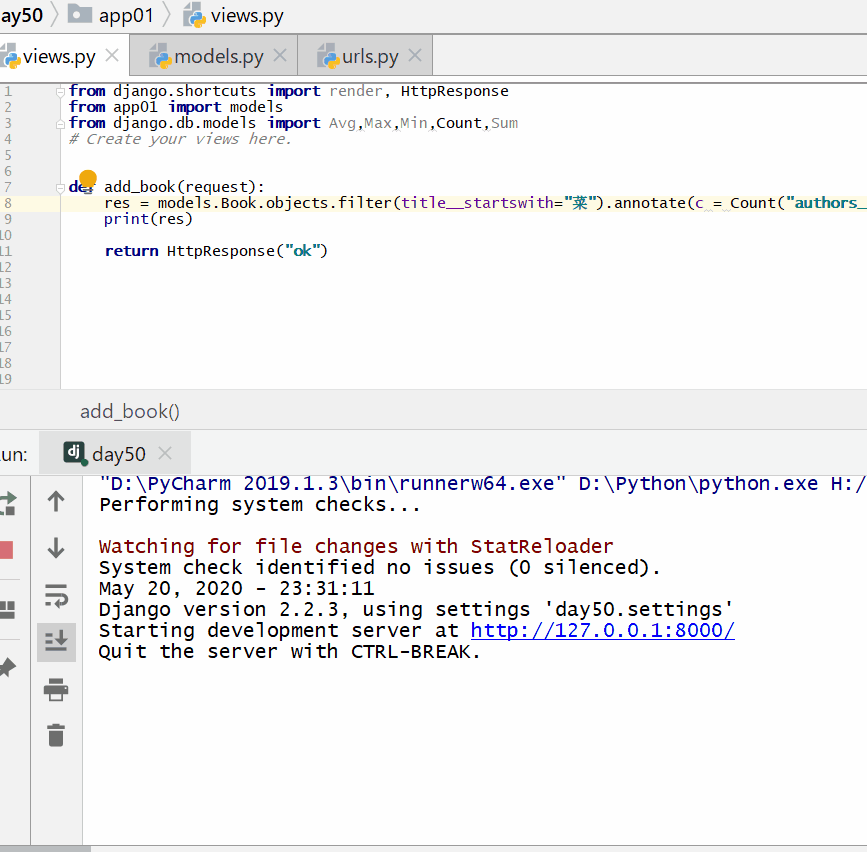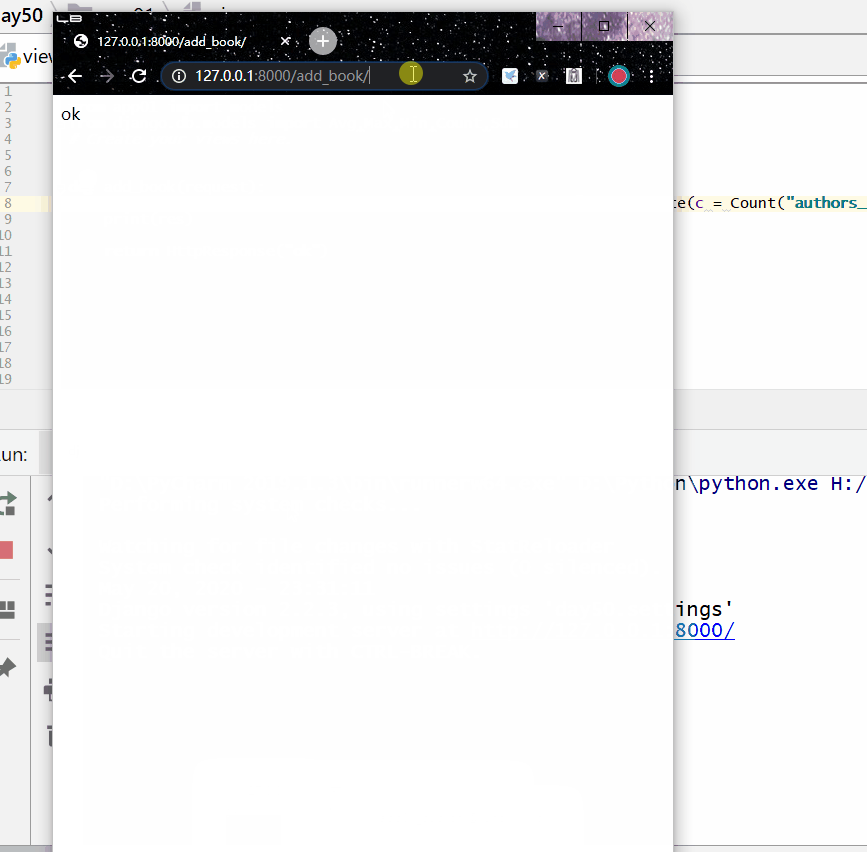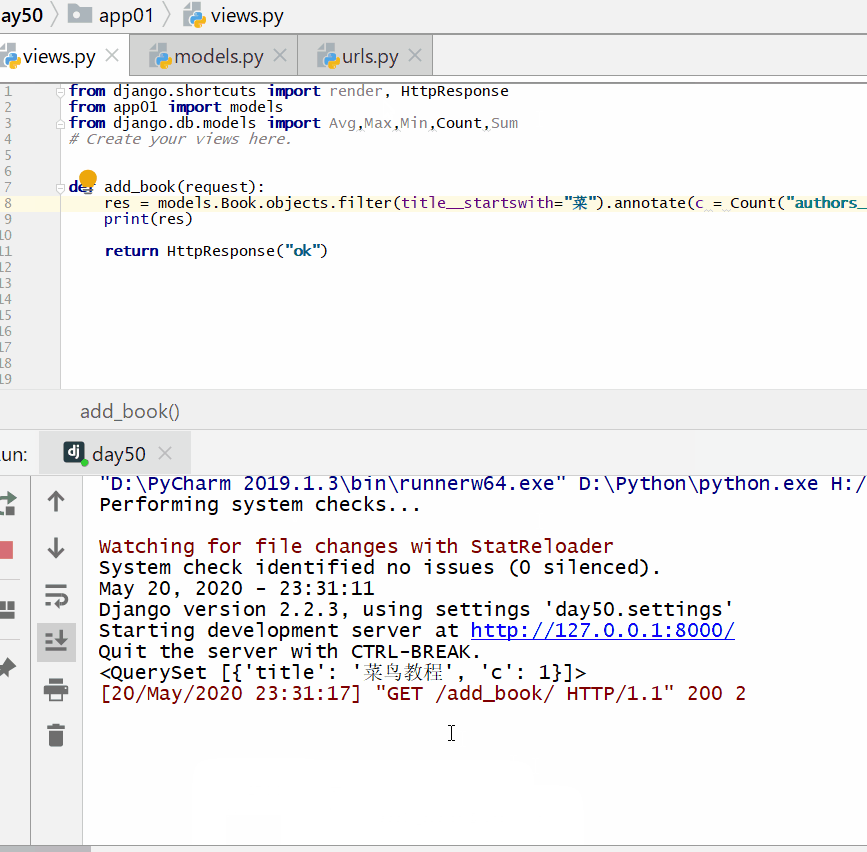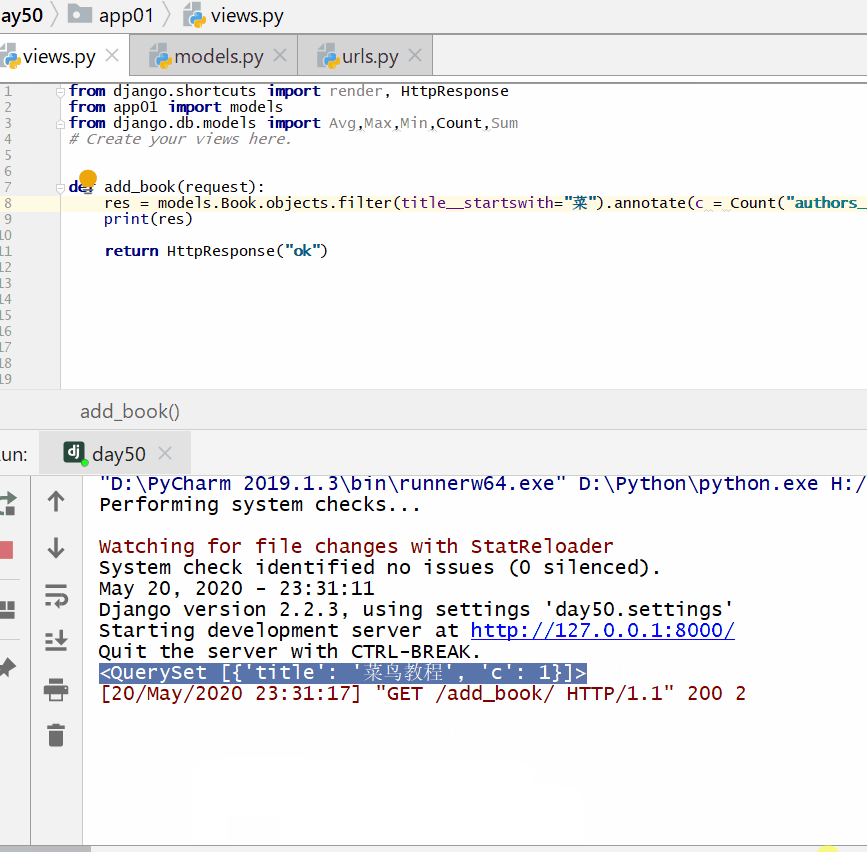
「菜」で始まる各書籍の著者数を集計する:
例
print(res)
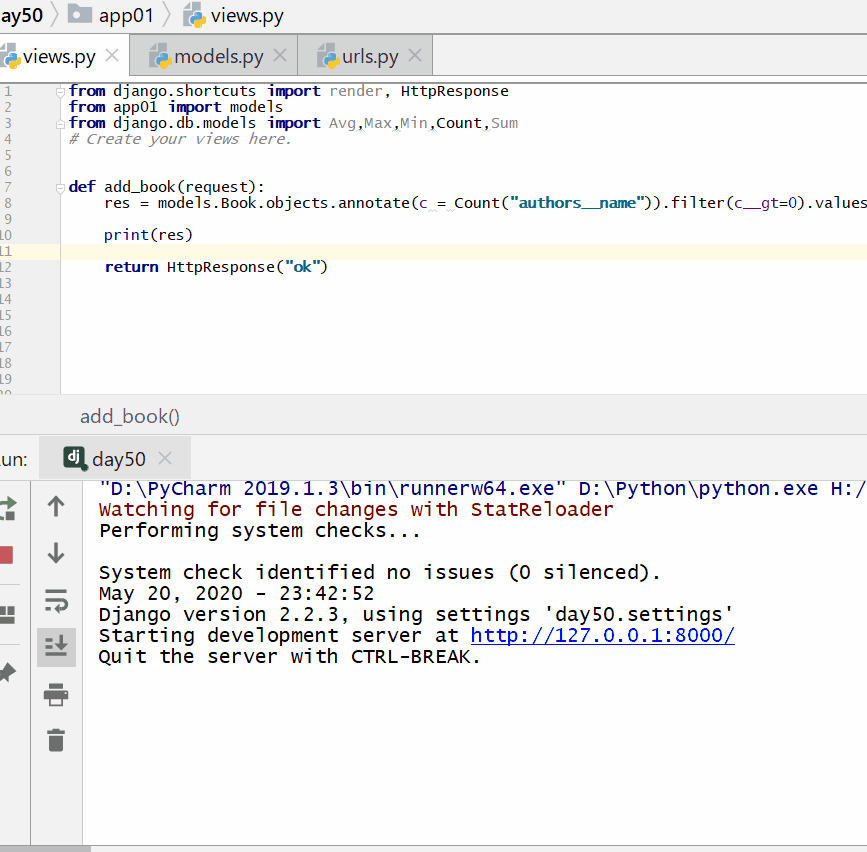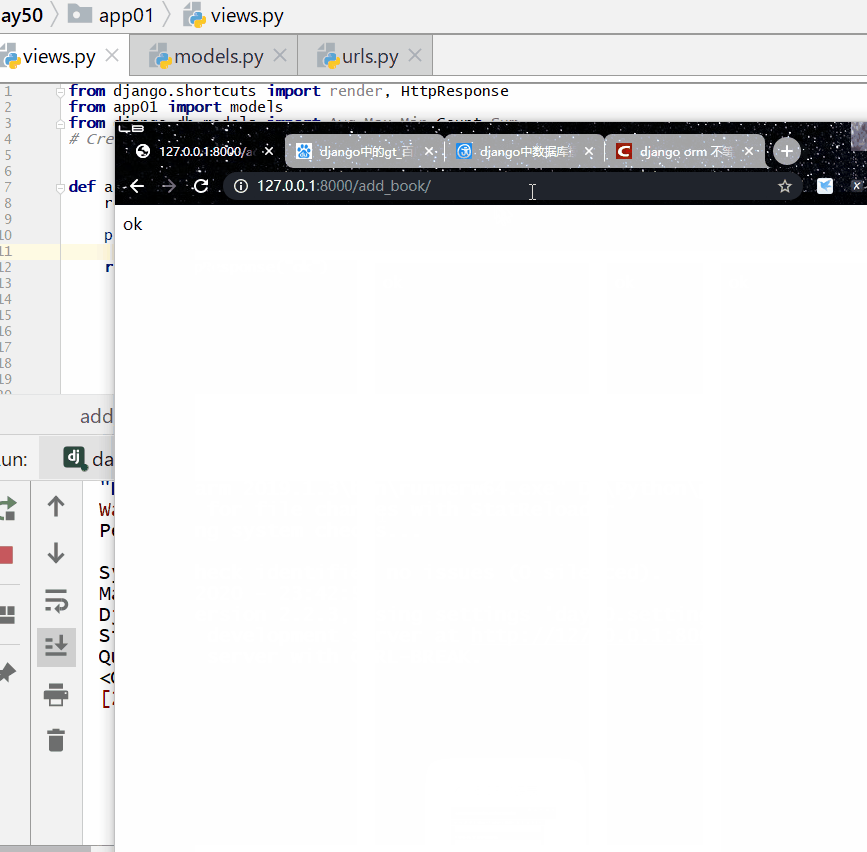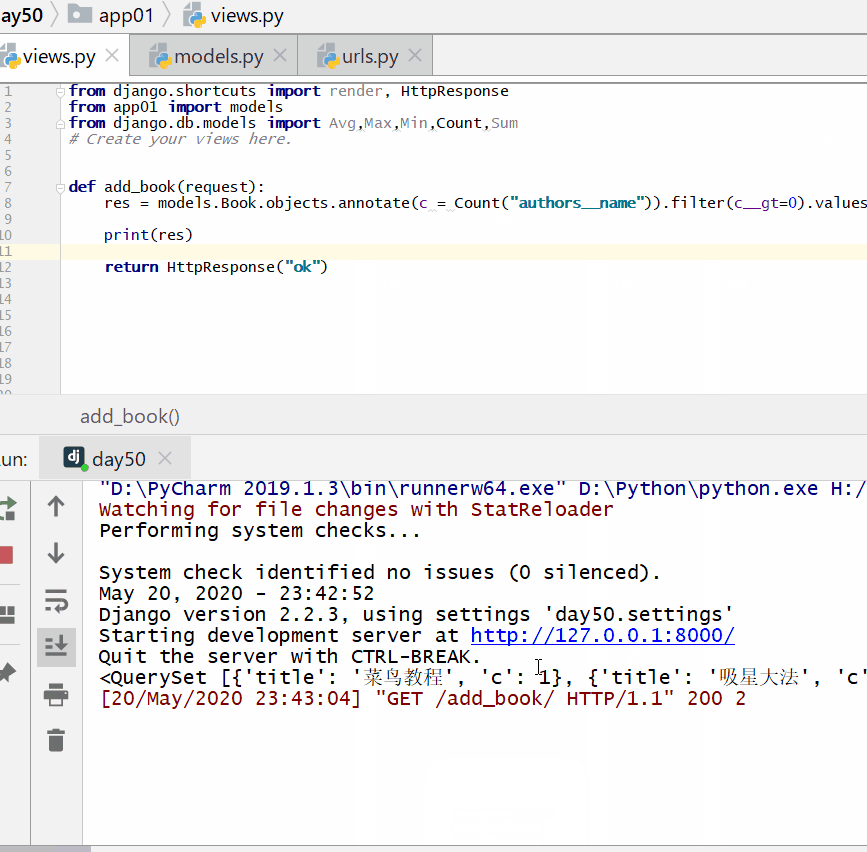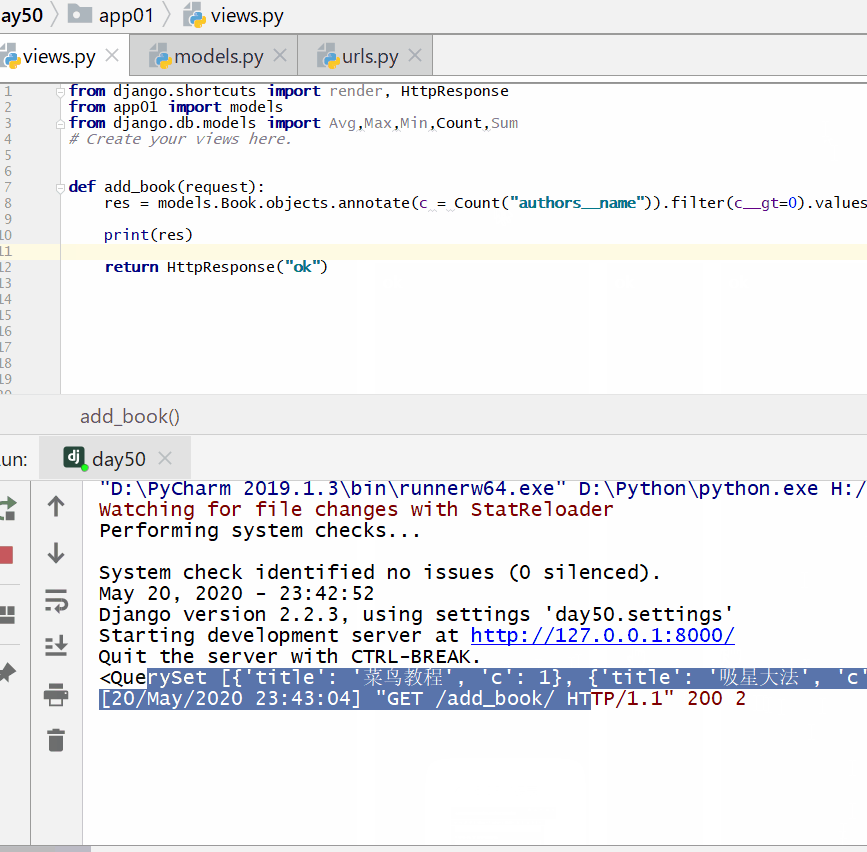
著者が複数いる書籍の名称を集計する:
例
print(res)
<QuerySet [{'title': 'サンプル', 'c': 1}, {'title': '吸星大法', 'c': 1}, {'title': '冲灵剑法', 'c': 1}]>
1冊の本の著者数に基づいて、クエリセット QuerySet を降順に並べ替える:
例
print(res)
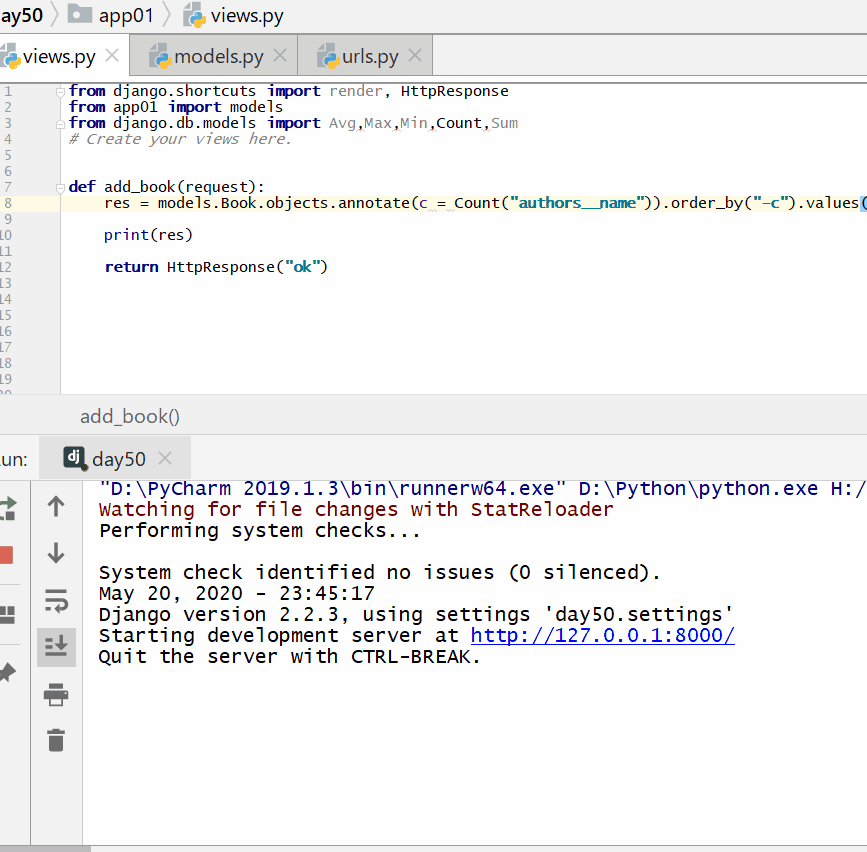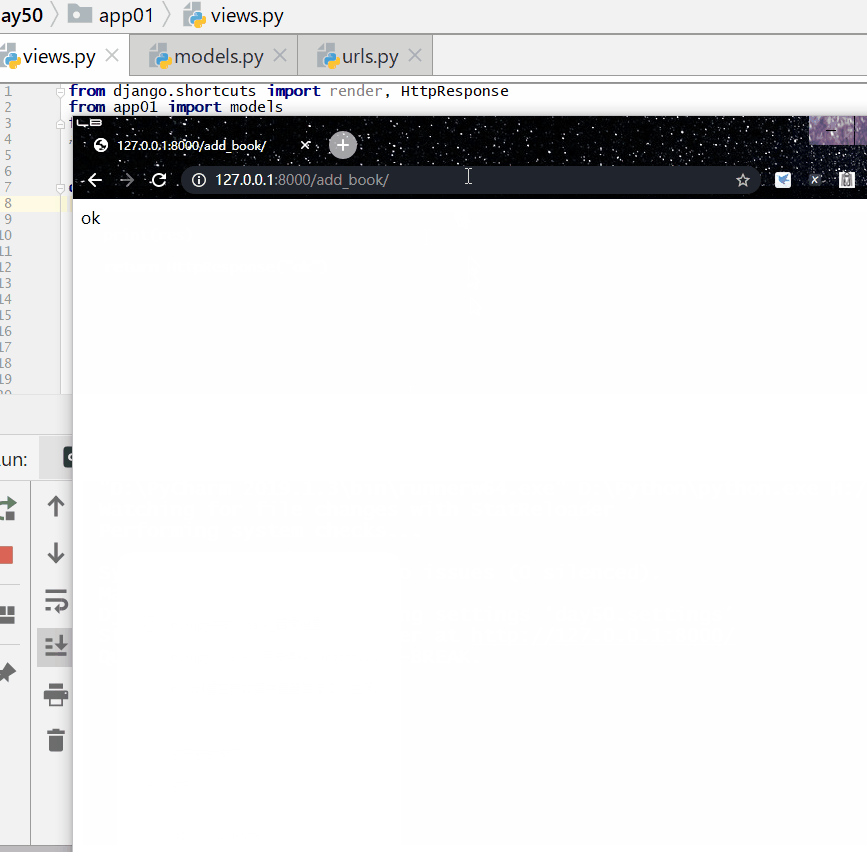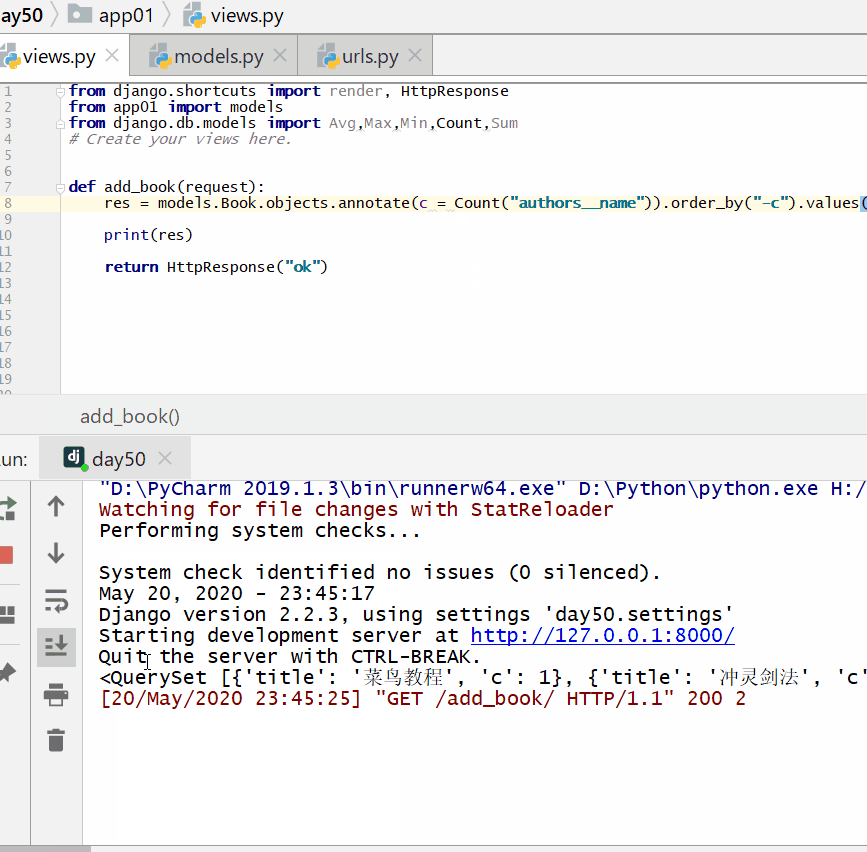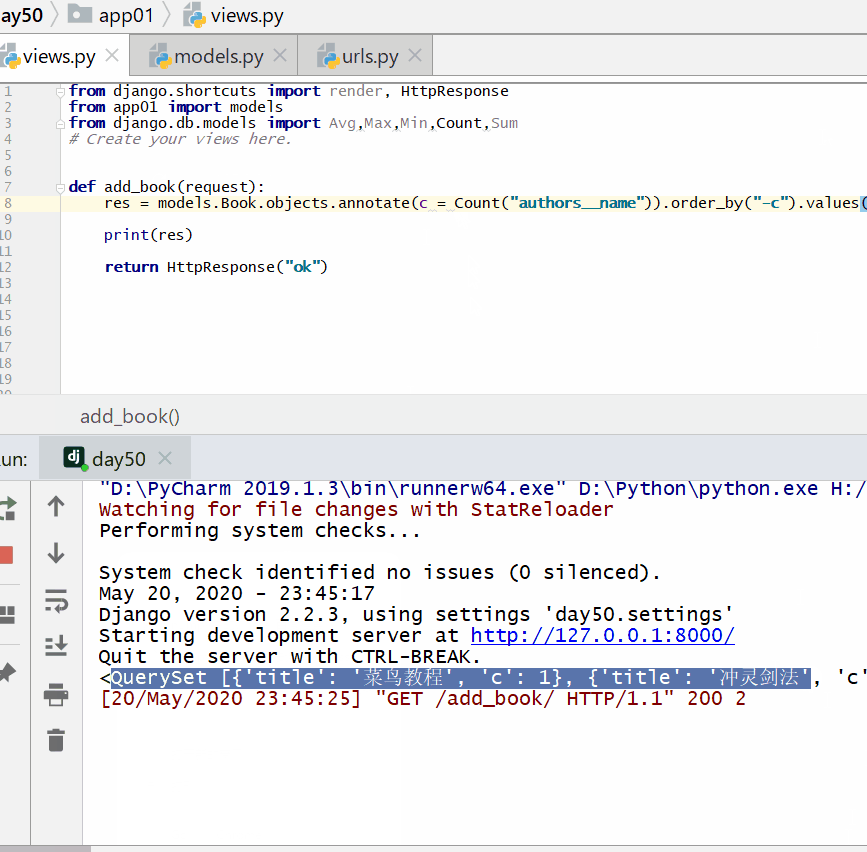
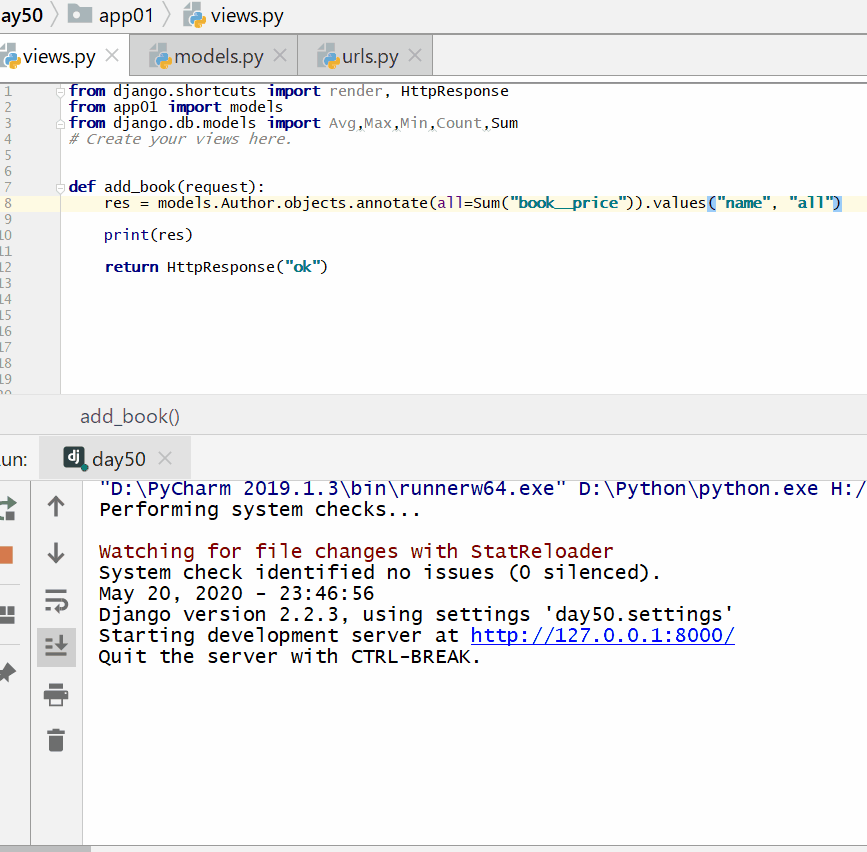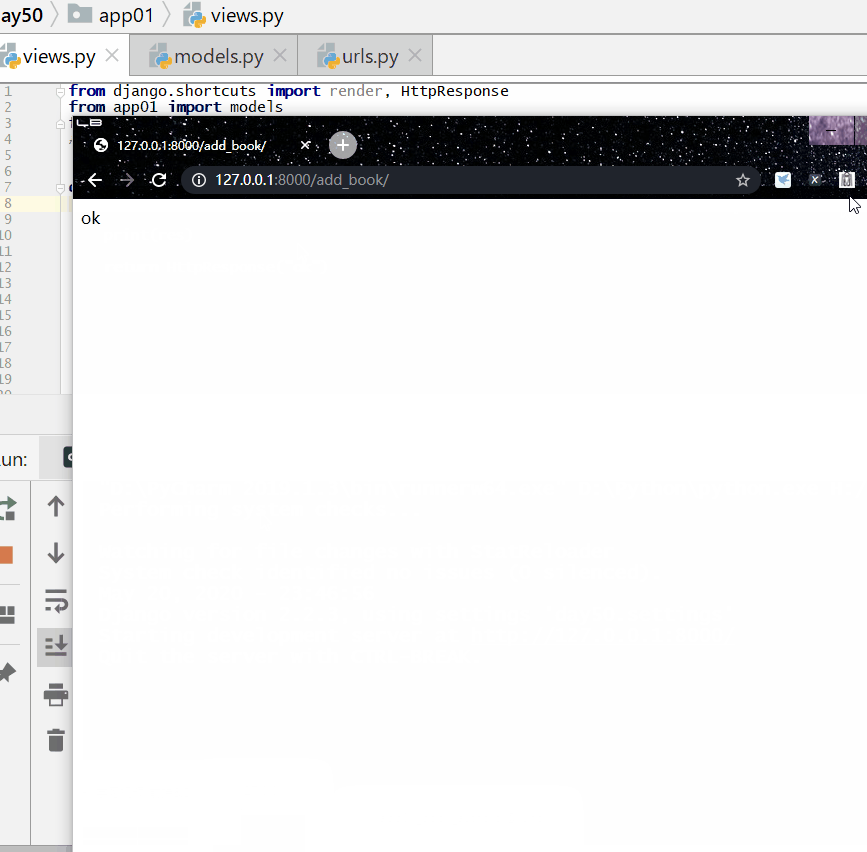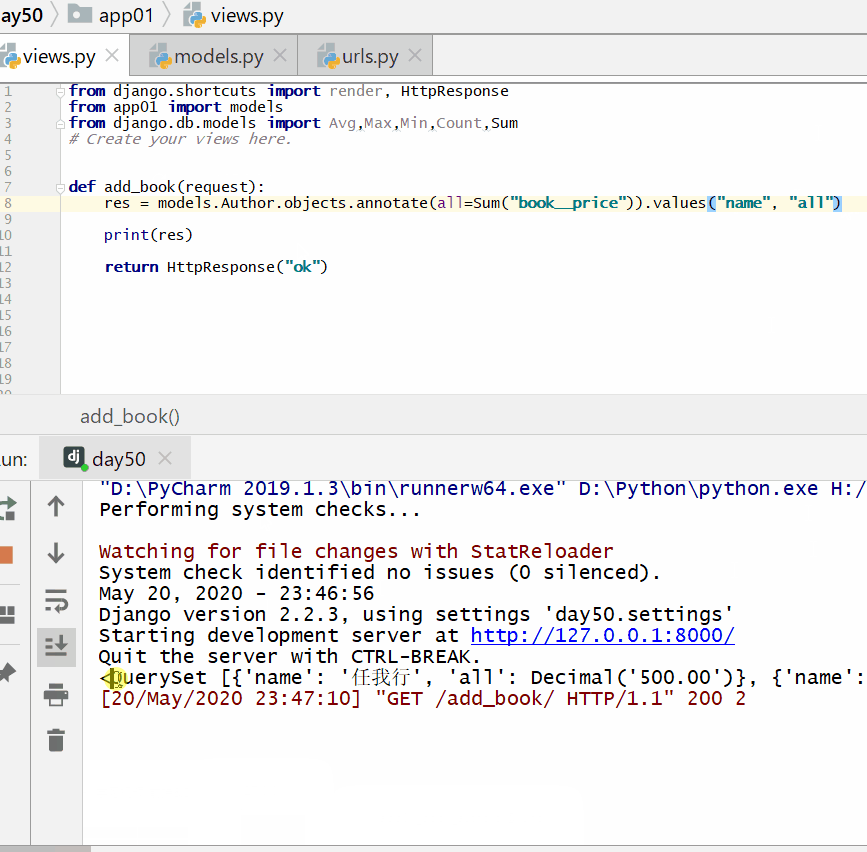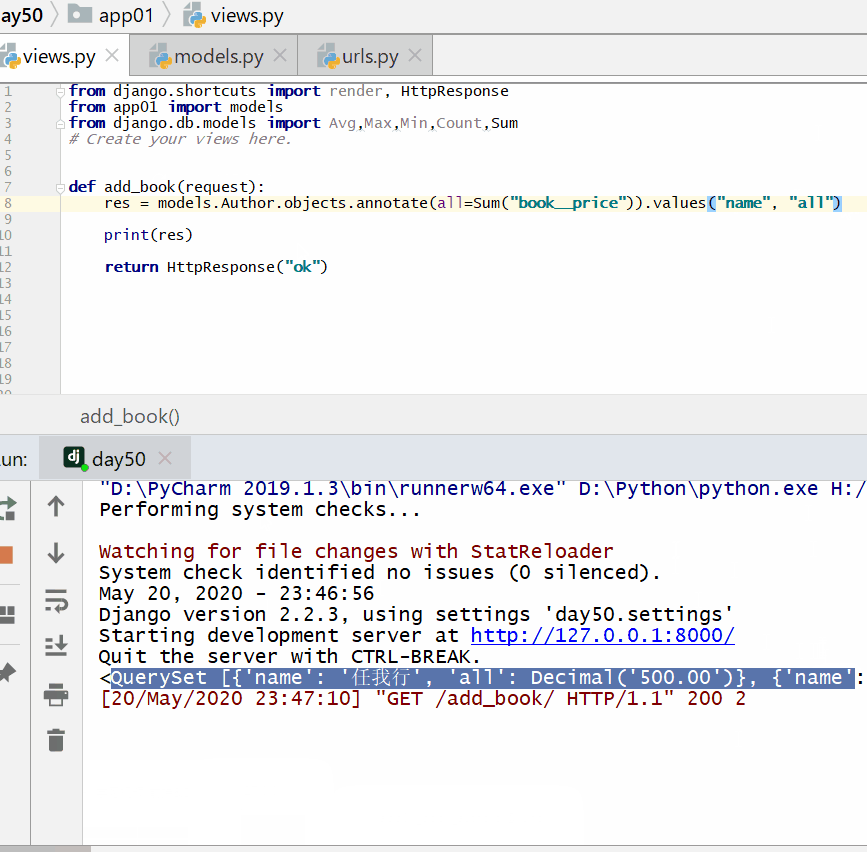
各著者が出版した本の合計価格をクエリする:
例
print(res)
F() クエリ
F() のインスタンスはクエリ内でフィールドを参照し、同じ model インスタンス内の2つの異なるフィールドの値を比較できます。
これまでに構築したフィルタは、フィールド値を定数と比較するだけでした。2つのフィールドの値を比較したい場合は、F() を使用する必要があります。
使用前に django.db.models から F をインポートする必要があります:
from django.db.models import F
用法:
F("字段名称")
F はオブジェクトのフィールドの値を動的に取得し、演算を行うことができます。
Django は、F() オブジェクト同士および F() オブジェクトと定数との間の加算、減算、乗算、除算、剰余演算をサポートしています。
更新操作(update)でも F() 関数を使用できます。
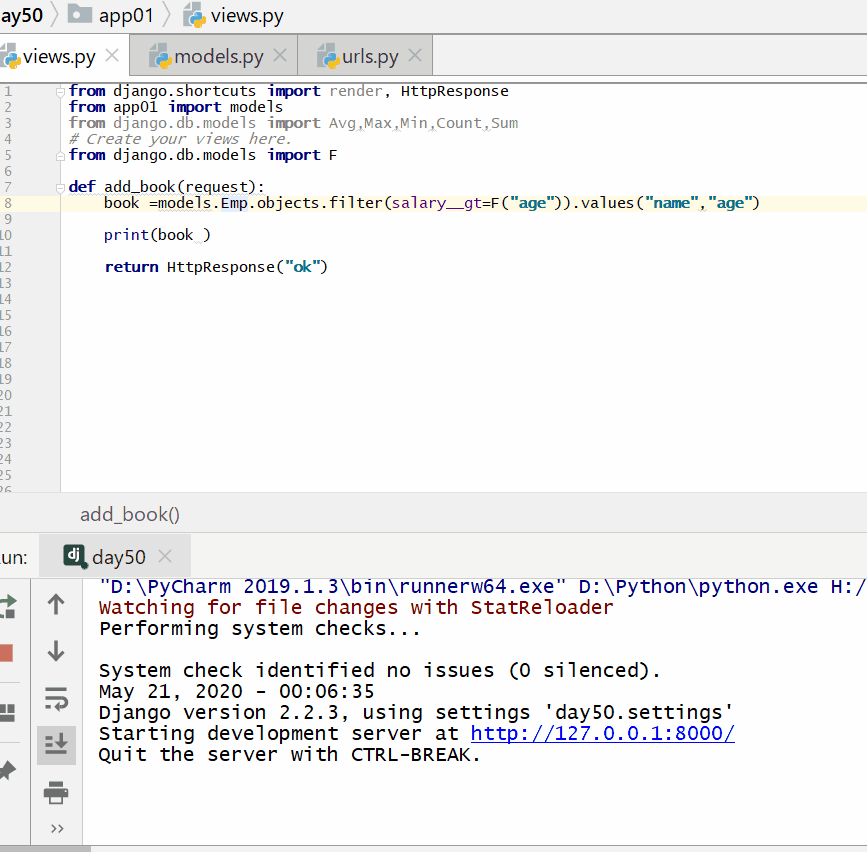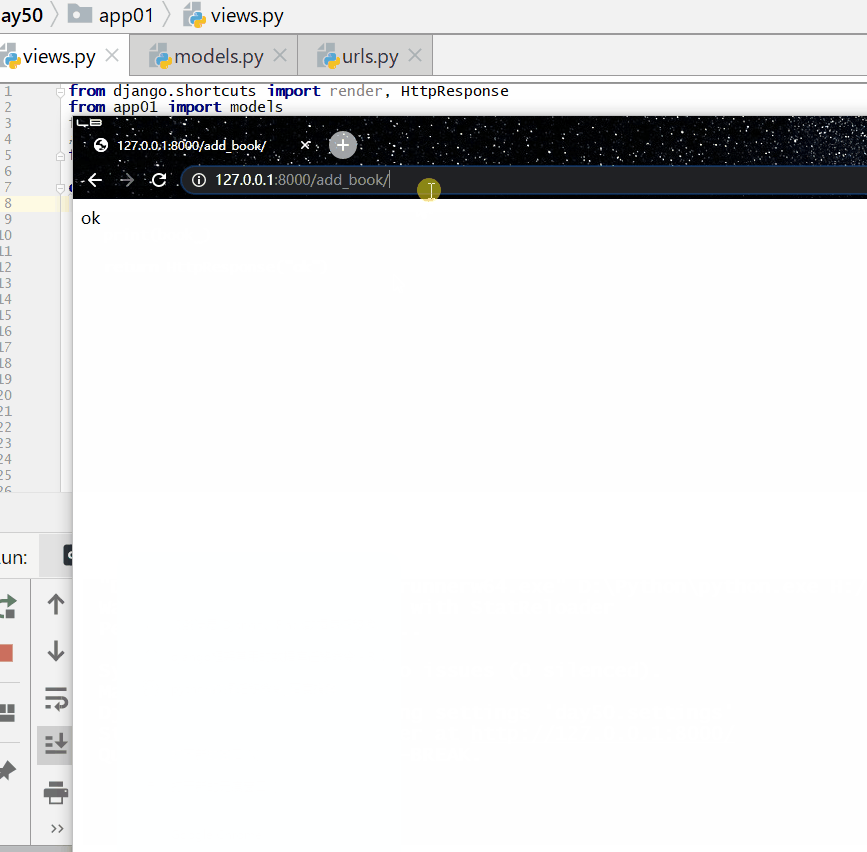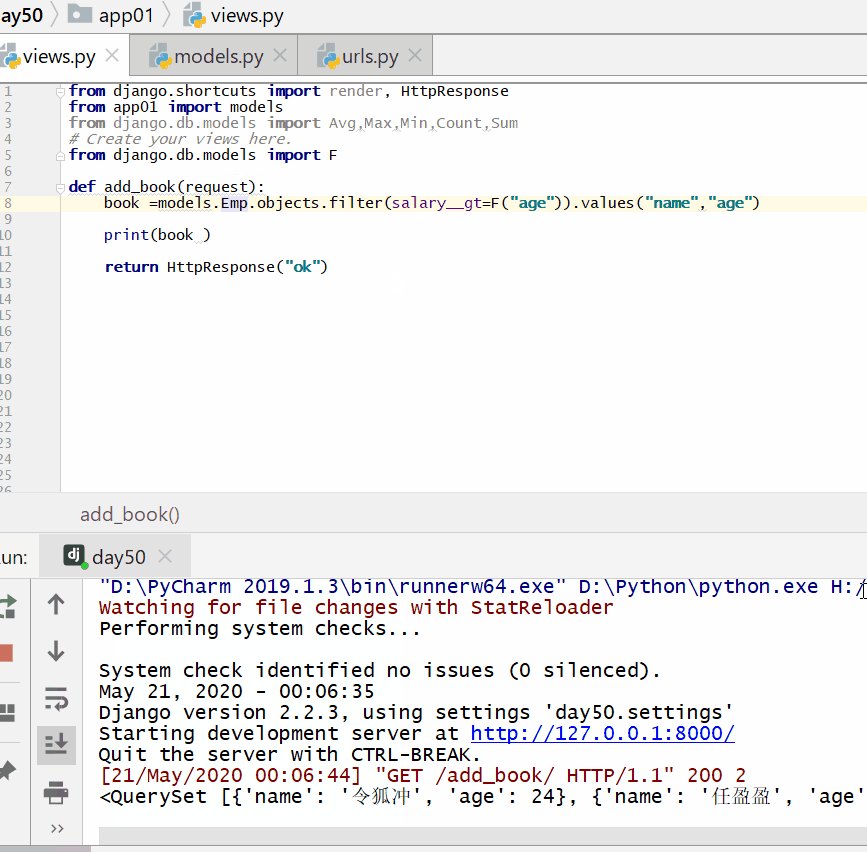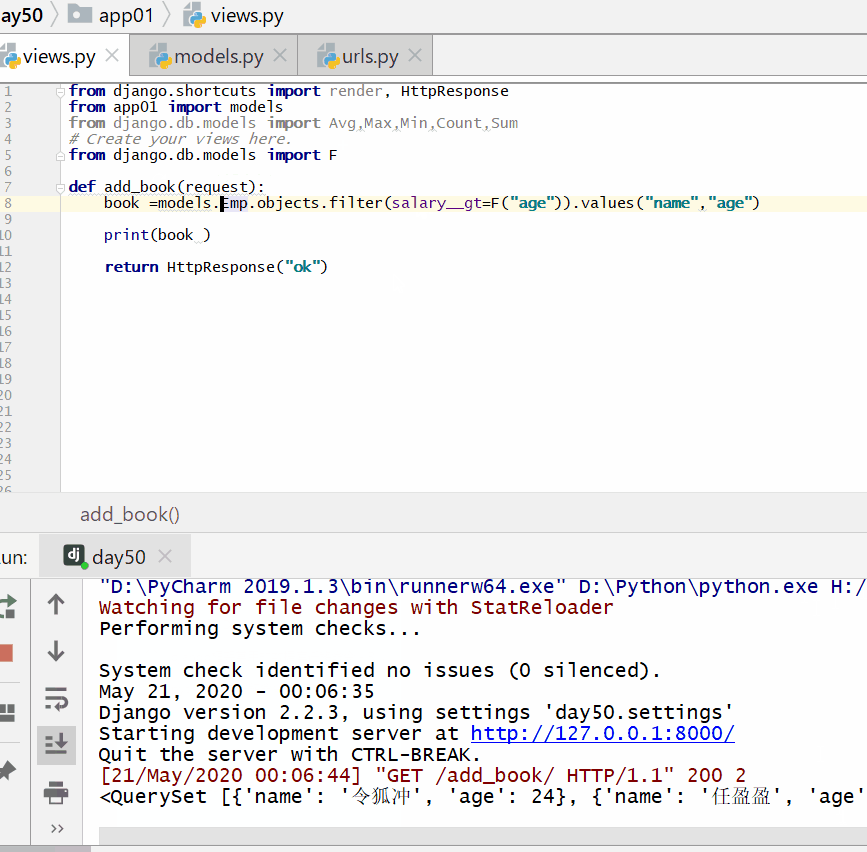
給与が年齢より大きい人をクエリする:
例
...
book=models.Emp.objects.filter(salary__gt=F("age")).values("name","age")
...
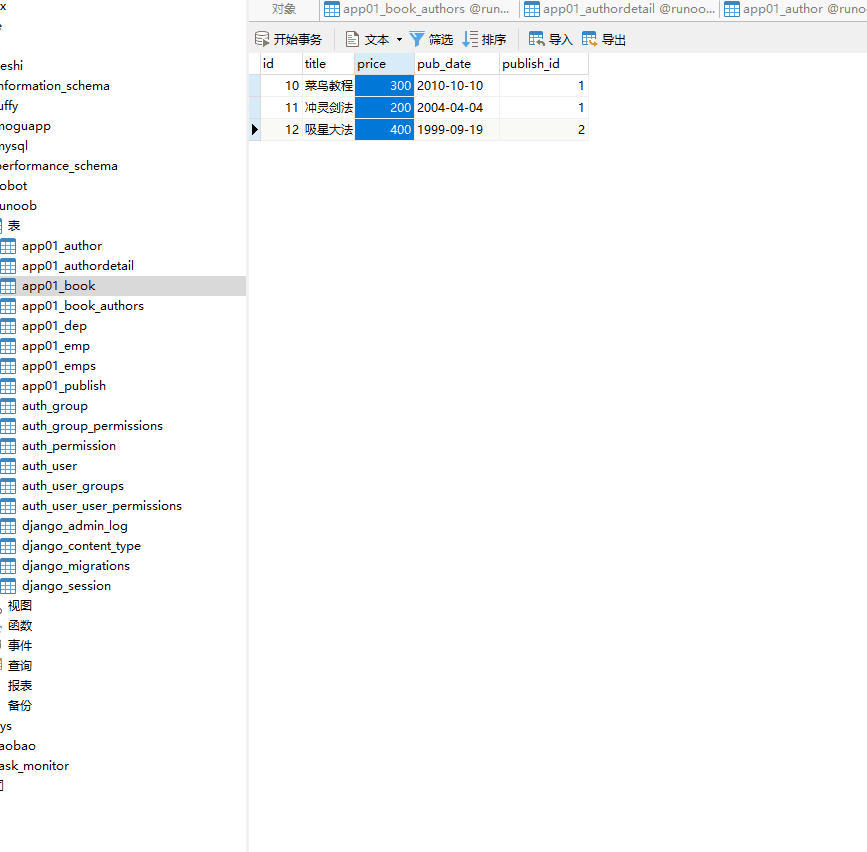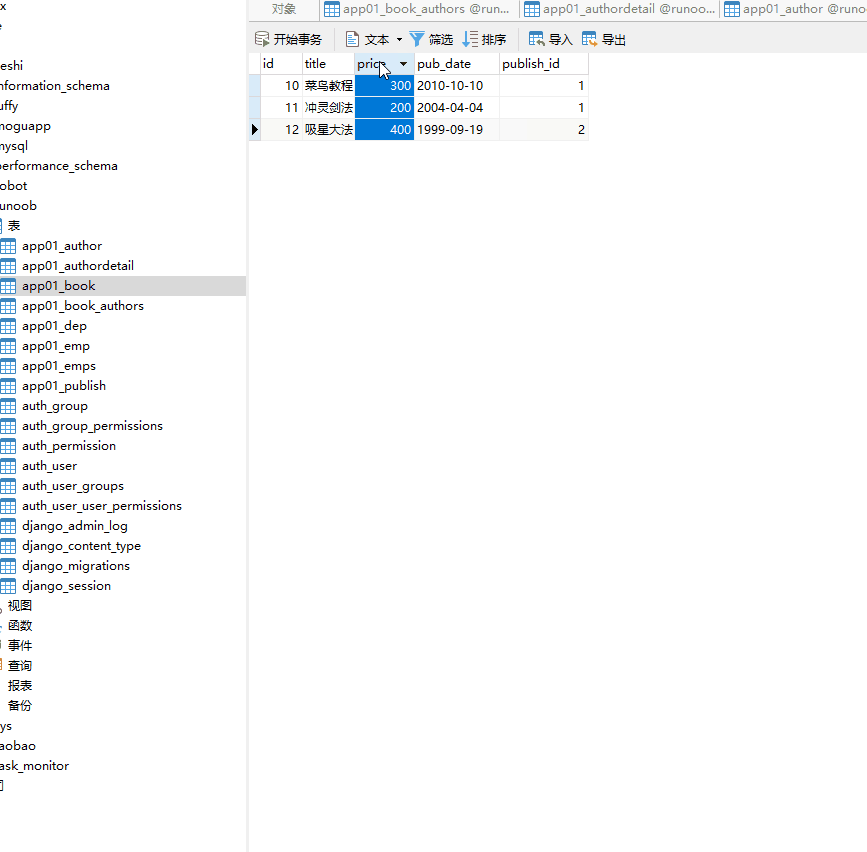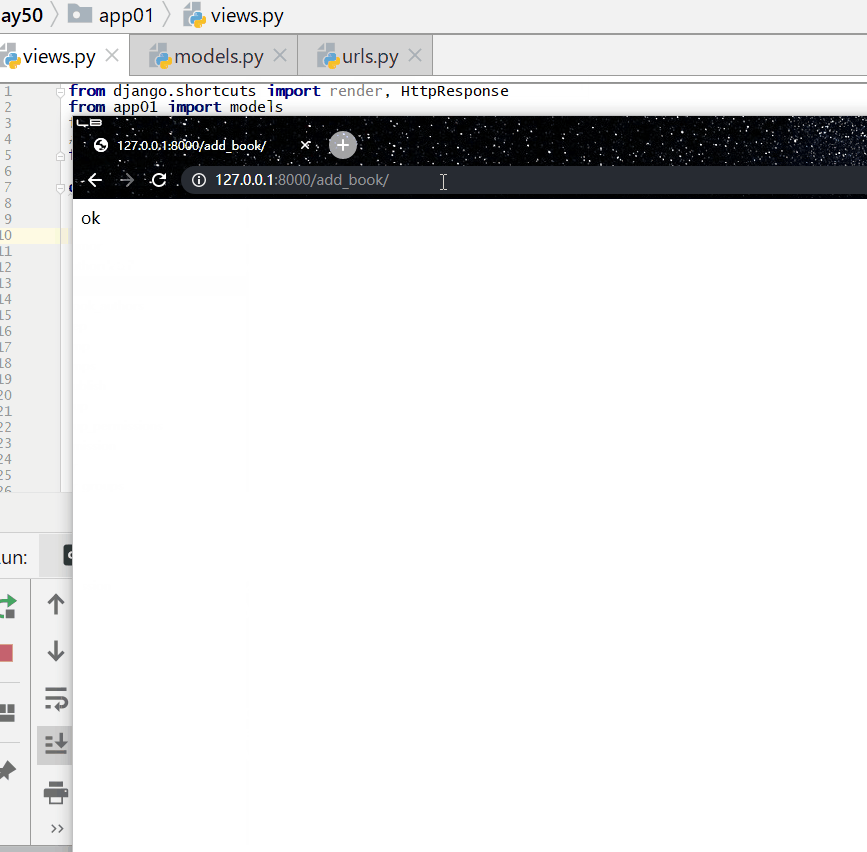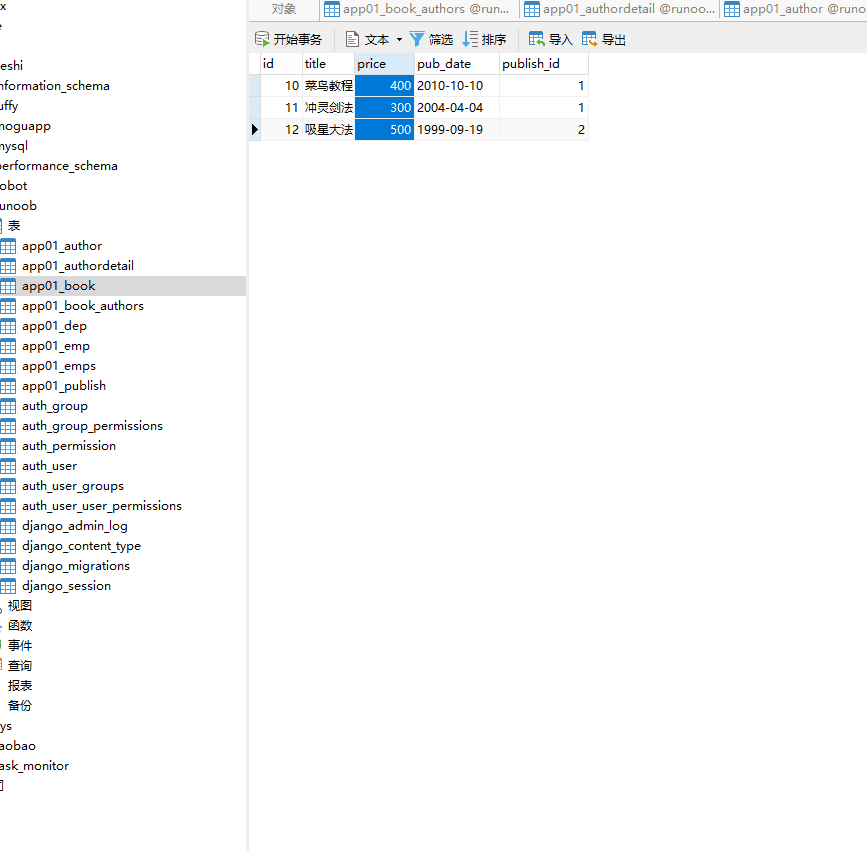
各本の価格を100元引き上げる:
例
print(res)
Q() クエリ
使用前に django.db.models から Q をインポートする必要があります:from django.db.models import Q
用法:
Q(条件判断)
例:
Q(title__startswith="菜")
これまでに構築したフィルタ内の複数の条件の関係はすべて and です。より複雑なクエリ(例:or 文)を実行する必要がある場合は、Q を使用できます。
Q オブジェクトは、& | ~(AND、OR、NOT)演算子を使用して組み合わせることができます。
優先度は高い順に:~ & | です。
Q オブジェクトとキーワード引数を混在させることができます。Q オブジェクトとキーワード引数は "and" で結合されます(つまりカンマを and とみなします)。ただし、Q オブジェクトはすべてのキーワード引数の前に置く必要があります。
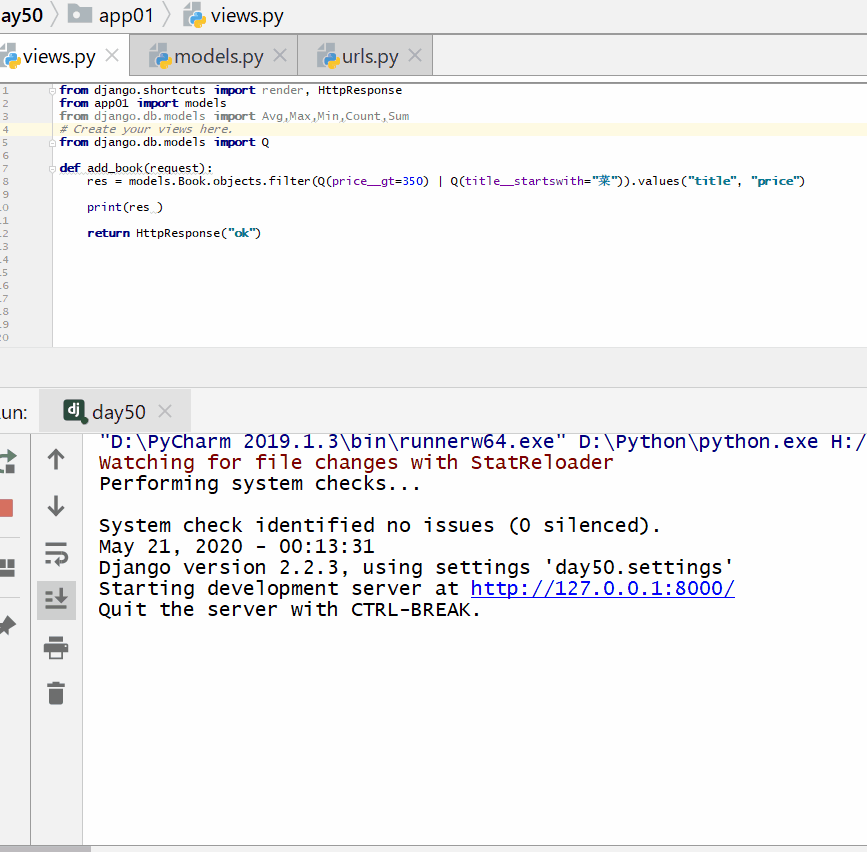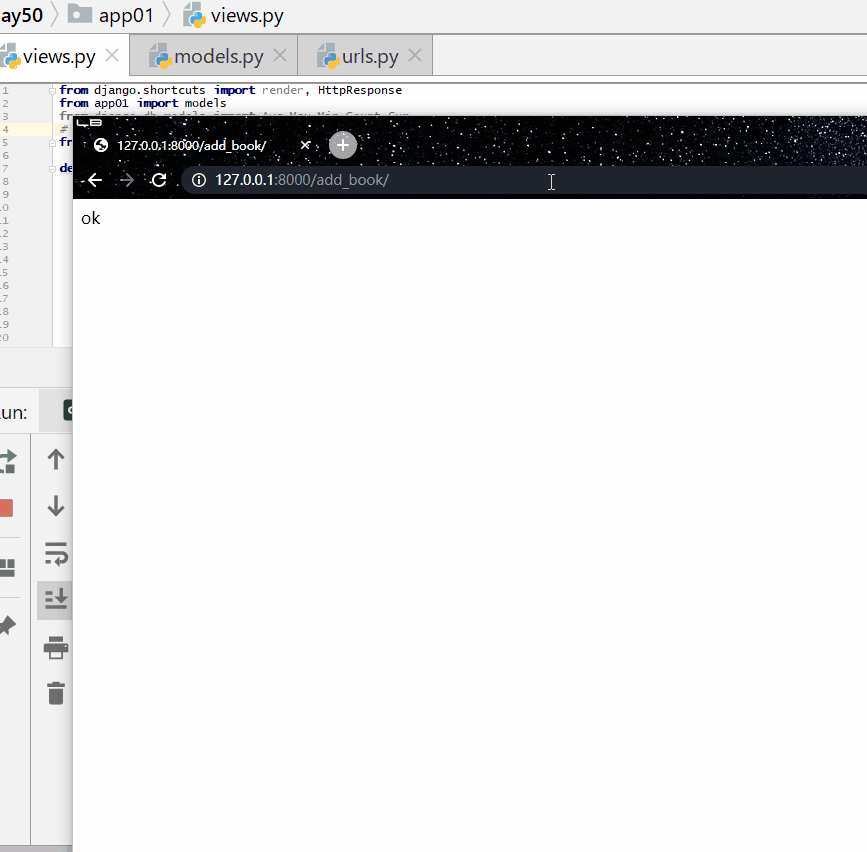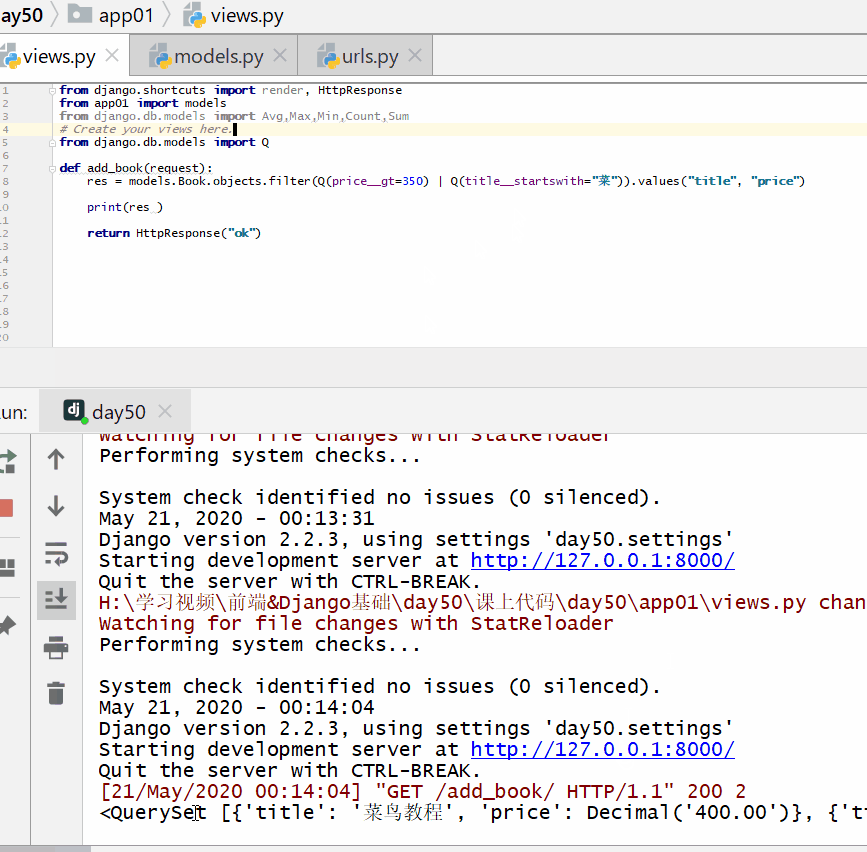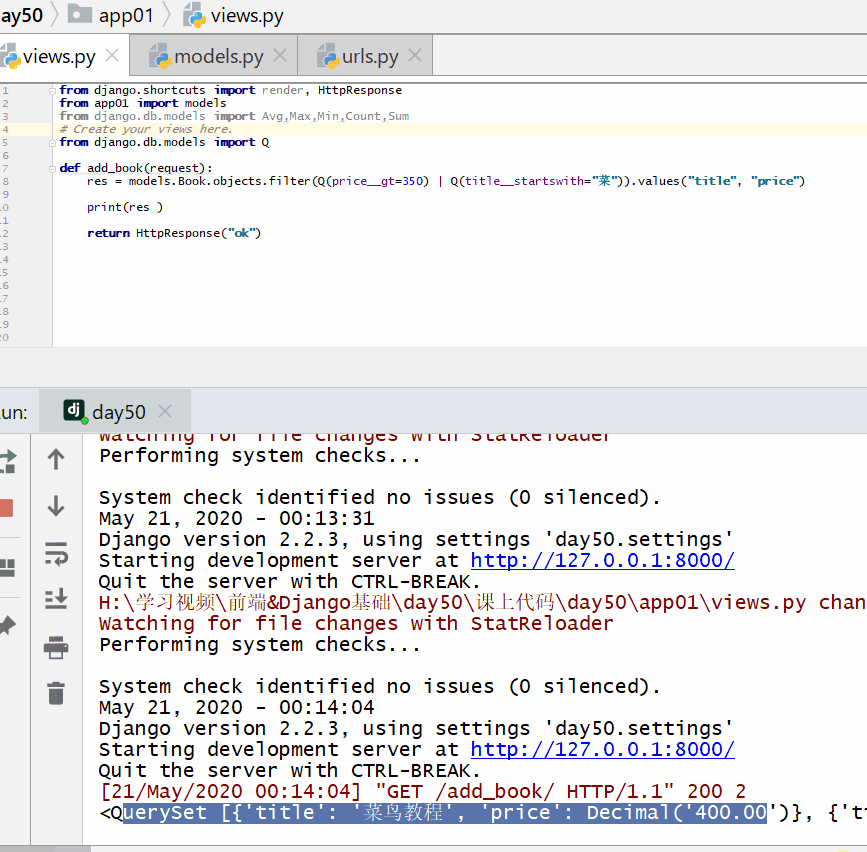
価格が 350 より大きい、または名前が「菜」で始まる書籍の名前と価格をクエリする。
from django.db.models import Q例
res=models.Book.objects.filter(Q(price__gt=350)|Q(title__startswith=菜)).values("title","price")
print(res)
...
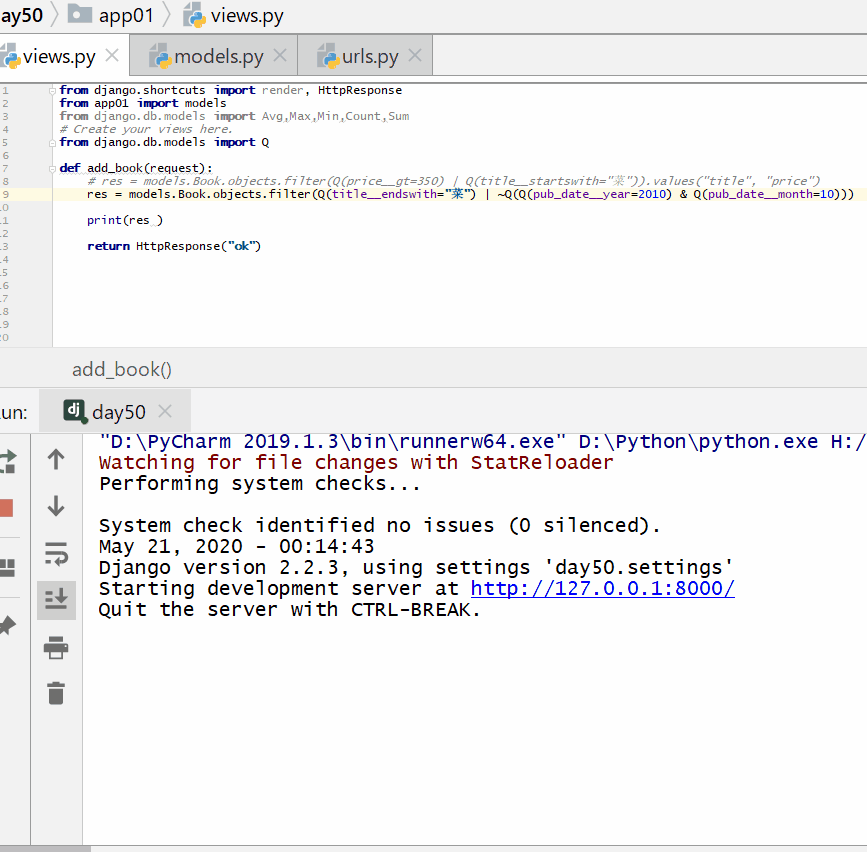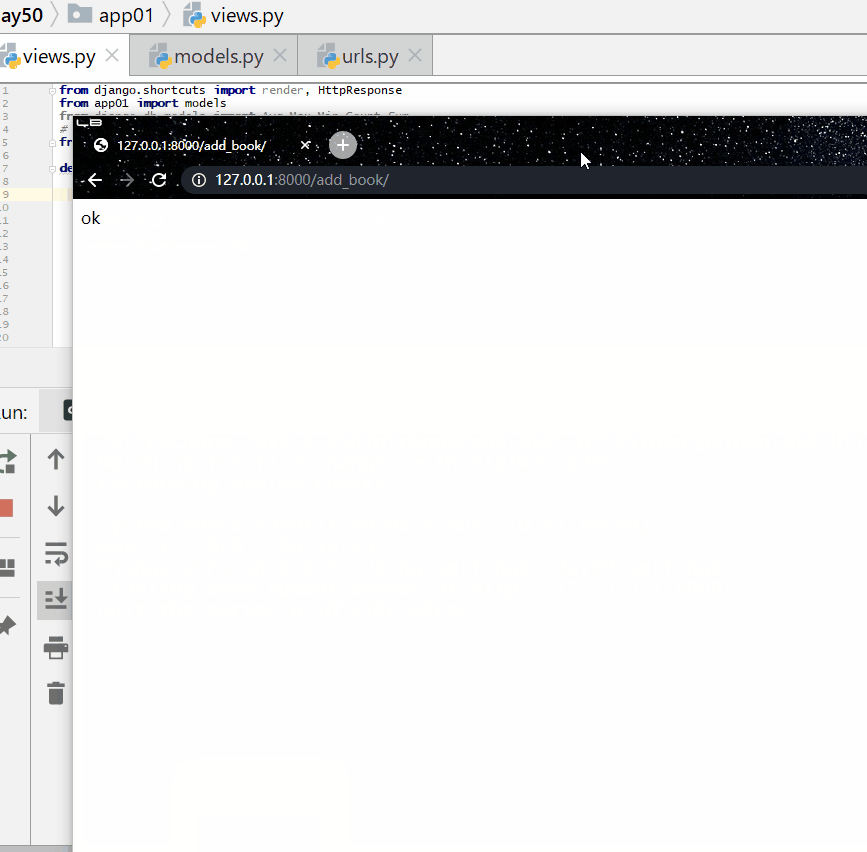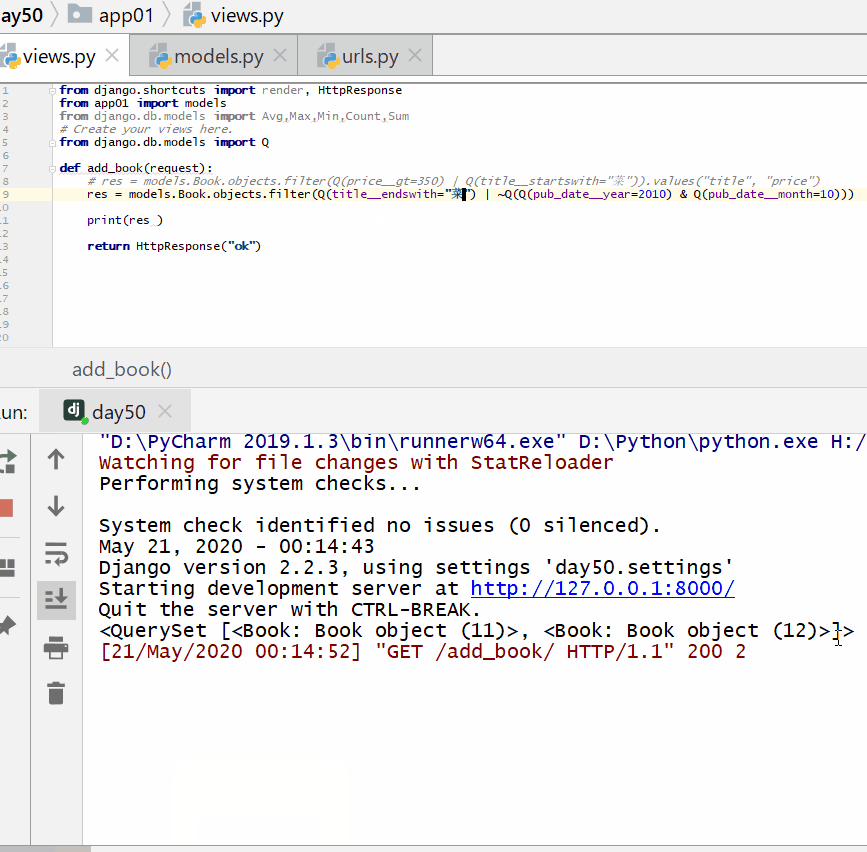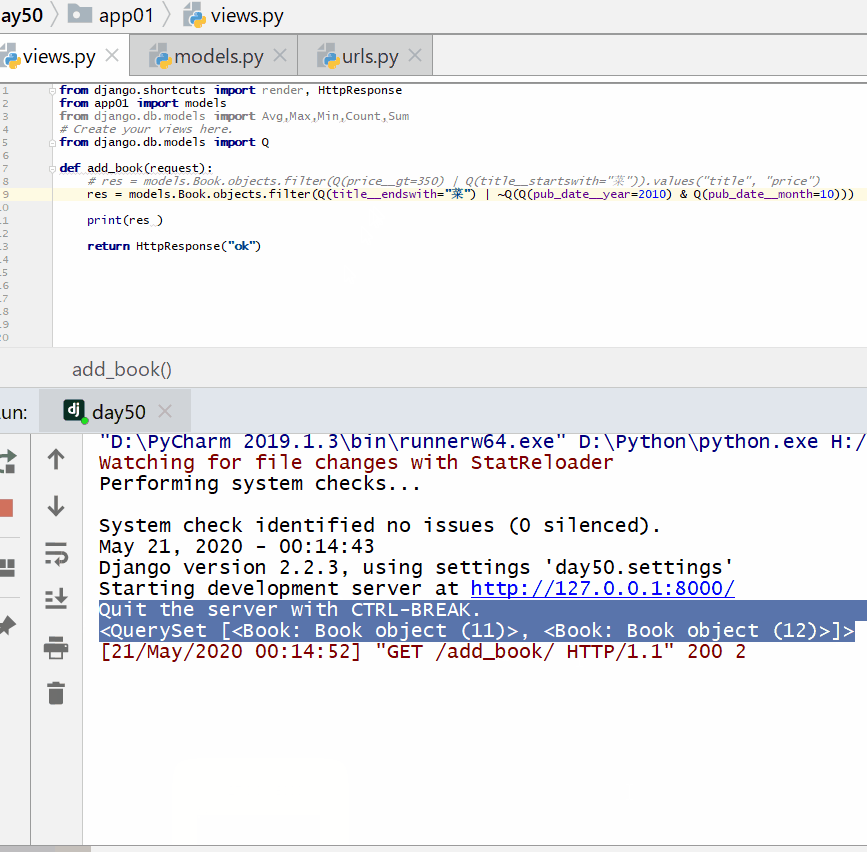
「菜」で終わる、または 2010 年 10 月ではない書籍をクエリする:
例
print(res)
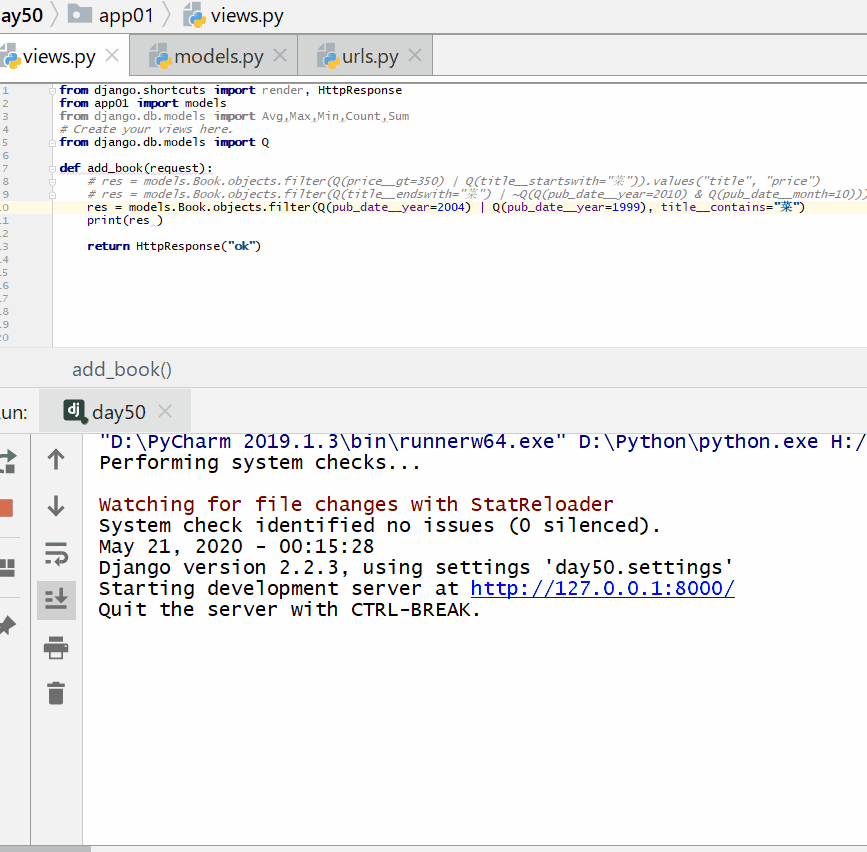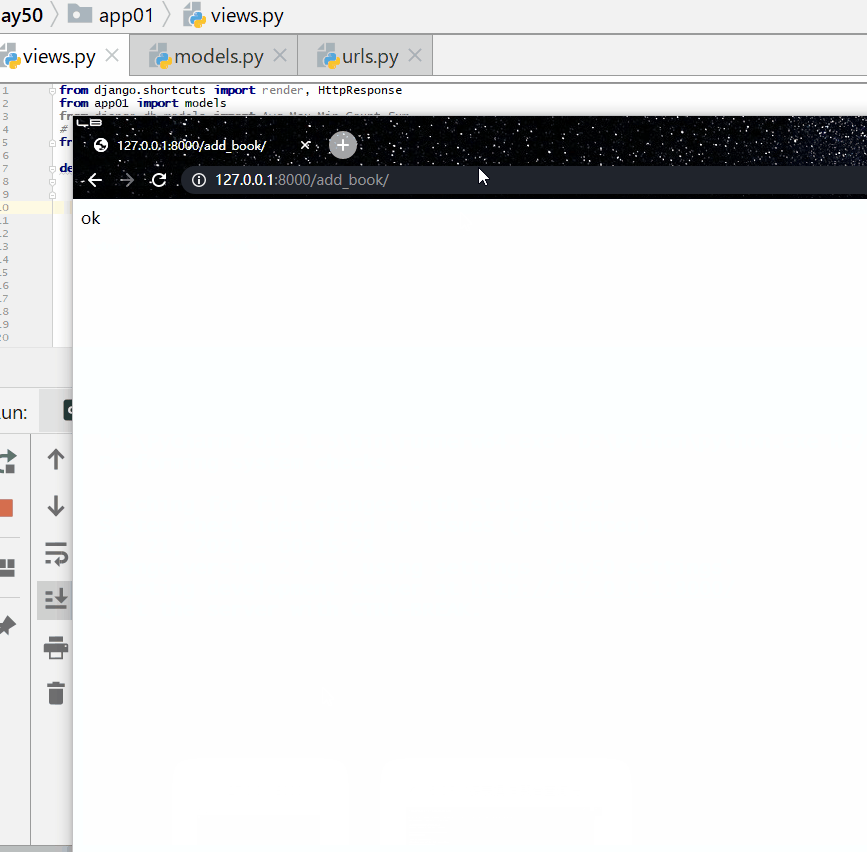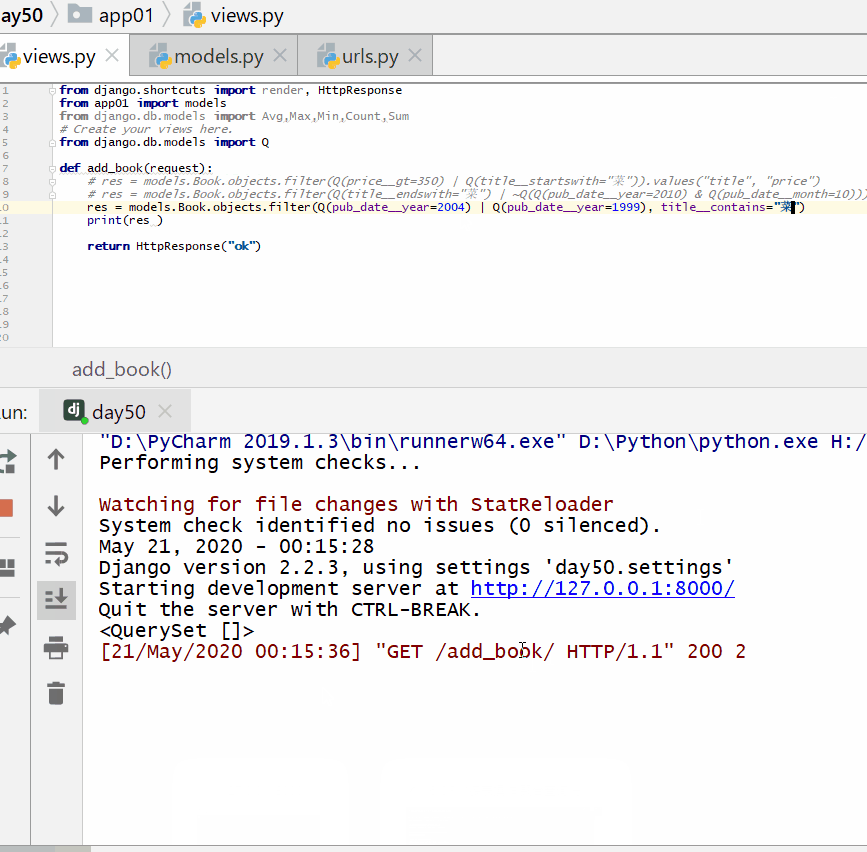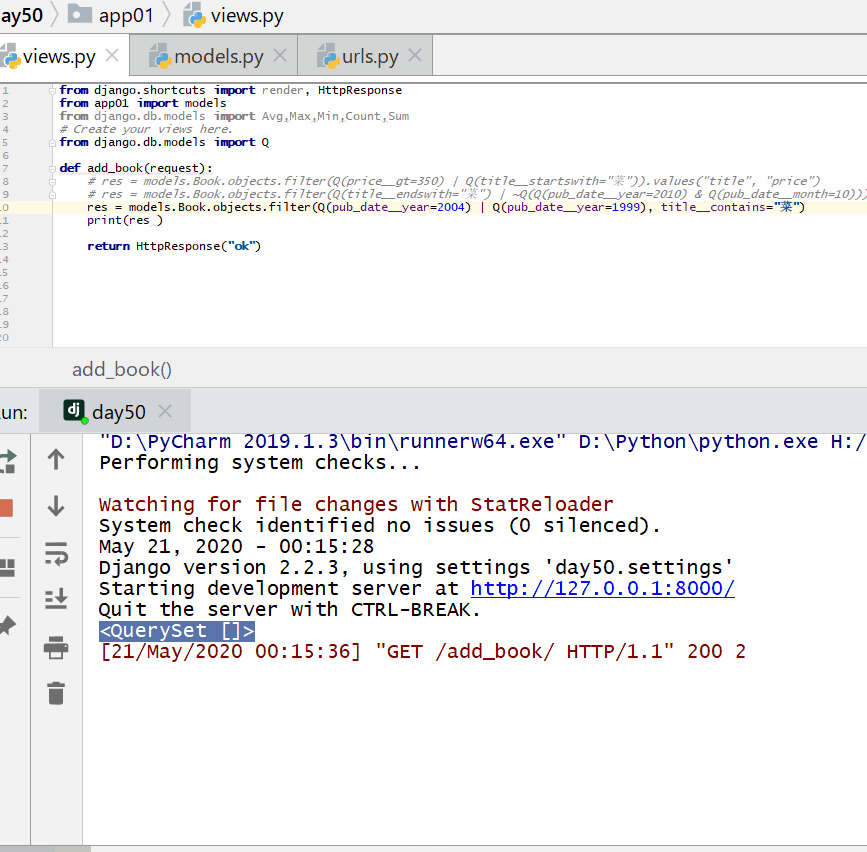
出版日が 2004 年または 1999 年で、かつ書名に「菜」を含む書籍をクエリする。
Q オブジェクトとキーワード引数を混在させて使用する場合、Q オブジェクトはすべてのキーワードの前に置きます:
例
print(res)