Ich wollte schon immer eine relativ vollständige und perfekte Zusammenfassung schreiben. Aber nach reiflicher Überlegung wusste ich nicht, wo ich anfangen sollte. Wie man so sagt, ist aller Anfang schwer. Heute habe ich meine wirren Gedanken sortiert. Nun, ich habe sie immer noch nicht richtig sortiert. Ich rede einfach über das, was mir in den Sinn kommt.
Anfänger verstehen wirklich nicht:
- 1. Was ist Drei-Schichten?
- 2. Warum Drei-Schichten verwenden?
- 3. Was ist der Unterschied zwischen Drei-Schichten und dem zuvor verwendeten Zwei-Schichten? Wo liegen ihre Vorteile?
- 4. Wie lernt man Drei-Schichten gut? Wie wendet man Drei-Schichten an? ……
In diesem Blogbeitrag werde ich sie einzeln erklären. Ich weiß nur ein wenig darüber, also bitte verzeih mir!!!
Lehrer Mi betont immer: Lernen mit dem Leben verbinden, Lernen mit dem Leben verknüpfen. Nur dann kann man das Lernen wirklich Lernen nennen und das Leben wirklich Leben.
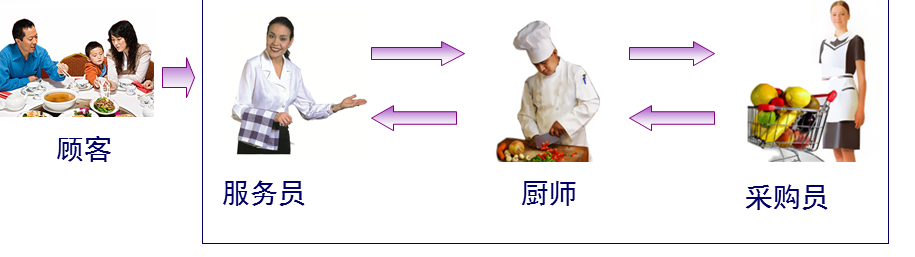
Was Drei-Schichten betrifft, habe ich lange darüber nachgedacht, wie ich sie mit dem echten Leben verbinden kann. Nun, letzte Nacht hatte ich plötzlich eine "Eingebung". Erinnert ihr euch noch an die Geschichte in Big Talk Design Patterns über Big Bird und Xiao Cai, die Lammspieße essen – ein Command Pattern, ausgelöst durch das Essen an einem Straßenstand im Vergleich zum Essen in einem Restaurant (natürlich studieren wir heute nicht das Command Pattern). Der Kellner, der Koch und der Einkäufer.
Ist das nicht eine typische Drei-Schichten-Architektur??? (⊙ o ⊙) Ah! Haha (Ich werde das später erklären)
Zuerst wollen wir verstehen:
1. Was ist Drei-Schichten?
UI (Präsentationsschicht):Bezieht sich hauptsächlich auf die Schnittstelle, die mit dem Benutzer interagiert. Sie wird verwendet, um vom Benutzer eingegebene Daten zu empfangen und die verarbeiteten Daten anzuzeigen, die der Benutzer benötigt.
BLL (Business Logic Layer):Die Brücke zwischen der UI-Schicht und der DAL-Schicht. Sie implementiert Geschäftslogik. Geschäftslogik umfasst insbesondere: Validierung, Berechnung, Geschäftsregeln usw.
DAL (Data Access Layer):Befasst sich mit der Datenbank. Sie implementiert hauptsächlich das Hinzufügen, Löschen, Ändern und Abfragen von Daten. Sie übergibt die in der Datenbank gespeicherten Daten an die Geschäftsschicht und speichert gleichzeitig die von der Geschäftsschicht verarbeiteten Daten in der Datenbank. (Natürlich basieren all diese Operationen auf der UI-Schicht. Die Bedürfnisse des Benutzers werden an die Oberfläche (UI) widergespiegelt, die UI spiegelt sie an BLL wider, BLL spiegelt sie an DAL wider, DAL führt Datenoperationen aus und gibt sie dann nacheinander zurück, bis die vom Benutzer benötigten Daten an den Benutzer zurückgemeldet werden.)

Jede Schicht hat ihre eigenen Verantwortlichkeiten, wie sollten also die drei Schichten verbunden werden?
1. Unidirektionale Referenz (siehe Abbildung unten)
2. An diesem Punkt kommt die Entity-Schicht ins Spiel. (Hinweis: Natürlich ist die Rolle der Entity-Schicht mehr als das.)
Entity:Sie gehört zu keiner der drei Schichten, ist aber eine wesentliche Schicht.
Die Rolle von Entity in der dreischichtigen Architektur:
- 1. „Kapselung“ im objektorientierten Denken realisieren;
- 2. Durchläuft die drei Schichten und übergibt Daten zwischen ihnen; (Hinweis: Genau genommen durchläuft die Entity-Schicht die drei Schichten, um sie zu verbinden.)
- 3. Für Anfänger kann man es so verstehen: Jede Datentabelle entspricht einer Entity, das heißt, die Felder in jeder Datentabelle entsprechen den Eigenschaften in der Entity. (Hinweis: Natürlich ist das nicht wirklich der Fall. Warum? 1> Die benötigte Entity existiert möglicherweise nicht in der Entity, die der Datentabelle entspricht; 2> Wir können alle Felder aus allen Datentabellen vollständig in eine Entity legen.)
- 4. Die Datenübertragung (unidirektional) zwischen den einzelnen Schichten (UI—>BLL—>DAL) erfolgt mithilfe von Variablen oder Entities als Parameter. Dadurch wird die Verbindung zwischen den drei Schichten hergestellt und die Implementierung der Funktionalität abgeschlossen.
Aber bei großen Datenmengen ist die Verwendung von Variablen als Parameter etwas kompliziert, weil zu viele Parameter leicht durcheinandergebracht werden können. Zum Beispiel: Wenn ich Mitarbeiterinformationen an die untere Schicht übergeben möchte und die Informationen Mitarbeiternummer, Name, Alter, Geschlecht, Gehalt ... umfassen, dann gibt es bei Verwendung von Variablen als Parameter viele Parameter in unserer Methode, und es ist sehr wahrscheinlich, dass die Parameterzuordnung bei der Verwendung durcheinandergerät. An diesem Punkt wird es sehr praktisch, wenn eine Entität als Parameter verwendet wird. Man muss sich keine Gedanken über die Parameterzuordnung machen; man nimmt einfach die jeweilige Eigenschaft aus der Entität und verwendet sie direkt. Das ist sehr praktisch. Es verbessert auch die Effizienz.
(Hinweis:Warum wird hier gesagt, dass vorläufig verstanden werden kann, dass jede Datentabelle einer Entität entspricht? Antwort: Wie jeder weiß, besteht der Zweck des Aufbaus eines Systems darin, den Benutzern Dienste bereitzustellen. Benutzer kümmern sich nicht darum, wie das Backend Ihres Systems funktioniert; Benutzer kümmern sich nur darum, ob die Software einfach zu bedienen ist und ob die Oberfläche ihrem Geschmack entspricht. Wenn Benutzer auf der Oberfläche einfach hinzufügen, löschen, ändern und abfragen, muss die Datenbank auch entsprechende Hinzufügen-, Löschen-, Ändern- und Abfrageoperationen haben. Die konkreten Objekte der Hinzufügen-, Löschen-, Ändern- und Abfrageoperationen sind die Daten in der Datenbank, was im Klartext die Felder in den Tabellen sind. Daher kann jede Datentabelle als Entitätsklasse behandelt werden, wobei die von der Entitätsklasse gekapselten Eigenschaften den Feldern in der Tabelle entsprechen; wenn die Entität dann durch die drei Schichten läuft, kann sie das Hinzufügen, Löschen, Ändern und Abfragen von Daten implementieren.)
Zusammenfassung: die Abhängigkeitsbeziehungen zwischen den drei Schichten und der Entity-Schicht:

Die Idee stammt aus dem Leben:
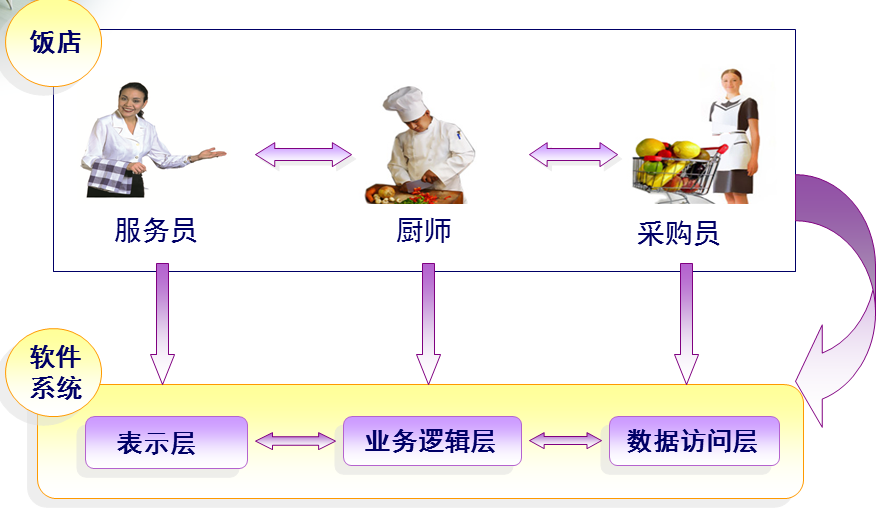
Kellner:Nur dafür verantwortlich, Gäste zu empfangen;
Koch:Nur dafür verantwortlich, die von den Gästen bestellten Gerichte zu kochen;
Einkäufer:Nur dafür verantwortlich, Zutaten gemäß den Bestellanforderungen der Gäste einzukaufen;
Sie erfüllen jeweils ihre eigenen Aufgaben. Die Kellnerin muss nicht wissen, wie der Koch kocht, noch wie der Einkäufer Zutaten einkauft; der Koch muss nicht wissen, welche Gäste die Kellnerin empfangen hat, noch wie der Einkäufer Zutaten einkauft; ebenso muss der Einkäufer nicht wissen, welche Gäste die Kellnerin empfangen hat, noch wie der Koch kocht.
Wie sind die drei miteinander verbunden?
Zum Beispiel: Der Koch kann zubereiten: gebratene Auberginen, Rührei, Chow Mein – an diesem Punkt werden drei Methoden erstellt (cookEggplant(), cookEgg(), cookNoodle())
Der Kunde hat direkt mit der Kellnerin zu tun. Der Kunde sagt zur Kellnerin (UI-Schicht): "Ich möchte eine gebratene Aubergine." Die Kellnerin ist nicht für das Kochen der Aubergine verantwortlich, also reicht sie die Anfrage an den Koch (BLL-Schicht) weiter. Der Koch benötigt eine Aubergine, also reicht er die Anfrage an den Einkäufer (DAL-Schicht) weiter. Der Einkäufer nimmt die Aubergine aus dem Lager und reicht sie an den Koch zurück. Der Koch ruft die Methode cookEggplant() auf und reicht sie nach der Zubereitung der gebratenen Aubergine an die Kellnerin zurück, die die Aubergine dem Kunden präsentiert.
Damit ist ein vollständiger Vorgang abgeschlossen.
In diesem Prozess wird die Aubergine als Parameter zwischen den drei Schichten übergeben. Wenn der Kunde Rührei bestellt, wird das Ei als Parameter verwendet (hierbei werden Variablen als Parameter verwendet). Wenn der Benutzer Anforderungen hinzufügt, müssen wir trotzdem Parameter zu den Methoden hinzufügen – eine Methode fügt einen Parameter hinzu, und eine Methode betrifft die drei Schichten; außerdem wird in der Realität nicht nur eine Methode geändert. Um dieses Problem zu lösen, können wir daher die Aubergine, das Ei und die Nudeln als Eigenschaften in der Kundenentität definieren. Sobald der Kunde die Rührei-Anforderung hinzufügt, können wir die Eigenschaft Ei direkt herausnehmen und verwenden. Es ist nicht nötig, das Hinzufügen von Parametern zu den Methoden jeder Schicht zu berücksichtigen, und noch weniger muss man sich um die Parameterübereinstimmung sorgen.
Ich frage mich, ob jeder diese Erklärung verstehen kann. (Ich werde es später an einem Beispiel erklären.)
2. Warum Drei-Schichten verwenden?
Der Zweck der Verwendung einer Drei-Schichten-Architektur: Entkopplung!!!
Ähnlich wie im obigen Restaurant-Beispiel:
(1) Der Kellner (UI-Schicht) nimmt Urlaub—suchen Sie einen anderen Kellner; der Koch (BLL-Schicht) kündigt—stellen Sie einen anderen Koch ein; der Einkäufer (DAL) kündigt—stellen Sie einen anderen Einkäufer ein; (2) Kundenfeedback:
- 1. "Ihr Restaurant hat eine schlechte Servicehaltung"—das ist das Problem des Kellners. Entlassen Sie den Kellner;
- 2. "In Ihrem Gericht steckt ein Fehler"—das ist das Problem des Kochs. Ersetzen Sie den Koch;
Jede Änderung in einer Schicht wirkt sich nicht auf die anderen Schichten aus!!!
3. Was ist der Unterschied zum Zwei-Schichten-Modell?
Zwei-Schichten:
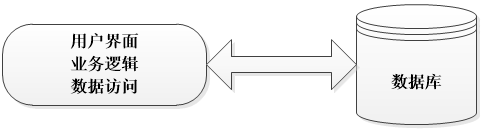
(Wenn sich irgendein Teil ändert, muss das gesamte System neu entwickelt werden. "Mehrere Schichten" werden in einer Schicht untergebracht, mit unklarer Arbeitsteilung und hoher Kopplung—was die Anpassung an Anforderungsänderungen erschwert, mit geringer Wartbarkeit und geringer Skalierbarkeit.)
Drei-Schichten:

(Eine Änderung in welcher Schicht auch immer erfordert nur, diese Schicht zu ändern, nicht das gesamte System. Die Hierarchie ist klar, die Arbeitsteilung ist klar, und die Kopplung zwischen den Schichten ist gering—was die Effizienz verbessert, sich an Anforderungsänderungen anpasst, mit hoher Wartbarkeit und hoher Skalierbarkeit.)
Zusammenfassung der Vorteile der Drei-Schichten-Architektur:
- 1. Klare Struktur und lose Kopplung
- 2. Hohe Wartbarkeit, hohe Skalierbarkeit
- 3. Erleichtert die synchrone Entwicklung von Aufgaben, passt sich leicht an Anforderungsänderungen an
Die Vor- und Nachteile der Drei-Schichten-Architektur:
- 1. Es verringert die Systemleistung. Das ist selbstverständlich. Wenn keine geschichtete Struktur verwendet wird, können viele Operationen direkt auf die Datenbank zugreifen, um die entsprechenden Daten zu erhalten, aber jetzt müssen sie über die Zwischenschicht erfolgen.
- 2. Manchmal führt es zu kaskadierenden Änderungen. Diese Art von Änderung zeigt sich besonders in der Top-down-Richtung. Wenn in der Präsentationsschicht eine Funktion hinzugefügt werden muss, um sicherzustellen, dass ihr Design der geschichteten Struktur entspricht, müssen möglicherweise sowohl in der Geschäftslogikschicht als auch in der Datenzugriffsschicht entsprechende Codezeilen hinzugefügt werden.
- 3. Es erhöht die Codemenge und erhöht den Arbeitsaufwand.
4. Was sind die konkreten Formen der drei Schichten?
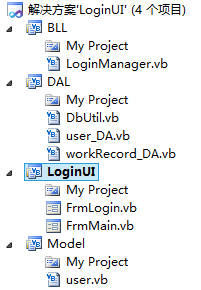
UI:

(Nicht falsch verstehen – die UI-Schicht ist nicht nur eine Ansammlung von Benutzeroberflächen; sie muss auch Code enthalten.)
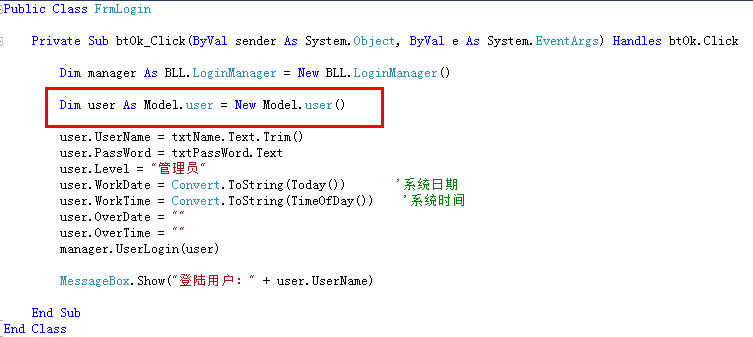
(1. Funktion: Benutzer gibt Daten ein, Rückmeldung von Daten an den Benutzer; 2. Alle betrachten den Code: keine Geschäftslogik beteiligt, nur direkte Parameterübergabe, Funktions-/Methodenaufrufe und keine SQL-Anweisungen oder ADO.NET, die mit der Datenbank umgehen.)
BLL:
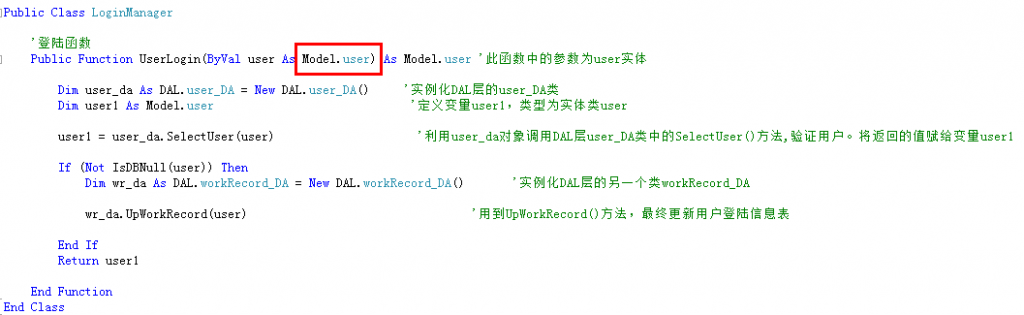
(1. BLL ist die Brücke zwischen der Präsentationsschicht und der Datenzugriffsschicht, verantwortlich für Datenverarbeitung und -transfer; 2. Betrachtet den Code: Es sind keine Steuerelemente auf der Oberfläche beteiligt, es sind keine SQL-Anweisungen oder ADO.NET beteiligt.)
DAL:


(1. Das Obige ist der Code in der DbUtil-Klasse, der user_DA-Klasse und der workRecord_DA-Klasse in der DAL-Schicht; 2. Betrachtet den Code: Es sind keine Oberflächen-Steuerelemente beteiligt, es ist keine Geschäftslogik beteiligt; nur SQL-Anweisungen und ADO.NET, die mit der Datenbank arbeiten.)
Entity (Model)-Schicht:

(Definiert die Entitätsklasse user)
Betrachtet die obigen drei Schichten:
- 1. Die Entitätsklasse user läuft als Parameter durch die drei Schichten;
- 2. Funktionalität durch Parameterübergabe und Methodenaufrufe implementieren;
- 3. Jede Schicht ist für ihre eigenen Aufgaben verantwortlich und sie beeinflussen sich nicht gegenseitig;
Vergleicht die Zwei-Schichten-Struktur, um allen ein tiefes Verständnis für die großen Vorteile der Drei-Schichten-Struktur zu vermitteln:
Nehmen wir weiterhin die Anmeldung des Computerraum-Abrechnungssystems als Beispiel:

(Betrachten Sie den oben stehenden zweischichtigen Code: Sowohl Geschäftslogik als auch Datenzugriff werden in der Benutzerpräsentationsschicht dargestellt. Wenn Anforderungen geändert werden müssen, muss das gesamte System geändert werden. Wenn ich beispielsweise den Namen des Textfelds txtPassWord in txtPwd ändere, können Sie sehen, wie viele Stellen geändert werden müssen. Eine solche Änderung gilt als klein. Wenn es eine echte Änderung der Geschäftsanforderungen gibt, wäre das wirklich mühsam und kompliziert. Es wäre ein Wunder, wenn Programmierer nicht von einem Gebäude springen würden. Hehe ... nur ein Scherz)
Originaladresse: https://blog.csdn.net/hanxuemin12345/article/details/8544957/