SQL 構文
SQL(Structured Query Language)は、リレーショナルデータベースを管理・操作するための標準言語であり、データの照会、データの挿入、データの更新、データの削除、データベース構造の作成や変更などの機能を含みます。
データベーステーブル
データベースには通常1つ以上のテーブルが含まれ、各テーブルには名前の識別子があります(例:"Websites")。テーブルにはデータを含むレコード(行)が含まれます。
このチュートリアルでは、MySQL の サンプル データベースに Websites テーブルを作成し、ウェブサイトのレコードを保存します。
以下のコマンドで「Websites」テーブルのデータを表示できます:
mysql> use サンプル;
Database changed

mysql> set names utf8;
Query OK, 0 rows affected (0.00 sec)

mysql> SELECT * FROM Websites;
+----+--------------+---------------------------+-------+---------+
| id | name         | url                       | alexa | country |
+----+--------------+---------------------------+-------+---------+
| 1  | Google       | https://www.google.cm/    | 1     | USA     |
| 2  | 淘宝          | https://www.taobao.com/   | 13    | CN      |
| 3  | サンプル      | http://www.example.com/    | 4689  | CN      |
| 4  | 微博          | http://weibo.com/         | 20    | CN      |
| 5  | Facebook     | https://www.facebook.com/ | 3     | USA     |
+----+--------------+---------------------------+-------+---------+
5 rows in set (0.01 sec)
解説
- use サンプル;コマンドはデータベースを選択するために使用されます。
- set names utf8;コマンドは使用する文字セットを設定するために使用されます。
- SELECT * FROM Websites;データテーブルの情報を読み取ります。
- 上記のテーブルには5つのレコード(各レコードは1つのウェブサイト情報に対応)と5つの列(id、name、url、alexa、country)が含まれます。
SQL ステートメント
データベースに対して実行する必要がある作業のほとんどは、SQL ステートメントで行われます。
次の SQL ステートメントは「Websites」テーブルからすべてのレコードを選択します:
例
このチュートリアルでは、さまざまな SQL ステートメントについて説明します。
覚えておいてください...
- SQL は大文字と小文字を区別しません:SELECT と select は同じです。
SQL ステートメントの後ろのセミコロン?
一部のデータベースシステムでは、各 SQL ステートメントの末尾にセミコロンを使用する必要があります。
セミコロンは、データベースシステムで各 SQL ステートメントを区切る標準的な方法であり、これによりサーバーへの同じリクエスト内で複数の SQL ステートメントを実行できます。
このチュートリアルでは、各 SQL ステートメントの末尾にセミコロンを使用します。
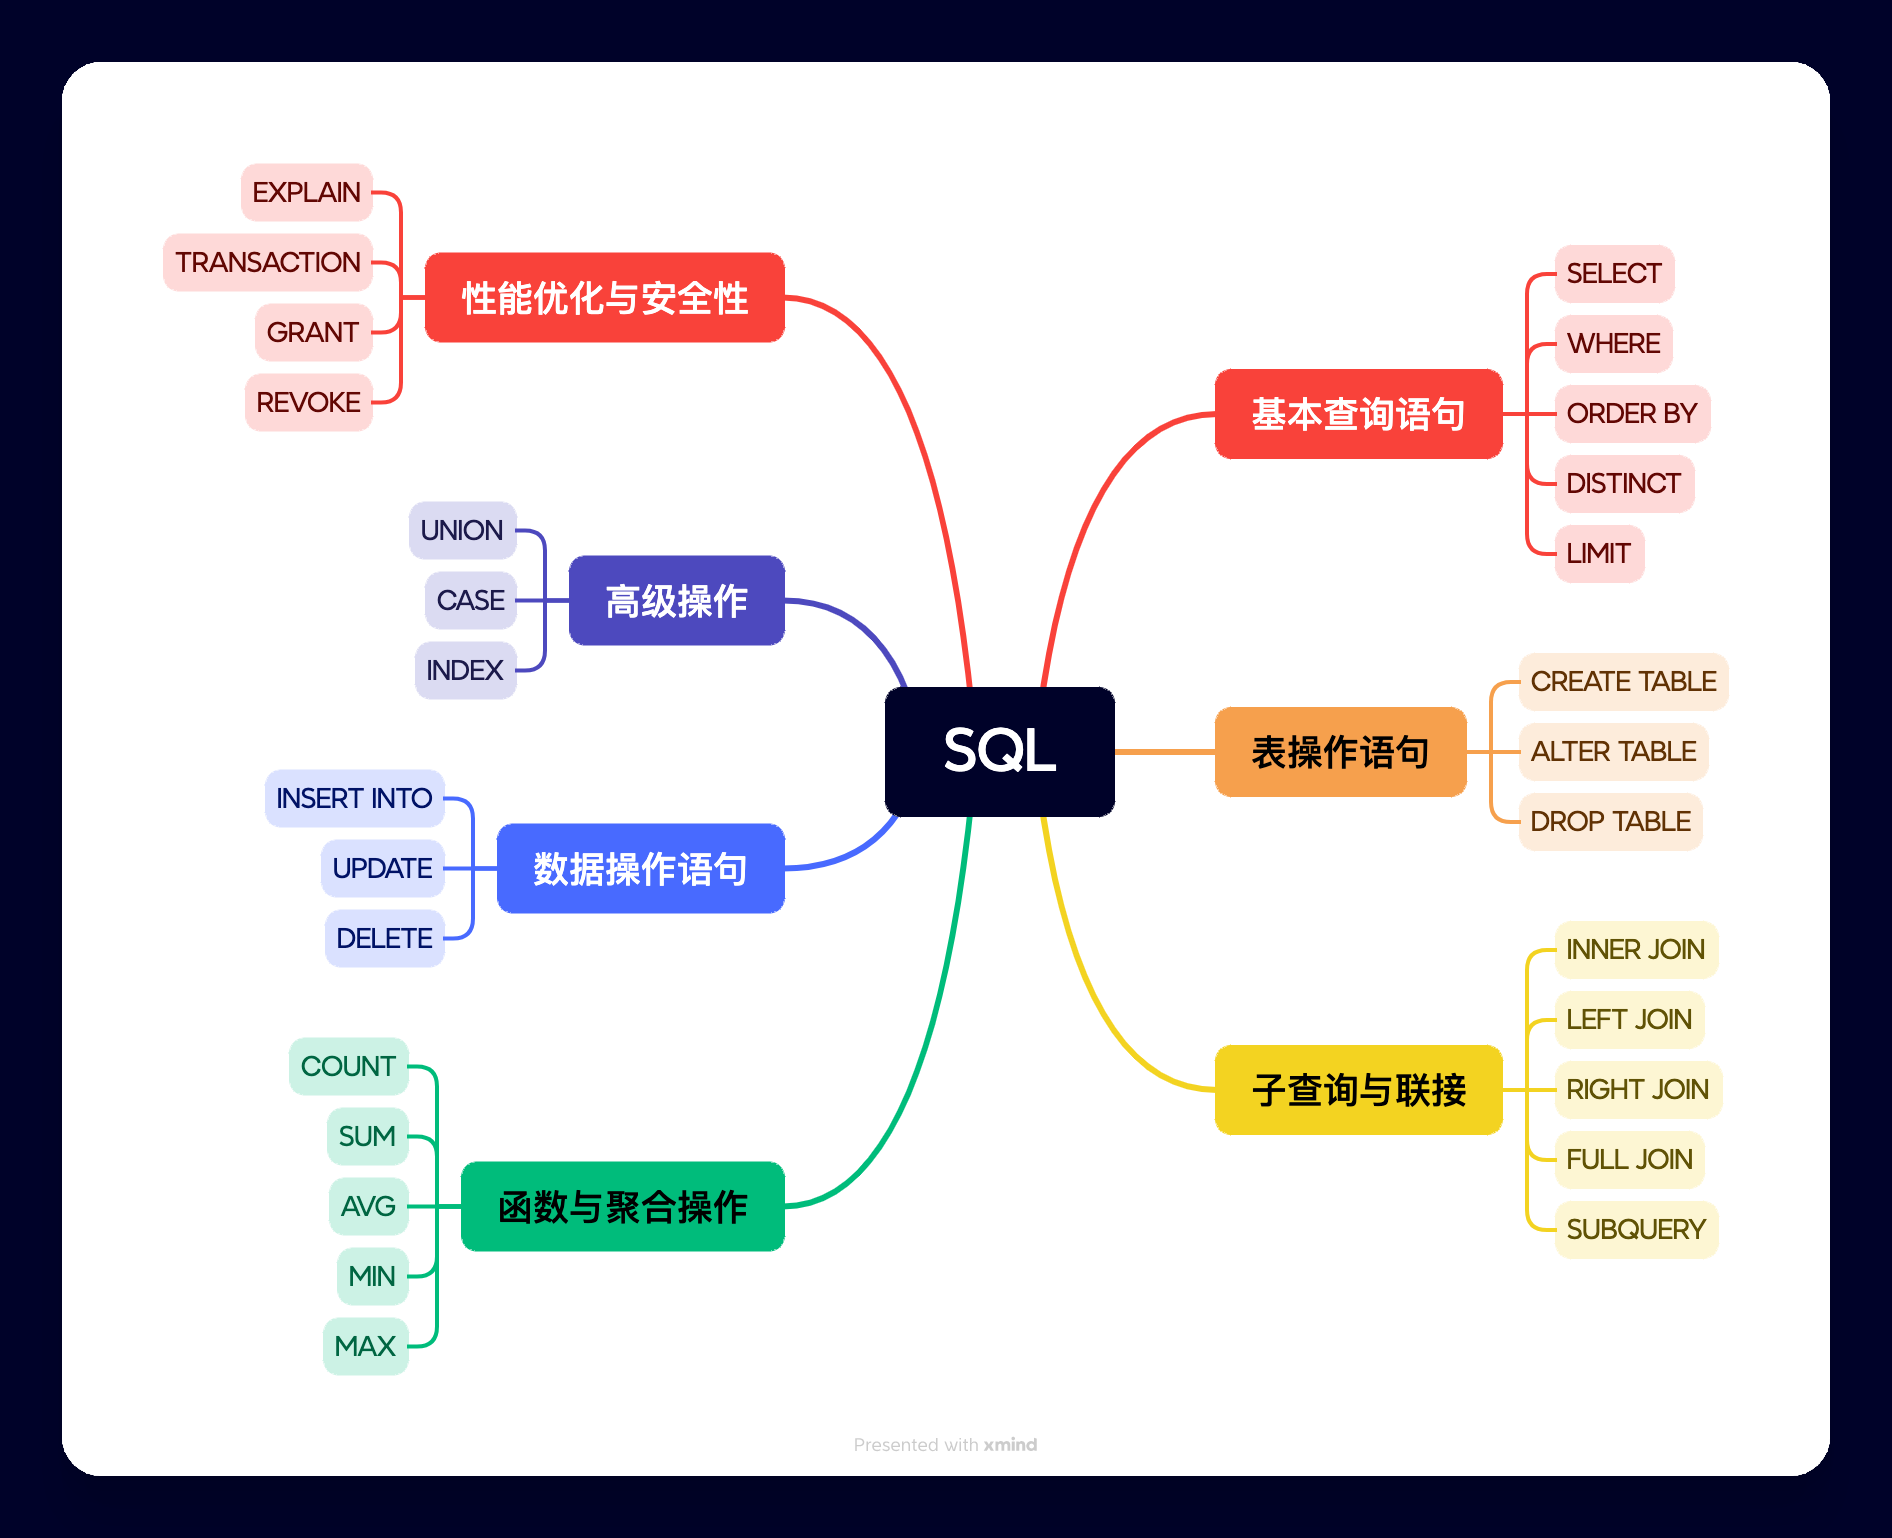
最も重要な SQL コマンドの一部
- SELECT- データベースからデータを抽出します
- UPDATE- データベースのデータを更新します
- DELETE- データベースからデータを削除します
- INSERT INTO- データベースに新しいデータを挿入します
- CREATE DATABASE- 新しいデータベースを作成します
- ALTER DATABASE- データベースを変更します
- CREATE TABLE- 新しいテーブルを作成します
- ALTER TABLE- データベーステーブルを変更します
- DROP TABLE- テーブルを削除します
- CREATE INDEX- インデックス(検索キー)を作成します
- DROP INDEX- インデックスを削除します
以下は、よく使われる SQL ステートメントと構文です:
SELECT:データベースからデータを照会するために使用されます。
SELECT column_name(s)
FROM table_name
WHERE condition
ORDER BY column_name [ASC|DESC]
column_name(s): 照会する列。table_name: 照会するテーブル。condition: 照会条件(オプション)。ORDER BY: 並べ替え方法、ASC昇順を示し、DESC降順を示します(オプション)。
INSERT INTO:データベーステーブルに新しいデータを挿入するために使用されます。
INSERT INTO table_name (column1, column2, ...)
VALUES (value1, value2, ...)
table_name: データを挿入するテーブル。column1, column2, ...: データを挿入する列。value1, value2, ...: 対応する列の値。
UPDATE:データベーステーブル内の既存のデータを更新するために使用されます。
UPDATE table_name
SET column1 = value1, column2 = value2, ...
WHERE condition
table_name: データを更新するテーブル。column1 = value1, column2 = value2, ...: 更新する列とその新しい値。condition更新条件。
DELETE:データベーステーブルからデータを削除するために使用されます。
DELETE FROM table_name
WHERE condition
table_name: データを削除するテーブル。condition削除条件。
CREATE TABLE:新しいデータベーステーブルを作成するために使用されます。
CREATE TABLE table_name (
    column1 data_type constraint,
    column2 data_type constraint,
    ...
)
table_name: 作成するテーブル名。column1, column2, ...: テーブルの列。data_type: 列のデータ型(例:INT、VARCHARなど)。constraint: 列の制約(例:PRIMARY KEY、NOT NULLなど)。
ALTER TABLE:既存のデータベーステーブルの構造を変更するために使用されます。
ALTER TABLE table_name
ADD column_name data_type
table_name: 変更するテーブル。column_name: 追加する列。data_type: 列のデータ型。
または:
ALTER TABLE table_name
DROP COLUMN column_name
column_name: 削除する列。
DROP TABLE:データベーステーブルを削除するために使用されます。
DROP TABLE table_name
table_name: 削除するテーブル。
CREATE INDEX:クエリ速度を向上させるためにインデックスを作成するために使用されます。
CREATE INDEX index_name
ON table_name (column_name)
index_name: インデックスの名前。column_name: インデックスを作成する列。
DROP INDEX:インデックスを削除するために使用されます。
DROP INDEX index_name
ON table_name
index_name: 削除するインデックス名。table_name: インデックスがあるテーブル。
WHERE:フィルタリング条件を指定するために使用されます。
SELECT column_name(s)
FROM table_name
WHERE condition
condition: フィルタリング条件。
ORDER BY:結果セットを並べ替えるために使用されます。
SELECT column_name(s)
FROM table_name
ORDER BY column_name [ASC|DESC]
column_name: 並べ替えに使用する列。ASC: 昇順(デフォルト)。DESC: 降順。
GROUP BY:結果セットを1つ以上の列でグループ化するために使用されます。
SELECT column_name(s), aggregate_function(column_name)
FROM table_name
WHERE condition
GROUP BY column_name(s)
aggregate_function: 集約関数(COUNT、SUM、AVG など)。
HAVING:グループ化された結果セットをフィルタリングするために使用されます。
SELECT column_name(s), aggregate_function(column_name)
FROM table_name
GROUP BY column_name(s)
HAVING condition
condition: フィルタリング条件。
JOIN:2つ以上のテーブルのレコードを結合するために使用されます。
SELECT column_name(s)
FROM table_name1
JOIN table_name2
ON table_name1.column_name = table_name2.column_name
JOIN: INNER JOIN、LEFT JOIN、RIGHT JOIN、FULL JOIN のいずれかです。
DISTINCT:一意の値を返すために使用されます。
SELECT DISTINCT column_name(s)
FROM table_name
column_name(s): 照会する列。
その他の拡張