Perl データ型
Perl は弱い型付けの言語であるため、変数に型を指定する必要はありません。Perl インタープリタがコンテキストに応じて自動的に適切な型を選択します。
Perl には3つの基本的なデータ型があります:スカラ、配列、ハッシュです。以下はこの3つのデータ型の説明です:
| 番号 | 型と説明 |
|---|---|
| 1 | スカラ
スカラは Perl 言語の中で最も単純なデータ型です。このデータ型の変数は、数字、文字列、浮動小数点数を厳密に区別しません。使用時には変数名の前に1つの$、スカラであることを示します。例えば: $myfirst=123; #数字123 $mysecond="123"; #字符串123 |
| 2 | 配列
配列変数は文字@で始まり、インデックスは 0 から始まります。例:@arr=(1,2,3) @arr=(1,2,3) |
| 3 | ハッシュ
ハッシュは順序のないkey/valueペアの集合です。キーを添え字として値を受け取ることができます。ハッシュ変数は文字%で始まります。
%h=('a'=>1,'b'=>2);
|
数値リテラル
一、整数型
Perl は実際には整数をコンピュータの浮動小数点レジスタに格納するため、実際には浮動小数点数として扱われます。
ほとんどのコンピュータでは、浮動小数点レジスタは約16桁の数字を格納でき、それより長いものは切り捨てられます。整数は実際には浮動小数点数の特殊なケースです。
整数型変数と演算:
$x = 12345;
if (1217 + 116 == 1333) {
    # 执行代码语句块
}
8進数と16進数:8進数は 0 で始まり、16進数は 0x で始まります。例えば:
$var1 = 047;    # 等于十进制的39
$var2 = 0x1f;   # 等于十进制的31
二、浮動小数点数
浮動小数点数データの例:11.4 、 -0.3 、.3 、 3. 、 54.1e+02 、 5.41e03。
浮動小数点レジスタは通常、浮動小数点数を正確に格納できないため、誤差が生じます。演算や比較の際には特に注意が必要です。指数の範囲は通常 -309 から +308 までです。
例
上記のプログラムを実行すると、出力結果は次のようになります:
第一个值为:0
第二个值为:0.01
三、文字列
Perl の文字列はスカラを使用して表します。定義方法は C 言語によく似ていますが、Perl では文字列は \0 で終端を示しません。
Perl のダブルクォートとシングルクォートの違い:ダブルクォートは一部のエスケープ文字と変数を正常に解析できますが、シングルクォートは解析できず、そのまま出力されます。
ただし、シングルクォートで定義すると複数行のテキストを使用できます。次のようになります:
#!/usr/bin/perl

$var='这是一个使用

多行字符串文本

的例子';

print($var);
上記のプログラムを実行すると、出力結果は次のようになります:
これは

複数行の文字列テキストを

使用する例です。
Perl 言語でよく使用されるエスケープ文字は次の表のとおりです:
| エスケープ文字 | 意味 |
|---|---|
| \\ | バックスラッシュ |
| \' | シングルクォート |
| \" | ダブルクォート |
| \a | システムベル |
| \b | バックスペース |
| \f | フォームフィード |
| \n | 改行 |
| \r | キャリッジリターン |
| \t | 水平タブ |
| \v | 垂直タブ |
| \0nn | 8進数形式の数値を作成 |
| \xnn | 16進数形式の数値を作成 |
| \cX | 制御文字。x は任意の文字にできます |
| \u | 次の文字を強制的に大文字にする |
| \l | 次の文字を強制的に小文字にする |
| \U | すべての文字を強制的に大文字に変換する |
| \L | すべての文字を強制的に小文字に変換する |
| \Q | \E までの非単語(non-word)文字にバックスラッシュを付ける |
| \E | \L、\U、\Q を終了する |
例
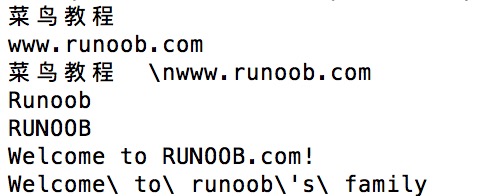
次に、シングルクォートとダブルクォート、およびエスケープ文字の使い方を具体的に見てみましょう:
例
上記の例を実行した出力結果は次のとおりです: