1. Что такое REST
REST — это аббревиатура от Representational State Transfer, что по-китайски означает репрезентативную (прим. ред.: обычно переводится как репрезентативная) передачу состояния. Впервые это понятие появилось в докторской диссертации Роя Филдинга в 2000 году. Рой Филдинг — один из основных авторов спецификации HTTP. В своей диссертации он упомянул: "Цель, с которой я написал эту статью, — понять и оценить архитектурный проект сетевого прикладного программного обеспечения при условии соответствия архитектурным принципам и получить архитектуру с мощной функциональностью, хорошей производительностью и подходящую для коммуникации. REST относится к набору архитектурных ограничений и принципов." Если архитектура соответствует ограничениям и принципам REST, мы называем её RESTful-архитектурой.
Сам REST не создаёт новых технологий, компонентов или сервисов. Идея RESTful заключается в том, чтобы использовать существующие возможности и функции Web и лучше задействовать некоторые рекомендации и ограничения существующих стандартов Web. Хотя сам REST находится под сильным влиянием веб-технологий, теоретически архитектурный стиль REST не привязан к HTTP; однако HTTP в настоящее время является единственным примером, связанным с REST. Поэтому REST, который мы здесь описываем, — это также REST, реализованный через HTTP.
2. Понимание RESTful
Чтобы понять RESTful-архитектуру, нам нужно понять, что на самом деле означает фраза Representational State Transfer и что подразумевает каждое из её слов.
Ниже, объединяя принципы REST, мы будем обсуждать их вокруг ресурсов. С точек зрения определения ресурсов, получения, представления, ассоциации и перехода состояния мы перечислим некоторые ключевые концепции и объясним их.
- Ресурсы и URI
- Унифицированный интерфейс ресурсов
- Представления ресурсов
- Ссылки на ресурсы
- Передача состояния
2.1 Ресурсы и URI
REST расшифровывается как Representational State Transfer. Так что же именно представляется? На самом деле речь идёт о ресурсах. Ресурс — это всё, на что необходимо ссылаться. Ресурс может быть сущностью (например, номер мобильного телефона) или просто абстрактным понятием (например, значение). Вот несколько примеров ресурсов:
- Номер мобильного телефона пользователя
- Персональная информация пользователя
- Пакет GPRS, на который подписано большинство пользователей
- Отношение зависимости между двумя продуктами
- Скидочные пакеты, на которые пользователь может подать заявку
- Потенциальная ценность номера мобильного телефона
Чтобы ресурс можно было идентифицировать, нужен уникальный идентификатор. В вебе таким уникальным идентификатором является URI (Uniform Resource Identifier).
На URI можно смотреть либо как на адрес ресурса, либо как на имя ресурса. Если некоторая информация не представлена через URI, она не может считаться ресурсом, а лишь некоторой информацией о ресурсе. Дизайн URI должен следовать принципу адресуемости, быть самоописательным и по форме вызывать у людей интуитивные ассоциации. Здесь на примере сайта GitHub приведены некоторые довольно удачные URI:
- https://github.com/git
- https://github.com/git/git
- https://github.com/git/git/blob/master/block-sha1/sha1.h
- https://github.com/git/git/commit/e3af72cdafab5993d18fae056f87e1d675913d08
- https://github.com/git/git/pulls
- https://github.com/git/git/pulls?state=closed
- https://github.com/git/git/compare/master…next
Теперь давайте рассмотрим несколько советов по проектированию URI:
- Используйте _ или - для повышения читаемости URI
В прошлом URI в Интернете были сплошными холодными числами или бессмысленными строками, но теперь всё больше и больше сайтов используют _ или - для разделения слов, благодаря чему URI выглядят более дружелюбными к человеку. Например, известное китайское сообщество открытого исходного кода (OSChina) использует этот стиль для адресов своих новостей, например http://www.oschina.net/news/38119/oschina-translate-reward-plan.
- Используйте / для представления иерархических отношений ресурсов
Например, приведённый выше /git/git/commit/e3af72cdafab5993d18fae056f87e1d675913d08 представляет многоуровневый ресурс, относящийся к записи о коммите проекта git пользователя git. Другой пример: /orders/2012/10 можно использовать для представления записей заказов за октябрь 2012 года.
- Используйте ? для фильтрации ресурсов
Многие люди просто рассматривают ? как способ передачи параметров, что может легко сделать URI слишком сложными и трудными для понимания. Вы можете использовать ? для фильтрации ресурсов. Например, /git/git/pulls представляет все запросы на слияние проекта git, тогда как /pulls?state=closed представляет закрытые запросы на слияние проекта git. Такие URL обычно соответствуют результатам запроса при определённых условиях или результатам работы алгоритма.
- , или ; можно использовать для представления отношений между ресурсами одного уровня
Иногда, когда нам нужно представить связь между ресурсами одного уровня, мы можем использовать , или ; для их разделения. Например, если бы GitHub мог сравнивать различия файла между любыми двумя записями коммитов, возможно, он мог бы использовать /git/git /block-sha1/sha1.h/compare/e3af72cdafab5993d18fae056f87e1d675913d08;bd63e61bdf38e872d5215c07b264dcc16e4febca в качестве URI. Однако GitHub в настоящее время использует ... для этого, например /git/git/compare/master...next.
2.2 Унифицированный интерфейс ресурсов
Архитектура RESTful должна следовать принципу унифицированного интерфейса. Унифицированный интерфейс содержит набор ограниченных, предопределённых операций. Независимо от того, что представляет собой ресурс, доступ к нему осуществляется через один и тот же интерфейс. Интерфейс должен использовать стандартные методы HTTP, такие как GET, PUT и POST, и следовать семантике этих методов.
Если ресурсы предоставляются в соответствии с семантикой методов HTTP, интерфейс будет обладать свойствами безопасности и идемпотентности. Например, запросы GET и HEAD безопасны; сколько бы раз их ни запрашивали, состояние сервера не изменится. Запросы GET, HEAD, PUT и DELETE идемпотентны; сколько бы раз ни выполнялась операция над ресурсом, результат всегда одинаков, и последующие запросы не окажут большего влияния, чем первый.
Ниже перечислены типичные способы использования GET, DELETE, PUT и POST:
GET
- Безопасный и идемпотентный
- Получить представление
- Получить представление при изменении (кэш)
- 200 (OK) - Указывает, что представление было отправлено в ответе
- 204 (No Content) - Ресурс имеет пустое представление
- 301 (Moved Permanently) - URI ресурса был обновлён
- 303 (See Other) - Другое (например, балансировка нагрузки)
- 304 (Not Modified) - Ресурс не был изменён (кэш)
- 400 (Bad Request) - Указывает на неверный запрос (например, ошибки параметров)
- 404 (Not Found) - Ресурс не существует
- 406 (Not Acceptable) - Сервер не поддерживает требуемое представление
- 500 (Internal Server Error) - Общий ответ об ошибке
- 503 (Service Unavailable) - Сервер в настоящее время не может обработать запрос
POST
- Не является безопасным и не является идемпотентным
- Создание ресурсов с использованием управляемых сервером (автоматически генерируемых) номеров экземпляров
- Создание дочерних ресурсов
- Частичное обновление ресурсов
- Если он не был изменён, то не обновляйте ресурс (оптимистичная блокировка)
- 200 (OK) - Если существующий ресурс был изменён
- 201 (Created) - Если новый ресурс был создан
- 202 (Accepted) - Запрос принят к обработке, но ещё не завершён (асинхронная обработка)
- 301 (Moved Permanently) - URI ресурса был обновлён
- 303 (See Other) - Другое (например, балансировка нагрузки)
- 400 (Bad Request) - Указывает на неверный запрос
- 404 (Not Found) - Ресурс не существует
- 406 (Not Acceptable) - Сервер не поддерживает требуемое представление
- 409 (Conflict) - Общий конфликт
- 412 (Precondition Failed) - Предусловие не выполнено (например, конфликт при выполнении условного обновления)
- 415 (Unsupported Media Type) - Полученное представление не поддерживается
- 500 (Internal Server Error) - Общий ответ об ошибке
- 503 (Service Unavailable) - Сервер в настоящее время не может обработать запрос
PUT
- Небезопасный, но идемпотентный
- Создать ресурс, используя управляемый клиентом номер экземпляра
- Обновить ресурс путём его замены
- Если не изменён, то обновить ресурс (оптимистичная блокировка)
- 200 (OK) - если существующий ресурс был изменён
- 201 (created) - если новый ресурс был создан
- 301 (Moved Permanently) — URI ресурса изменился
- 303 (See Other) — другое (например, балансировка нагрузки)
- 400 (bad request) — означает неверный запрос
- 404 (not found) — ресурс не существует
- 406 (not acceptable) — сервер не поддерживает требуемое представление
- 409 (conflict) — общий конфликт
- 412 (Precondition Failed) — предварительное условие не выполнено (например, конфликт при выполнении условного обновления)
- 415 (unsupported media type) — полученное представление не поддерживается
- 500 (internal server error) — общий ответ об ошибке
- 503 (Service Unavailable) — служба в настоящее время не может обработать запрос
DELETE
- Небезопасный, но идемпотентный
- Удаление ресурса
- 200 (OK) — ресурс был удалён
- 301 (Moved Permanently) — URI ресурса изменился
- 303 (See Other) — другое, например, балансировка нагрузки
- 400 (bad request) — означает неверный запрос
- 404 (not found) — ресурс не существует
- 409 (conflict) — общий конфликт
- 500 (internal server error) — общий ответ об ошибке
- 503 (Service Unavailable) — сервер в данный момент не может обработать запрос
Теперь давайте рассмотрим некоторые распространённые проблемы на практике:
- В чём разница между POST и PUT при создании ресурсов?
Разница между POST и PUT при создании ресурсов заключается в том, определяется ли имя (URI) создаваемого ресурса клиентом. Например, чтобы добавить категорию java к моей записи в блоге, сгенерированный путь будет category name/categories/java, поэтому можно использовать метод PUT. Однако многие напрямую сопоставляют POST, GET, PUT, DELETE с CRUD, как это делается в типичном RESTful-приложении, реализованном на Rails.
Я думаю, это потому, что Rails по умолчанию использует генерируемые сервером ID в качестве URI, и многие практикуют REST через Rails, что легко приводит к таким недоразумениям.
- Клиенты не обязательно поддерживают все эти методы HTTP, верно?
Такая ситуация действительно существует, особенно с некоторыми старыми клиентами на основе браузеров, которые поддерживают только GET и POST.
На практике и клиенту, и серверу, возможно, придётся пойти на некоторые компромиссы. Например, фреймворк Rails поддерживает передачу реального метода запроса через скрытый параметр _method=DELETE, а клиентские MVC-фреймворки вроде Backbone позволяют передавать _method и устанавливать заголовок X-HTTP-Method-Override, чтобы обойти эту проблему.
- Означает ли унифицированный интерфейс, что методы со специальной семантикой нельзя расширять?
Унифицированный интерфейс не мешает вам расширять методы, пока методы имеют конкретную, идентифицируемую семантику для операций над ресурсами и могут поддерживать единообразие всего интерфейса.
Например, WebDAV расширяет методы HTTP, добавляя LOCK, UPLOCK и другие методы. API GitHub также поддерживает метод PATCH для обновления issues, например:
PATCH /repos/:owner/:repo/issues/:number
Однако учтите, что для нестандартных HTTP-методов, таких как PATCH, серверу необходимо учитывать, смогут ли клиенты их поддерживать.
- Какие указания даёт единообразный интерфейс ресурсов для URI?
Единообразный интерфейс ресурсов требует использовать стандартные HTTP-методы для операций над ресурсами, поэтому URI должны представлять только имена ресурсов и не должны включать операции над ресурсами.
Проще говоря, URI не следует описывать с помощью действий. Например, следующие URI не соответствуют требованиям единообразного интерфейса:
- GET /getUser/1
- POST /createUser
- PUT /updateUser/1
- DELETE /deleteUser/1
Если GET-запрос увеличивает счётчик, нарушает ли это безопасность?
Безопасность не означает, что запрос не производит побочных эффектов. Например, многие платформы для разработки API ограничивают трафик запросов. GitHub, например, ограничивает неаутентифицированные запросы до 60 запросов в час.
Но клиенты не отправляют эти GET- или HEAD-запросы в погоне за побочными эффектами; побочные эффекты — это собственные действия сервера.
Кроме того, сервер не должен делать побочные эффекты слишком масштабными при проектировании, потому что клиенты предполагают, что эти запросы не производят побочных эффектов.
- Допустимо ли напрямую игнорировать кэширование?
Даже если вы используете каждый глагол в соответствии с его исходным назначением, вы всё равно можете легко отключить механизм кэширования. Простейший способ — добавить в свой HTTP-ответ заголовок: Cache-control: no-cache. Однако, поступая так, вы также теряете поддержку эффективного кэширования и ревалидации (с использованием таких механизмов, как Etag).
При реализации клиента для сервиса в стиле REST клиентам также следует в полной мере использовать существующие механизмы кэширования, чтобы не получать представления заново каждый раз.
- Необходимо ли обрабатывать коды ответов?
Коды ответов HTTP можно использовать для обработки разных ситуаций. Правильное использование этих кодов состояния означает, что клиенты и серверы могут взаимодействовать на уровне с более богатой семантикой.
Например, код ответа 201 ("Created") указывает, что новый ресурс был создан, а его URI находится в заголовке ответа Location.
Если вы не используете богатую прикладную семантику кодов состояния HTTP, вы упустите возможности повысить повторное использование, улучшить интероперабельность и усилить слабую связанность.
Если эти так называемые RESTful-приложения должны предоставлять информацию об ошибках через тела ответов, то SOAP уже таков и может это обеспечить.
2.3 Представления ресурсов
Выше упоминалось, что клиенты могут получать ресурсы с помощью методов HTTP, верно? Нет, если быть точным, клиенты получают лишь представление ресурса. Внешнее представление ресурса может принимать несколько форм представления, и между клиентом и сервером также передаётся представление ресурса, а не сам ресурс. Например, текстовые ресурсы могут использовать такие форматы, как html, xml и json, а изображения могут отображаться с помощью PNG или JPG.
Представление ресурса включает данные и метаданные, описывающие данные. Например, заголовок HTTP "Content-Type" является таким атрибутом метаданных.
Итак, как клиент узнает, какую форму представления предоставляет сервер?
Ответ — через согласование содержимого HTTP. Клиент может запросить определенный формат представления с помощью заголовка Accept, а сервер сообщает клиенту форму представления ресурса через Content-Type.
На примере GitHub запросим представление json ресурса организации:

Если бы GitHub также поддерживал формат представления xml, результат выглядел бы так:

Теперь рассмотрим некоторые распространенные варианты дизайна на практике:
Включение номеров версий в URI
Некоторые API включают номера версий в URI, например:
- http://api.example.com/1.0/foo
- http://api.example.com/1.2/foo
- http://api.example.com/2.0/foo
Если рассматривать номер версии как другую форму представления ресурса, то следует использовать только один URL и различать его с помощью заголовка Accept. Снова возьмем GitHub в качестве примера: его полный формат Accept: application/vnd.github[.version].param[+json]
Для версии v3 это будет Accept: application/vnd.github.v3. Для приведенного выше примера можно аналогично использовать следующий заголовок:
- Accept: vnd.example-com.foo+json; version=1.0
- Accept: vnd.example-com.foo+json; version=1.2
- Accept: vnd.example-com.foo+json; version=2.0
Используйте суффиксы URI для различения форматов представления
Фреймворк Rails, например, поддерживает использование /users.xml или /users.json для различения разных форматов. Такой подход, несомненно, более интуитивен для клиентов, но он смешивает имя ресурса с формой представления ресурса. Лично я считаю, что для различения форматов представления всё же следует предпочитать согласование содержимого.
Как обрабатывать неподдерживаемые форматы представления
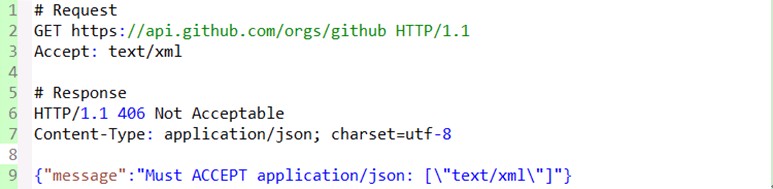
Что делать, когда сервер не поддерживает запрошенный формат представления? Если сервер его не поддерживает, он должен вернуть ответ HTTP 406, указывающий, что он отказывается обрабатывать запрос. В качестве примера возьмём GitHub: ниже приведён результат запроса XML-представления ресурса:
2.4 Ссылки на ресурсы
Мы знаем, что REST использует стандартные методы HTTP для работы с ресурсами, но понимать его просто как архитектуру веб-базы данных с CRUD — слишком упрощённо.
Этот антипаттерн игнорирует ключевую концепцию: «гипермедиа как движок состояния приложения». Что такое гипермедиа?
Когда вы просматриваете веб-страницы, переходя по одной ссылке на страницу, затем по другой ссылке на другую страницу, вы используете концепцию гипермедиа: связывание ресурсов один за другим.
Чтобы достичь этого, в форматы представления необходимо добавить ссылки, чтобы направлять клиентов. В книге «RESTful Web Services» автор называет эту характеристику наличия ссылок связностью. Ниже давайте рассмотрим несколько конкретных примеров.
Ниже приведён запрос к GitHub для получения списка проектов в организации. Вы можете видеть, что в заголовок ответа добавлен заголовок Link, чтобы сообщить клиенту, как перейти к следующей странице и последней странице записей. В теле ответа URL используются для ссылки на владельца проекта и адрес проекта.

Другой пример — приведённый ниже: после создания заказа ссылки используются, чтобы подсказать клиенту, как произвести оплату.

Приведённые выше примеры показывают, как использовать гипермедиа для повышения связности ресурсов. Многие люди тратят много времени на поиск красивых URI при проектировании RESTful-архитектур, но игнорируют гипермедиа. Поэтому больше времени следует уделять предоставлению ссылок в представлениях ресурсов, а не сосредотачиваться на «CRUD ресурсов».
2.5 Передача состояния
С вышеизложенной основой становится легко понять передачу состояния в REST.
Однако сначала давайте обсудим принцип взаимодействия без сохранения состояния в REST. На первый взгляд это кажется противоречивым: если оно без сохранения состояния, как может существовать передача состояния?
На самом деле упомянутый здесь принцип взаимодействия без сохранения состояния не означает, что клиентское приложение не может иметь состояние, а скорее то, что сервер не должен сохранять состояние клиента.
2.5.1 Состояние приложения и состояние ресурса
Фактически состояние следует различать как состояние приложения и состояние ресурса. Клиент отвечает за поддержание состояния приложения, а сервер поддерживает состояние ресурса.
Взаимодействие между клиентом и сервером должно быть без сохранения состояния, и каждый запрос должен содержать всю информацию, необходимую для обработки этого запроса.
Серверу не нужно хранить состояние приложения между запросами. Только при получении фактического запроса сервер обращает внимание на состояние приложения.
Этот принцип взаимодействия без сохранения состояния позволяет серверу и посредникам понимать независимые запросы и ответы.
При выполнении нескольких запросов одному и тому же клиенту больше не нужно зависеть от одного и того же сервера, что упрощает реализацию высокомасштабируемых и высокодоступных серверов.
Но иногда мы создаём проекты, нарушающие принцип коммуникации без сохранения состояния, например используем cookies для отслеживания состояния сеанса на стороне сервера; распространённый пример — JSESSIONID в J2EE.
Это означает, что cookies, отправляемые браузером с каждым запросом, используются для построения состояния сеанса.
Конечно, если cookies хранят информацию, которую сервер может проверить, не полагаясь на состояние сеанса (например, токен аутентификации), такие cookies также соответствуют принципам REST.
2.5.2 Передача состояния приложения
Теперь передачу состояния легко понять: состояние «сеанса» не хранится на сервере как состояние ресурса, а отслеживается клиентом как состояние приложения. Состояние приложения клиента изменяется под управлением гипермедиа, предоставляемых сервером. Сервер использует гипермедиа, чтобы сообщить клиенту, в какие последующие состояния можно перейти из текущего состояния.
Ссылки вроде «Следующая страница» выполняют эту функцию продвижения состояния — они подсказывают, как перейти из текущего состояния в следующее возможное состояние.
3. Резюме
В настоящее время такие проекты, как Guangdong XXX version и XXX, используют традиционные RPC и SOAP-веб-сервисы, тогда как бэкенд проекта Mobile Southern Base XXXX, хотя и использует формат JSON для взаимодействия, всё ещё выполнен в стиле RPC. В этой статье предпринимается попытка быстро разобраться в концепциях, лежащих в основе архитектуры RESTful, с точки зрения определения ресурсов, их извлечения, представления, связывания и перехода состояний. Архитектура RESTful по своей философии сильно отличается от традиционных RPC, SOAP и других подходов. Надеюсь, эта статья поможет вам понять REST.