Zookeeper では、主に ZAB プロトコルに依存して分散データの一貫性を実現しています。
ZAB プロトコルは2つの部分に分かれています:
- メッセージブロードキャスト
- クラッシュリカバリ
メッセージブロードキャスト
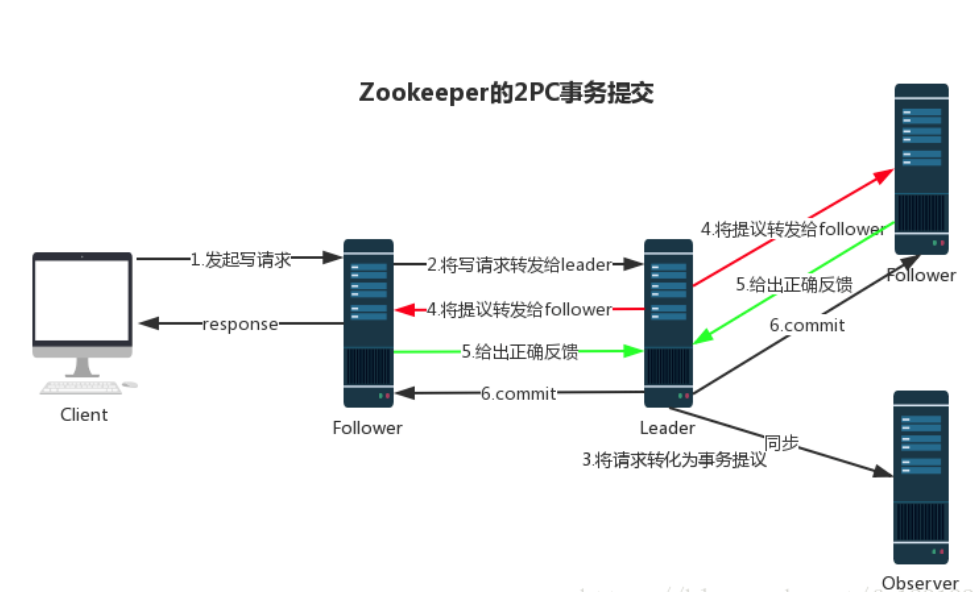
Zookeeper は単一のメインプロセスである Leader を使用して、クライアントからのすべてのトランザクション要求を受信・処理し、ZAB プロトコルの原子ブロードキャストプロトコルを用いて、トランザクション要求を Proposal として全ての Follower ノードにブロードキャストします。クラスタ内の過半数の Follower サーバーが正しい ACK を返すと、Leader は再びすべての Follower サーバーに commit メッセージを送信し、この提案をコミットします。このプロセスは 2PC トランザクションコミットと略称できます。全体のフローは下図を参照してください。Observer ノードは Leader データの同期のみを担当し、2PC データ同期プロセスには参加しないことに注意してください。
クラッシュリカバリ
通常のメッセージブロードキャスト状況では問題なく動作しますが、Leader サーバーがクラッシュした場合、またはネットワークの原因により Leader サーバーが過半数の Follower との通信を失った場合、クラッシュリカバリモードに入り、新しい Leader サーバーを選出する必要があります。このプロセスでは、データ不整合の2つの潜在的な問題が発生する可能性があり、ZAB プロトコルの特性によって回避する必要があります。
- 1. Leader サーバーが commit メッセージを送信した後、すぐにクラッシュする
- 2. Leader サーバーが proposal を提出した直後にクラッシュする
ZAB プロトコルのリカバリモードでは、以下の戦略を使用します:
- 1. zxid が最大のノードを新しい leader として選出する
- 2. 新しい leader はトランザクションログ内の未コミットのメッセージを処理する
次の章で leader 選出プロセスを詳しく説明します。