正規表現 - アサーション
アサーション(Assertion)は、正規表現においてマッチする位置を指定するためのメタ文字です。実際の文字にはマッチせず、文字と文字の間の位置にマッチします。
長い文章の中で、すべての数字ではなく、価格の後にある数字だけを見つけたいとします。普通の正規表現ではすべての数字にマッチするかもしれませんが、アサーションを使えば、次のように正確に指定できます。価格の直後にある数字だけにマッチさせる。
この記事では、正規表現における4つの主要なアサーション(肯定先読み、否定先読み、肯定後読み、否定後読み)について体系的に学びます。
アサーションの特徴
- ゼロ幅:マッチする文字の位置を占有しない
- 条件チェック:特定の条件を満たすかどうかだけをチェックする
- マッチ結果に影響しない:マッチの制約条件としてのみ機能する
例
const regex = /foo(?=bar)/;
console.log(regex.test("foobar")); // true
console.log(regex.test("food")); // false
アサーションの種類
正規表現のアサーションは、主に2つの大分類・4つのタイプに分けられます。
| アサーションの種類 | 正規表現の構文 | 別名 | チェックする方向 | 期待する条件 | わかりやすい説明 |
|---|---|---|---|---|---|
| 肯定先読み | (?=pattern) |
正先読み | 右(前)へ | 存在する pattern |
探している位置は、その右側が必ず...である |
| 否定先読み | (?!pattern) |
負先読み | 右(前)へ | 存在しない pattern |
探している位置は、その右側に決して...であってはならない |
| 肯定後読み | (?<=pattern) |
正後読み | 左(後ろ)へ | 存在する pattern |
探している位置は、その左側が必ず...である |
| 否定後読み | (?<!pattern) |
負後読み | 左(後ろ)へ | 存在しない pattern |
探している位置は、その左側に決して...であってはならない |
肯定先読み(?=...)
肯定先読み指定されたパターンが後ろ(右側)に必ず続くような位置にマッチするために使います。...。
構文とパラメータ
- 構文:
(?=pattern) - 働き:現在位置の右側がマッチするかをチェックします。
patternマッチした場合、アサーションは成功し、エンジンは現在位置に戻って後続のマッチングを続行します。 - 重要な特性:ゼロ幅、つまりチェックするだけで、いかなる文字も「消費」しません。
pattern内の内容は、最終のマッチ結果の一部にはなりません。
コード例1:価格の数字を抽出する
テキストの文字列があり、すべての価格:の後の金額の数字を抽出したいとします。
例:JavaScript
// 肯定先読み
// 1つ以上の数字にマッチするが、右側に"元"が続く必要がある
// "元"自体はマッチ結果に含まれない
const pattern = /\d+(?=元)/g;
const matches = text.match(pattern);
console.log("一致した価格の数字:", matches);
// 出力:['299', '599', '20']
例:Python
text = "商品A价格:299元,商品B价格:599元,运费:20元。"
# 肯定先読みを使用
# 1つ以上の数字(\d+)にマッチするが、その数字の右側に必ず"元"が続く必要がある
# 注意:"元"自体はマッチ結果に含まれない
pattern = r'\d+(?=元)'
matches = re.findall(pattern, text)
print("一致した価格の数字:", matches)
# 出力:マッチした価格の数字: ['299', '599', '20']
コードの解説:
\d+は主式であり、1つ以上の数字にマッチします。(?=円)はアサーションであり、次のことをチェックします。\d+マッチした数字列の右側に"元"の文字が続くかどうか。- エンジンはまず
299を見つけ、右を見ると"元"であるため、アサーションは成功し、よって299が記録されます。 - 続いて
599を見つけ、右側が"元"なので成功し、記録します。 - を見つけ、
20右側が"元"なので成功し、記録します。最終的に、数字の部分だけが得られます。
コード例2:複雑なパスワードの検証
パスワードには、大文字が少なくとも1つ、小文字が少なくとも1つ、数字が少なくとも1つ含まれている必要があります。
例:JavaScript
// 複数の肯定先読み
const pattern = /^(?=.*[A-Z])(?=.*[a-z])(?=.*\d).{8,}$/;
// ^ 文字列の先頭
// (?=.*[A-Z]) 右側に少なくとも1つの大文字が存在する必要がある
// (?=.*[a-z]) 右側に少なくとも1つの小文字が存在する必要がある
// (?=.*\d) 右側に少なくとも1つの数字が存在する必要がある
// .{8,} 全体の長さは少なくとも8
// $ 文字列の末尾
return pattern.test(password);
}
// テストデータ
const passwords = ["Weak", "strong123", "STRONG123", "Strong123"];
passwords.forEach(pwd => {
console.log(`密码'${pwd}'有効かどうか:${validatePassword(pwd)}`);
});
// 出力:
// パスワード 'Weak' は有効か:false
// パスワード 'strong123' は有効か:false
// パスワード 'STRONG123' は有効か:false
// パスワード 'Strong123' は有効か:true
例:Pyhton
def validate_password(password):
# 複数の肯定先読みを使用して条件をそれぞれチェックします
pattern = r'^(?=.*[A-Z])(?=.*[a-z])(?=.*\d).{8,}$'
# ^ は文字列の先頭を表す
# (?=.*[A-Z]) アサーション:現在位置(先頭)から右を見たとき、任意の文字(.*)の後に大文字が1つ見つかる必要がある
# (?=.*[a-z]) アサーション:同様に先頭から右を見たとき、小文字が1つ見つかる必要がある
# (?=.*\d) アサーション:先頭から右を見たとき、数字が1つ見つかる必要がある
# .{8,} 主式:任意の文字に少なくとも8回マッチする(全体の長さの要件)
# $ は文字列の末尾を表す
if re.match(pattern, password):
return True
else:
return False
# テストデータ
passwords = ["Weak", "strong123", "STRONG123", "Strong123"]
for pwd in passwords:
print(f"パスワード '{pwd}' が有効かどうか:{validate_password(pwd)}")
# 出力:
# パスワード 'Weak' は有効か:False # 長さが足りず、数字も不足
# パスワード 'strong123' は有効か:False # 大文字が不足
# パスワード 'STRONG123' は有効か:False # 小文字が不足
# パスワード 'Strong123' は有効か:True # すべての条件を満たす
否定先読み(?!...)
否定先読み肯定先読みとは逆です。それは、この位置の後ろ(右側)に指定されたパターンが続いて現れてはならない位置にマッチします。...。
構文とパラメータ
- 構文:
(?!pattern) - 機能:現在位置の右側がマッチしないかどうかを確認する
pattern。マッチしない場合、アサーションは成功します。 - 重要な特徴:同じくゼロ幅です。
コード例:ing で終わらない単語を検索する
文の中で、~で終わらないすべてのing単語を検索します。
例:JavaScript
const text1 = "playing swimming run walk jumping sing";
const pattern1 = /\b\w+(?<!ing)\b/g;
console.log(text1.match(pattern1));
// ['run', 'walk', 'sing']
// 例2:q で終わらない単語にマッチ(正しい意味論版)
const text2 = "I like faq apple Iraq you banana q";
const pattern2 = /\b\w*[^q\W]\b/g;
// 意味:
// [^q\W] 単語の最後の文字が q ではない
// 「最後が q ではない」という実際の要件には (?!q) よりも適合する
console.log(text2.match(pattern2));
// ['I', 'like', 'apple', 'you', 'banana']
// 例3:.js で終わらないファイル名にマッチ
const files = "index.js app.ts config.json main.js readme.md";
const pattern3 = /\b\w+\.(?!js\b)\w+\b/g;
// 意味: \.(?!js\b) ドットの後に js があってはならない
console.log(files.match(pattern3));
// ['app.ts', 'config.json', 'readme.md']
肯定後読み(?<=...)
肯定後読みアサーション指定されたパターンが直前(左側)に隣接して現れる必要がある位置にマッチするために使用します...。
注意:すべてのプログラミング言語の正規表現エンジンが後読みアサーションをサポートしているわけではありません。JavaScript は ES2018 以降で完全にサポートされ、Python のreモジュールがサポートしています。
構文とパラメータ
- 構文:
(?<=pattern) - 機能:現在位置の左側がマッチするかどうかを確認する
pattern。マッチする場合、アサーションは成功します。 - 重要な特徴:ゼロ幅です。
pattern固定長である必要があります(*或+などの可変長量指定子は使用できません、一部の実装では)。
コード例:通貨記号の後の金額を抽出する
ドルまたはポンド記号の後の数字を抽出しますが、記号自体は含みません。
例:JavaScript
const text1 = "Price: $199, £89, ¥1200";
const pattern1 = /(?<=\$|£)\d+/g;
// 意味:
// (?<=\$|£) 左側は $ または £ でなければならない
// \d+ 数字自体にマッチ
console.log(text1.match(pattern1));
// ['199', '89']
// 例2:コロンの後の数字にマッチ
const text2 = "port:8080 pid:1234 uid:1000";
const pattern2 = /(?<=:)\d+/g;
// 左側は : でなければならない
console.log(text2.match(pattern2));
// ['8080', '1234', '1000']
// 例3:バージョン番号のサブバージョンにマッチ(メジャーバージョン番号の後)
const text3 = "v1.2 v2.15 v10.3";
const pattern3 = /(?<=v\d+\.)\d+/g;
// 左側は v + 数字 + ドットでなければならない
console.log(text3.match(pattern3));
// ['2', '15', '3']
// 例4:@ の後のユーザー名にマッチ(@ を含まない)
const text4 = "hello @alice and @bob_smith";
const pattern4 = /(?<=@)[a-zA-Z_]\w*/g;
console.log(text4.match(pattern4));
// ['alice', 'bob_smith']
// 例5:中国語の「第 X 章」の章番号にマッチ
const text5 = "第1章 第12章 第3章";
const pattern5 = /(?<=第)\d+(?=章)/g;
// 左右を同時に制約するため、より明確
console.log(text5.match(pattern5));
// ['1', '12', '3']
否定後読み(?<!...)
否定後読みアサーション肯定後読みアサーションの逆です。ある位置にマッチします。この位置の前(左側)では、指定されたパターンが隣接して現れてはなりません。...。
構文とパラメータ
- 構文:
(?<!pattern) - 機能:現在位置の左側がマッチしないかどうかを確認する
pattern。 - 重要な特徴:ゼロ幅であり、通常は
pattern固定長である必要があります。
コード例:非負整数を検索する
テキスト内で、負の数ではないすべての整数にマッチします(つまり、左側にマイナス記号がない-数字)。
例:JavaScript
// 否定後読みアサーション(lookbehind)
// 数字にマッチするが、左側がマイナス記号 - であってはならない
const pattern = /(?<!-)\b\d+\b/g;
const matches = text.match(pattern);
console.log("非負整数:", matches);
// 出力:['3', '22']
// -5、-1 の左側は '-' のため、アサーションは失敗し、マッチしない
総合応用とフローチャート
4種類のアサーションの動作フローをより直感的に理解するために、以下のフローチャートで複数のアサーションを含む複雑なマッチングプロセスを表すことができます:
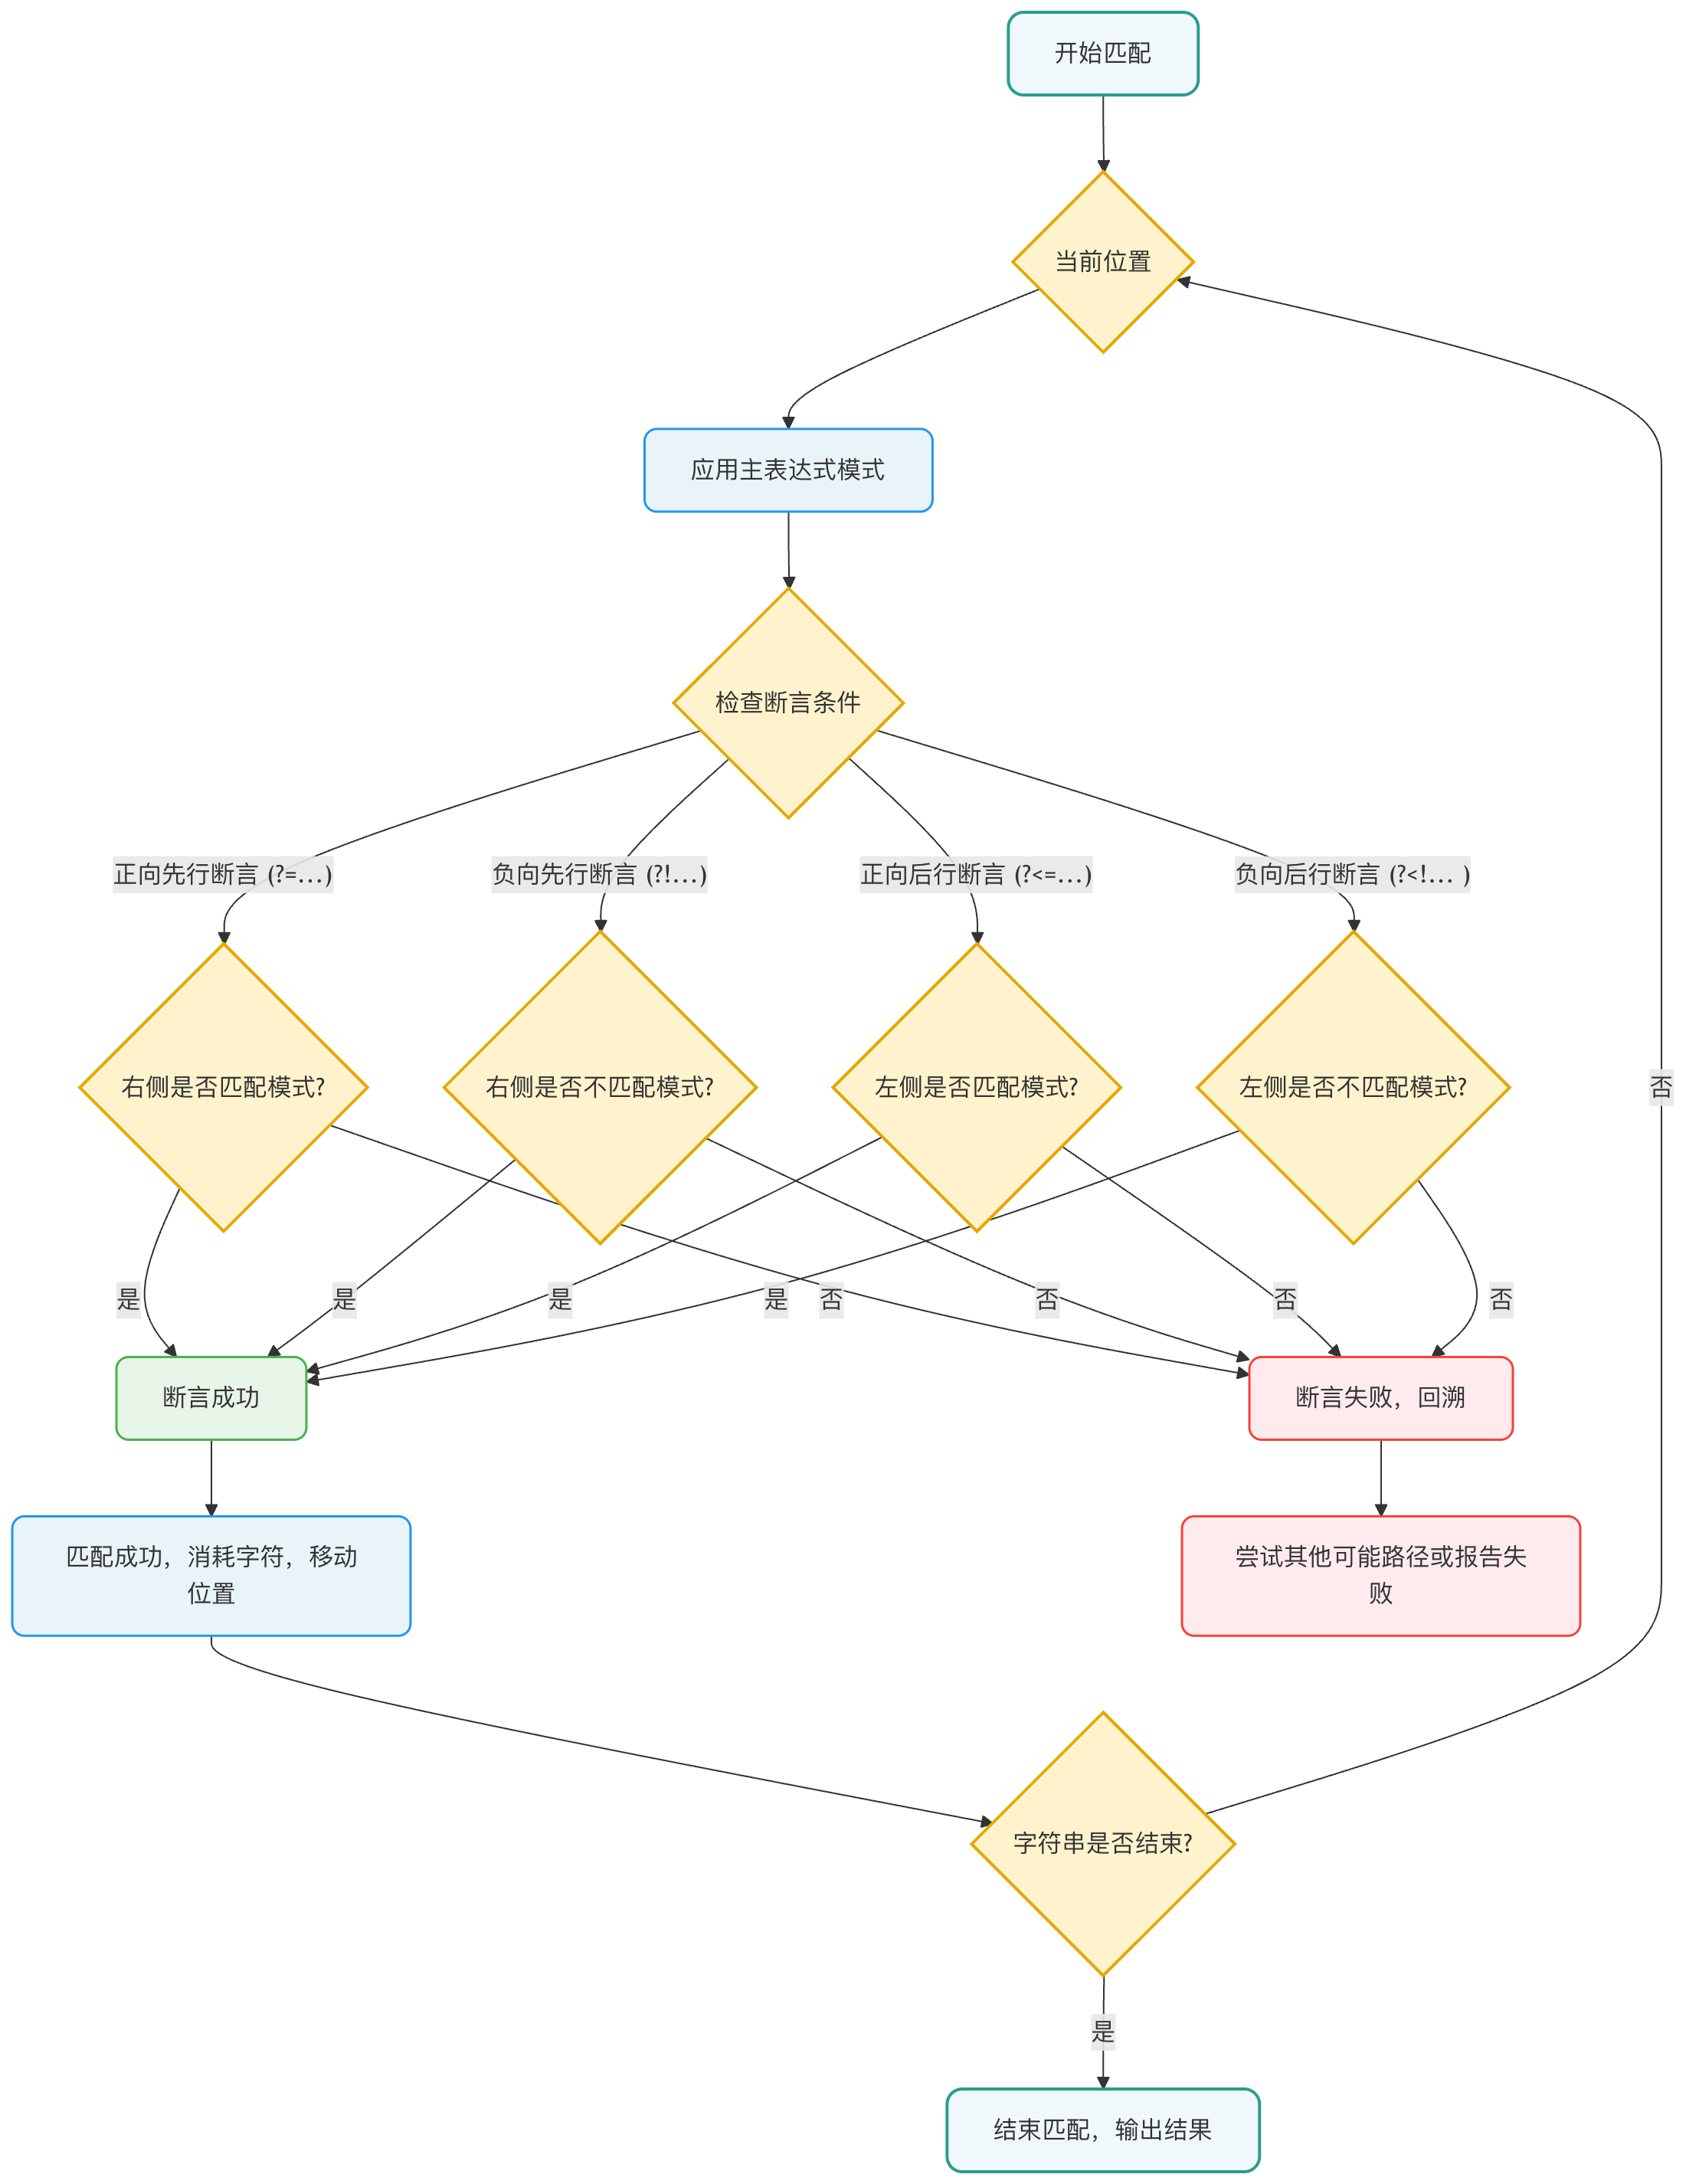
フローチャートの説明:この図は、正規表現エンジンがマッチング時にアサーションをどのように処理するかを示しています。核心となるのは、アサーションが独立したチェックノードであることです。エンジンは主式がマッチを試みる現在位置で、アサーションの種類に応じて、左または右のコンテキストをチェックします。すべてのアサーション条件が満たされた場合のみ、マッチは続行され、文字を「消費」します。そうでない場合、エンジンはバックトラックして他の可能性を試すか、マッチ失敗を宣言します。