L'élection du leader de Zookeeper comporte deux phases : l'une est l'élection du leader lors du démarrage du serveur, et l'autre se produit lorsque le serveur leader tombe en panne pendant l'exploitation. Avant d'analyser le principe d'élection, commençons par présenter quelques paramètres importants.
- ID du serveur (myid) : plus le nombre est grand, plus le poids est important dans l'algorithme d'élection.
- ID de transaction (zxid) : plus la valeur est grande, plus les données sont récentes et plus le poids est important.
- Horloge logique (epoch-logicalclock) : les valeurs de l'horloge logique sont identiques dans le même tour de vote, et la valeur augmente après chaque vote terminé.
État de l'élection :
- LOOKING: état de campagne
- FOLLOWING: état de suiveur, synchronise l'état du leader, participe au vote.
- OBSERVING: état d'observateur, synchronise l'état du leader, ne participe pas au vote.
- LEADING: état de leader
1. Élection du leader au démarrage du serveur
Lorsque chaque nœud démarre, il est dans l'état LOOKING (observation), puis le processus principal d'élection commence. Ici, nous prenons comme exemple un cluster composé de trois machines. Lorsque le premier serveur, server1, démarre, l'élection du leader ne peut pas être effectuée. Lorsque le second serveur, server2, démarre, les deux machines peuvent communiquer entre elles et entrent dans le processus d'élection du leader.
-
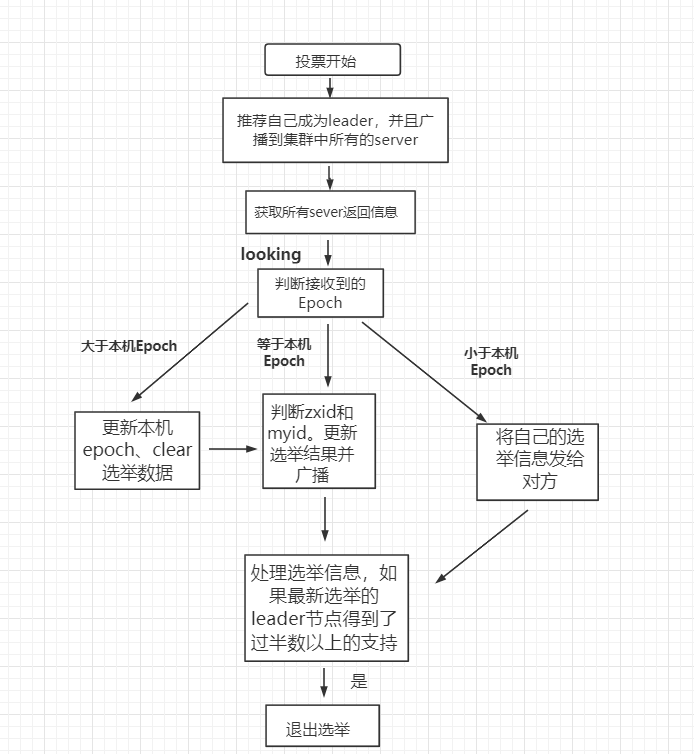
(1) Chaque serveur émet un vote. Comme il s'agit de la situation initiale, server1 et server2 votent tous deux pour eux-mêmes comme serveur leader. Chaque vote contient le myid, le zxid et l'epoch du serveur recommandé, représentés par (myid, zxid). À ce moment, le vote de server1 est (1,0), le vote de server2 est (2,0), puis chacun envoie son propre vote aux autres machines du cluster.
-
(2) Recevoir les votes de chaque serveur. Après que chaque serveur du cluster a reçu un vote, il vérifie d'abord la validité du vote, par exemple s'il s'agit du vote de ce tour (epoch) et s'il provient d'un serveur dans l'état LOOKING.
-
(3) Traiter les votes séparément. Pour chaque vote, le serveur doit comparer les votes des autres serveurs avec son propre vote. Les règles de comparaison sont les suivantes :
- a. Comparer d'abord l'epoch.
- b. Vérifier le zxid. Le serveur avec le zxid le plus grand est préféré comme leader.
- c. Si le zxid est identique, comparez alors le myid. Le serveur ayant le myid le plus grand devient le serveur leader.
-
(4) Compter les votes. Après chaque vote, le serveur comptabilise les informations de vote et détermine si plus de la moitié des machines ont reçu les mêmes informations de vote. server1 et server2 déterminent tous deux que deux machines du cluster ont accepté le vote (2,0), donc server2 a été sélectionné comme nœud leader.
-
(5) Modifier l'état du serveur. Une fois le leader déterminé, chaque serveur met à jour son propre état en conséquence. S'il est follower, il passe à FOLLOWING ; s'il est leader, il passe à LEADING. À ce moment-là, server3 démarre et rejoint directement, en se changeant en FOLLOWING.
2. Élection du leader pendant le fonctionnement
Lorsque le serveur leader du cluster tombe en panne ou devient indisponible, l'ensemble du cluster ne peut plus fournir de services à l'extérieur et entre dans un nouveau cycle d'élection du leader.
- (1) Modifier l'état. Après le plantage du leader, les autres serveurs non-Observer changent leur propre état de serveur en LOOKING.
- (2) Chaque serveur émet un vote. Pendant le fonctionnement, le zxid de chaque serveur peut être différent.
- (3) Traiter les votes. Les règles sont les mêmes que dans le processus de démarrage.
- (4) Compter les votes. Identique au processus de démarrage.
- (5) Modifier l'état du serveur. Identique au processus de démarrage.