Nombres aléatoires
En Verilog, la tâche système $random(seed) est utilisée pour générer des nombres aléatoires, où seed est la graine du générateur de nombres aléatoires.
Des valeurs de seed différentes produisent des nombres aléatoires différents. Si la seed est identique, les nombres aléatoires générés sont également identiques.
Vous pouvez attribuer une valeur initiale à seed, ou omettre l'option seed ; la valeur initiale par défaut de seed est 0.
Le code suivant montre comment appeler $random sans utiliser l'option seed, et en spécifiant et modifiant la seed :
Exemple
integer seed ;
initial begin
seed = 2 ;
#30 ;
seed = 10 ;
end
//sans seed
reg [15:0] randnum_noseed ;
always@(posedge clk) begin
randnum_noseed <= $random(); // Ne pas spécifier la graine aléatoire
end
//avec graine
reg [15:0] randnum_wtseed ;
always@(posedge clk) begin
randnum_wtseed <= $random(seed); // Spécifier la graine aléatoire
end
La forme d'onde de simulation est la suivante.
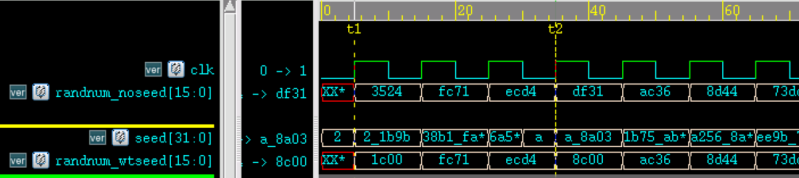
Qu'une valeur initiale soit attribuée ou non, chaque fois qu'un nombre aléatoire est généré, la valeur de graine change, et le nombre aléatoire change en conséquence.
Chaque fois que la valeur de graine est modifiée, la valeur aléatoire de sortie actuelle change ; toutefois, à l'état suivant, la tendance du nombre aléatoire revient à la séquence aléatoire interne générée par le système.
Par exemple, dans le diagramme de simulation, aux instants t1 et t2 les graines aléatoires sont différentes, donc les nombres aléatoires générés sont également différents. Mais pendant les autres cycles d'horloge, les nombres aléatoires générés sont les mêmes.
Il est recommandé de ne pas spécifier l'option de graine lors de l'appel de la tâche système $random, ou d'utiliser une variable pour transmettre le paramètre lors de la spécification de l'option de graine.
Il n'est pas recommandé d'écrire une constante dans le paramètre de graine lors de l'appel de $random. Dans ce cas, la valeur de graine est fixe, et un seul nombre aléatoire peut être généré. Par exemple, le style de codage suivant n'est pas recommandé :
randnum_wtseed <= $random(2); //不建议将常数项指定给 seed
Vous pouvez utiliser l'opération modulo pour limiter les nombres aléatoires à une certaine plage de données. Par exemple :
Exemple
parameter MAX_NUM = 512;
parameter MIN_NUM = 256;
reg [15:0] num_range1, num_range2, num_range3 ;
always@(posedge clk) begin
// Les nombres aléatoires générés vont de -511 à 511, ±(MAX_NUM-1)
num_range1 <= $random() % MAX_NUM;
// Les nombres aléatoires générés vont de 0 à 511, (0 ~ MAX_NUM-1)
num_range2 <= {$random()} % MAX_NUM;
// Les nombres aléatoires générés vont de MIN_NUM à MAX_NUM, bornes incluses
num_range3 <= MIN_NUM + {$random()} % (MAX_NUM-MIN_NUM+1);
end
Les nombres aléatoires sont affichés au format décimal signé. Les premiers résultats de données sont les suivants :

Distributions de probabilité
Verilog fournit de nombreuses tâches système qui génèrent des données selon certaines distributions de probabilité. Une brève description est la suivante :
| Tâche système | Format d'appel | Description de la tâche |
|---|---|---|
| Distribution uniforme | $dist_uniform(seed, start, end); | start et end sont le début et la fin des données |
| Distribution normale | $dist_normal (seed, mean, std_dev); | mean est l'espérance, std_dev est l'écart-type |
| Distribution de Poisson | $dist_poisson(seed, mean); | mean est l'espérance (égale à l'écart-type) |
| Distribution exponentielle | $dist_exponential(seed , mean); | mean est le nombre d'occurrences d'événements par unité de temps |
| Distribution du khi-deux | $dist_chi_square(seed, free_deg); | free_deg est le nombre de degrés de liberté |
| Distribution t | $dist_t(seed, free_deg); | free_deg est le nombre de degrés de liberté |
| Distribution d'Erlang | $dist_erlang(seed, k_stage, mean); | k_stage est le nombre d'étapes, mean est l'espérance |
Distribution uniforme
Une distribution uniforme a des probabilités égales de prendre des valeurs dans des intervalles de longueur égale.
La fonction de densité de probabilité et le diagramme de distribution de probabilité sont les suivants :


En fait, la tâche système $random implémente une distribution uniforme.
Le code pour appeler $dist_uniform afin de générer des données uniformément distribuées sur l'intervalle (256, 512) est le suivant :
Exemple
reg [15:0] data_uniform;
always@(posedge clk) begin // Générer des nombres aléatoires entre MIN_NUM et MAX_NUM
data_uniform <= $dist_uniform(seed_dis, MIN_NUM, MAX_NUM);
end
Distribution normale
L'espérance mathématique d'une distribution normale est μ, l'écart type est σ, notéeN (μ, σ²)。
Une distribution normale d'espérance mathématique 0 et d'écart type 1 est appelée distribution normale standard.
La courbe de la distribution normale est en forme de cloche, basse des deux côtés, haute au milieu et symétrique à gauche et à droite.
La fonction de densité de probabilité et le diagramme de distribution de la distribution normale sont les suivants :


Le code pour appeler $dist_normal afin de générer des données de distribution normale standard avec une espérance de 0 et un écart type de 1 est le suivant :
Exemple
reg [15:0] data_normal;
always@(posedge clk) begin // Distribution normale standard avec une espérance de 0 et un écart-type de 1
data_normal <= $dist_normal(seed_dis, 0, 1);
end
Distribution de Poisson
La distribution de Poisson est utilisée pour décrire la probabilité qu'un événement se produise X fois dans un certain intervalle de temps ou d'espace.
La distribution de Poisson a la même espérance mathématique et le même écart-type, tous deux égaux à λ. Sa fonction de densité de probabilité et son diagramme de distribution sont les suivants :


Le code permettant d'appeler $dist_poisson pour générer des données de distribution de Poisson avec une espérance de 4 est le suivant :
Exemple
reg [15:0] data_poisson;
always@(posedge clk) begin
data_poisson <= $dist_poisson(seed_dis, 4);
end
Distribution exponentielle
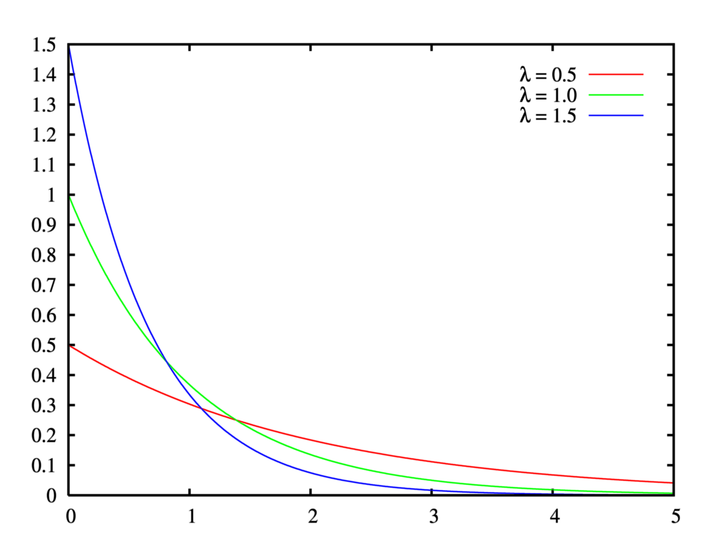
La distribution exponentielle est utilisée pour décrire la probabilité de l'intervalle de temps entre les occurrences d'événements aléatoires dans un processus de Poisson. Un processus de Poisson est un processus dans lequel les événements se produisent de manière continue et indépendante à un taux moyen constant. Par exemple, l'intervalle de temps entre l'arrivée de deux bus lorsqu'on attend à un arrêt de bus suit une distribution exponentielle.
Soit λ>0 le nombre d'occurrences d'événements par unité de temps (également appelé paramètre de taux), et x l'intervalle de temps entre les occurrences d'événements. Alors sa fonction de densité de probabilité et son diagramme de distribution sont les suivants :

Le code permettant d'appeler $dist_exponential pour générer des données de distribution exponentielle avec un paramètre de taux de 1 est le suivant :
Exemple
reg [15:0] data_exp;
always@(posedge clk) begin
data_exp <= $dist_exponential(seed_dis, 1);
end
Distribution du khi-deux
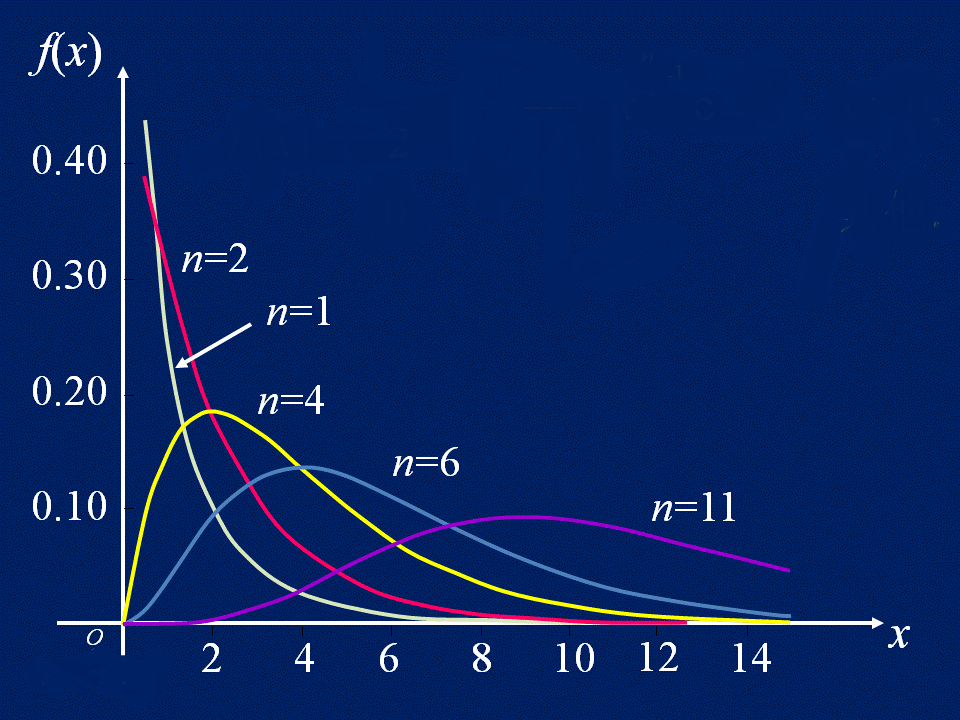
La loi de distribution d'une nouvelle variable aléatoire formée par la somme des carrés de n variables aléatoires qui suivent la distribution normale standard est appelée la loi du khi-deux, notée , où n est appelé le nombre de degrés de liberté.
La fonction de densité de probabilité et le diagramme de distribution de la loi du khi-deux sont les suivants :
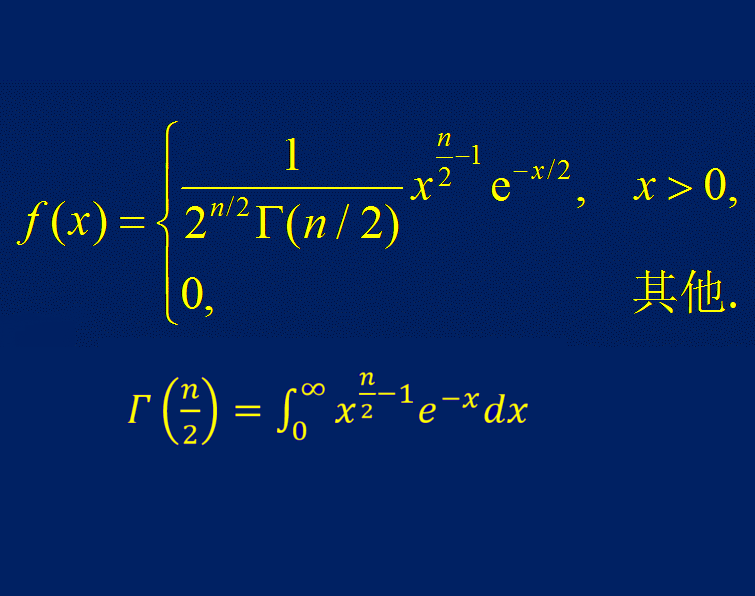
Le code pour appeler $dist_chi_square afin de générer des données de distribution du khi-deux avec 6 degrés de liberté est le suivant :
Exemple
reg [15:0] data_chi_sq;
always@(posedge clk) begin
data_chi_sq <= $dist_chi_square(seed_dis, 6);
end
Distribution t
Supposons que X suit la loi normale standard N(0, 1), et que Y suit la loi du khi-deuxLa distribution de ... est appelée la loi t à n degrés de liberté, notée Z ~ t(n).
La loi t est utilisée pour estimer la moyenne de la population d'une variable de données qui suit une loi normale avec une variance inconnue, à partir de petits échantillons. Si la taille de l'échantillon est suffisamment grande et que la variance de la population est connue, alors la loi normale doit être utilisée pour estimer la moyenne de la population.
La distribution t est une distribution symétrique en forme de cloche, semblable à la distribution normale, mais avec des queues plus lourdes, ce qui signifie qu'elle est plus susceptible de produire des valeurs bien inférieures à la moyenne. Sa fonction de densité de probabilité et son diagramme de distribution sont les suivants :

Le code pour appeler $dist_t afin de générer des données de distribution t avec 5 degrés de liberté est le suivant :
Exemple
reg [15:0] data_t;
always@(posedge clk) begin
data_t <= $dist_t(seed_dis, 5);
end
Distribution d'Erlang
Soient V1, V2, ..., Vn mutuellement indépendants dans un processus de Poisson de paramètre λ, et soit N(t) le nombre de points aléatoires dans [0, t). Alors la distribution de N(t) = V1 + V2 + ... + Vn est appelée distribution d'Erlang.
La distribution d'Erlang, comme la distribution exponentielle, est souvent utilisée pour représenter l'intervalle de temps entre des événements aléatoires indépendants. Une variable aléatoire suivant la distribution d'Erlang peut être décomposée en la somme de plusieurs variables aléatoires de distribution exponentielle de même paramètre, ce qui rend la distribution d'Erlang largement utilisée en théorie de la fiabilité et en théorie des files d'attente.
La fonction de densité de probabilité et le diagramme de distribution de la distribution d'Erlang sont les suivants :

Pourquoi cette tête ? Tu utilises vraiment une idée aussi farfelue pour étoffer la distribution d'Erlang ?
Les tâches de distribution de probabilité ci-dessus ne listent que les méthodes d'appel, sans analyser ni vérifier les données. Ce qui suit présente comment utiliser l'outil de tracé Matlab pour analyser vous-même les caractéristiques des données générées par la tâche de distribution de probabilité $dist_erlang.
Le code pour appeler $dist_erlang afin de générer des données de distribution d'Erlang avec un ordre 3 et une espérance 6 est le suivant :
Exemple
reg [15:0] data_erlang;
always@(posedge clk) begin
data_erlang <= $dist_erlang(seed_dis, 3, 6);
end
Analyse de données
La réalité prouve qu'il est plus pratique d'analyser des données de distribution familières. Sur certaines plateformes, les fonctions intégrées référençables liées à la distribution d'Erlang sont rares. Sachant pertinemment qu'il n'y a pas d'amour (Erlang), nous allons quand même vers l'amour !
Fichiers de données Verilog
Tout d'abord, générez 4 ensembles de données suivant la distribution d'Erlang dans le modèle Verilog et imprimez-les dans un fichier.
Exemple
integer fd1, fd2, fd3, fd30 ;
initial begin
fd1 = $fopen("data_erlang1.hex", "w");
fd2 = $fopen("data_erlang2.hex", "w");
fd3 = $fopen("data_erlang3.hex", "w");
fd30 = $fopen("data_erlang30.hex", "w");
repeat(1000) begin //Prendre 1000 données pour analyse
@(posedge clk) ;
#1 ;
$fdisplay(fd1, "%h", data_erlang1);
$fdisplay(fd2, "%h", data_erlang2);
$fdisplay(fd3, "%h", data_erlang3);
$fdisplay(fd30, "%h", data_erlang30);
end
$fclose(fd1);
$fclose(fd2);
$fclose(fd3);
$fclose(fd30);
end
reg [15:0] data_erlang1;
reg [15:0] data_erlang2;
reg [15:0] data_erlang3;
reg [15:0] data_erlang30;
always@(posedge clk) begin
data_erlang1 <= $dist_erlang(seed_dis, 1, 6);
data_erlang2 <= $dist_erlang(seed_dis, 2, 6);
data_erlang3 <= $dist_erlang(seed_dis, 3, 6);
data_erlang30 <= $dist_erlang(seed_dis, 30, 6);
end
Analyse de données Verilog
Dans Matlab, la fonction d'histogramme hist peut être utilisée directement pour tracer et afficher statistiquement chaque donnée, mais pour une distribution de probabilité, l'effet de tracé réel de cette fonction n'est pas très bon (n'hésitez pas à fournir une meilleure méthode de tracé). Ici, la fonction tabulate de Matlab est utilisée pour compter chaque donnée, puis la fonction plot ordinaire est utilisée pour afficher son pourcentage.
Le code Matlab permettant de lire les données générées par le module Verilog et d'afficher son tracé de distribution est le suivant.
Exemple
%=======================================================
% Analyse de données de $dist_erlang en Verilog
%=======================================================
%Lire comme chaînes de caractères, puis convertir de l'hexadécimal en décimal.
data_erlang1_hex = textread('data_erlang1.hex', '%s') ;
data_erlang2_hex = textread('data_erlang2.hex', '%s') ;
data_erlang3_hex = textread('data_erlang3.hex', '%s') ;
data_erlang30_hex = textread('data_erlang30.hex', '%s') ;
data_erlang1 = hex2dec(data_erlang1_hex);
data_erlang2 = hex2dec(data_erlang2_hex);
data_erlang3 = hex2dec(data_erlang3_hex);
data_erlang30 = hex2dec(data_erlang30_hex);
%Compter les statistiques et les tracer.
num_erlang1 = tabulate(data_erlang1) ;
num_erlang2 = tabulate(data_erlang2) ;
num_erlang3 = tabulate(data_erlang3) ;
num_erlang30 = tabulate(data_erlang30) ;
figure; plot(num_erlang1(:,1)/6, num_erlang1(:,3));
hold on; plot(num_erlang2(:,1)/6, num_erlang2(:,3), 'r');
hold on; plot(num_erlang3(:,1)/6, num_erlang3(:,3), 'g');
hold on; plot(num_erlang30(:,1)/6, num_erlang30(:,3), 'y');
legend('n=1', 'n=2', 'n=3', 'n=30');
Le graphique de distribution des données Erlang généré par le modèle Verilog est présenté ci-dessous.

Espérance de la distribution d'Erlang
Il est important de noter que le paramètre λ est l'espérance de la distribution de Poisson, et non l'espérance de la distribution d'Erlang.
Dans la tâche système Verilog $dist_erlang(seed, k_stage, mean), le troisième paramètre est l'espérance. Si vous substituez directement l'espérance dans le paramètre λ, vous obtiendrez des résultats de distribution incorrects.
Ci-dessous se trouve une dérivation simple (paresseuse) (référence) de l'espérance mathématique de la distribution d'Erlang.
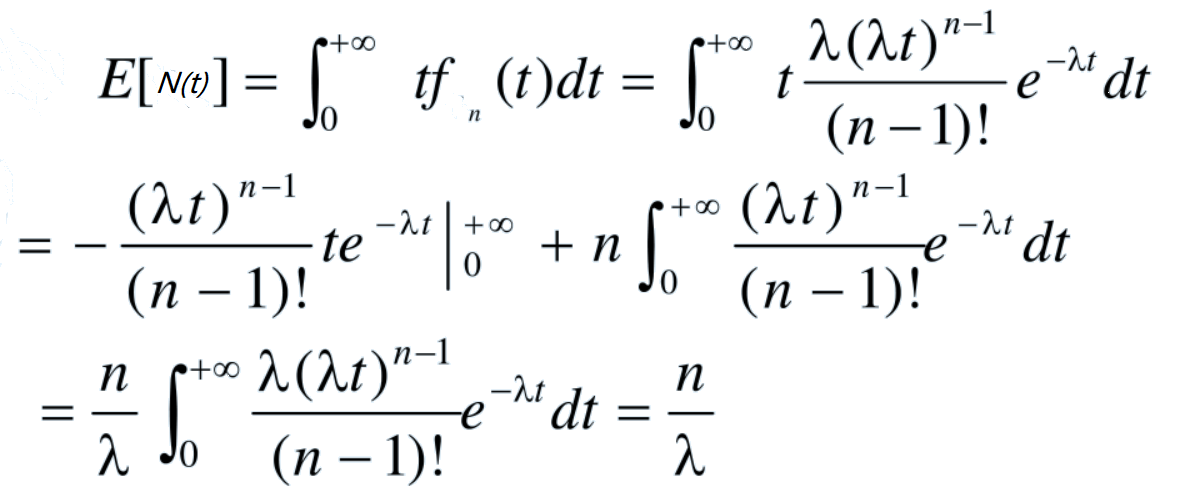
Ci-joint le processus de dérivation de la variance de la distribution d'Erlang.
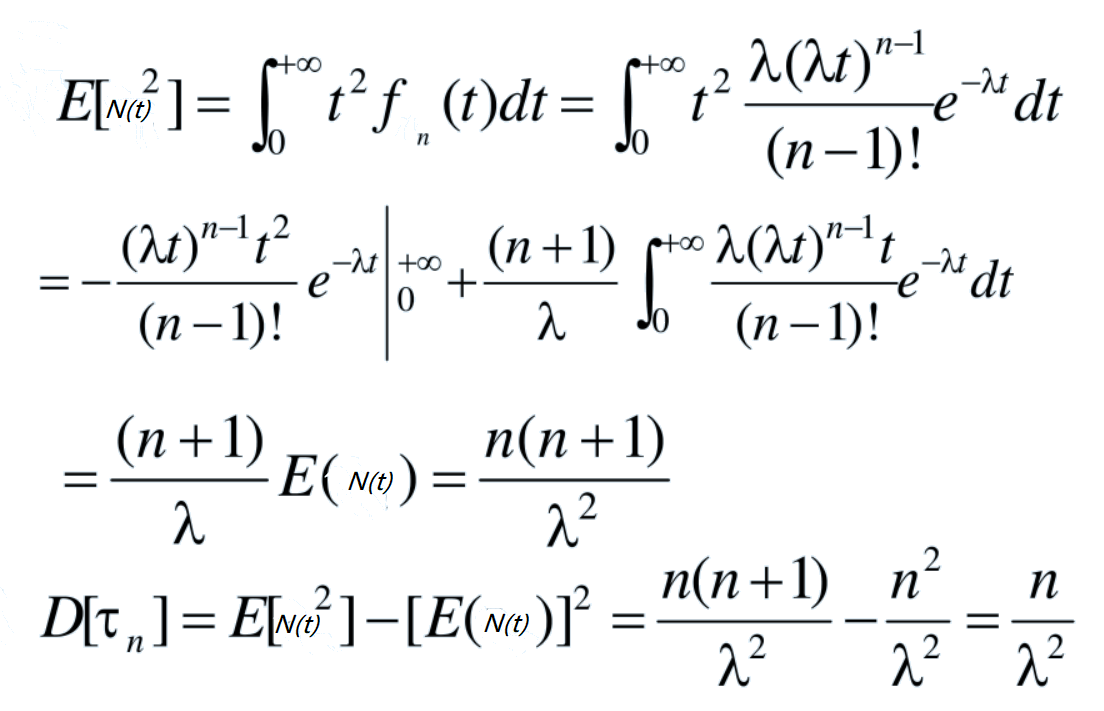
Distribution théorique Matlab
En utilisant la fonction intégrée random de Matlab, vous pouvez générer divers types de données distribuées, mais malheureusement il n'existe pas de distribution d'Erlang.
Ensuite, utilisez la fonction de densité de probabilité pour générer des données qui suivent la distribution d'Erlang.
Ici, l'espérance dans le modèle Verilog est 6, donc le paramètre réel λ = n/6.
Le code permettant à Matlab de générer des données de distribution d'Erlang est le suivant.
Exemple
%=======================================================
% génération de données de distribution d'Erlang
%=======================================================
NUM = 400 ;
EXPECT = 6 ;
for n=[1, 2, 3, 30] //Générer 4 ensembles de données
lamda = n/EXPECT; //Conversion de l'espérance
t = (0:NUM-1)*0.1 ;
pt(n,:) = (lamda).^n *(t).^(n-1)/factorial(n-1) .* exp(-lamda * t) ;
end
figure; plot(t, pt(1,:)*100);
hold on;plot(t, pt(2,:)*100, 'r');
hold on;plot(t, pt(3,:)*100, 'g');
hold on;plot(t, pt(n,:)*100, 'y');
xlabel('t');
ylabel('f(t) / 100%');
legend('n=1', 'n=2', 'n=3', 'n=30');
Le graphique de distribution des données Erlang généré par Matlab est présenté ci-dessous.
En comparant avec les données générées par le modèle Verilog, la plage de distribution, la probabilité de distribution et l'allure de la courbe de distribution des deux sont globalement cohérentes. La seule différence est que Verilog génère des données avec des intervalles de temps plus grands, donc le graphique de distribution n'est pas une courbe lisse.

Téléchargement du code source pour ce chapitre
Téléchargement