Mots-clés : Pipeline, Multiplieur
Un avantage majeur des langages de description matérielle est le parallélisme d'exécution des instructions. Plusieurs instructions peuvent traiter en parallèle plusieurs données de signal dans le même cycle d'horloge.
Cependant, lorsque les données sont entrées en série, le parallélisme d'exécution des instructions ne montre pas son avantage. De plus, dans de nombreux cas, certains calculs ne peuvent pas être achevés en un ou deux cycles d'horloge. Si chaque donnée d'entrée série doit attendre que le calcul précédent soit terminé avant de commencer le calcul suivant, l'efficacité est assez faible. Le pipeline est la solution à la faible efficacité du calcul de données en série sur plusieurs cycles.
Pipeline
L'idée de base du pipeline est de décomposer un processus répété en plusieurs sous-processus, chacun implémenté par une unité fonctionnelle dédiée. Plusieurs processus de traitement sont décalés dans le temps et traversent séquentiellement les étages fonctionnels, de sorte que chaque sous-processus puisse être exécuté en parallèle avec les autres sous-processus.
Supposons que le processus de lavage du linge dans une laverie automatique soit divisé en 4 étapes : collecte du linge, lavage, séchage et rangement dans les armoires. Chaque étape prend une demi-heure, donc laver le linge une fois prend 2 heures.
Considérez le pire cas : la laverie ne dispose que d’une seule machine à laver, d’un seul sèche-linge et d’un seul casier. Si un lot de linge est livré toutes les demi-heures, et que chaque fois vous devez attendre 2 heures que le lot précédent termine son lavage, alors laver 4 lots de linge prend 8 heures.
Le schéma est le suivant :

Modernisez l’équipement de cette laverie en introduisant 4 ensembles d’équipements de blanchisserie au total, et augmentez le personnel à 4 personnes, chacune responsable d’une étape du processus de lavage. Par conséquent, chaque lot de linge peut être immédiatement placé dans différentes machines à laver par la même personne. Comme les horaires sont décalés, chaque lot de linge peut être lavé, séché et rangé dans les casiers par les mêmes personnes utilisant différents équipements et créneaux horaires (une demi-heure). Le schéma est le suivant.
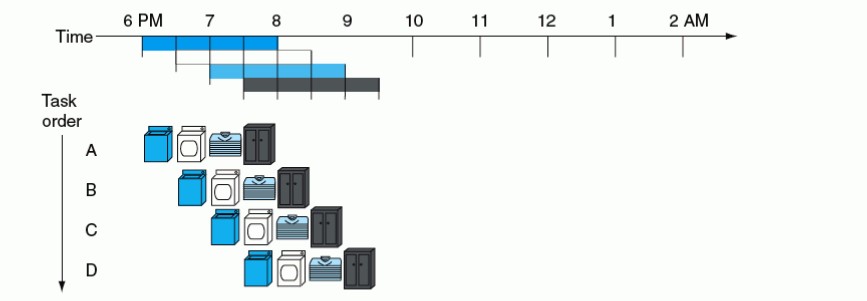
On peut voir que laver 4 lots de linge ne prend que 3.5 heures, ce qui améliore considérablement l’efficacité.
En fait, après 2 heures, le premier ensemble d’équipements de blanchisserie a terminé le processus de lavage et est inactif. Si un 5e lot de linge est envoyé à ce moment-là, le premier ensemble d’équipements peut se remettre à fonctionner. Par analogie, tant que des lots de linge sont introduits en continu, les 4 ensembles d’équipements de blanchisserie peuvent achever en continu le processus de nettoyage de tout le linge. À l’exception du premier lot qui prend 2 heures, un lot de linge sera lavé et terminé toutes les demi-heures par la suite.
Plus il y a de lots de linge, plus le temps gagné est évident. S’il y a N lots de linge, le temps nécessaire est de (4+N) demi-heures.
Bien sûr, le processus de blanchisserie modernisé présente aussi des inconvénients. L’augmentation des équipements et du personnel accroît le coût d’investissement, réduit l’espace restant dans la laverie et rend l’état de fonctionnement plus chargé.
Semblable au processus de lavage, le chemin de traitement des données peut aussi être considéré comme une chaîne de production. Chaque unité de traitement numérique sur le chemin peut être considérée comme une étape, ce qui introduit un délai.
La conception de pipeline divise systématiquement le chemin en unités de traitement numériques (étages), et insère des registres entre les unités de traitement pour stocker temporairement les données intermédiaires. Les unités divisées peuvent s'exécuter en parallèle par étage sans s'affecter mutuellement. Par conséquent, la conception de pipeline peut finalement améliorer le débit de données, c'est-à-dire augmenter la vitesse de traitement des données.
L'inconvénient de la conception de pipeline est que chaque étage de traitement nécessite des registres supplémentaires pour sauvegarder les états de calcul intermédiaires, et que plusieurs instructions exécutées en parallèle augmentent inévitablement la consommation d'énergie.
Ensuite, un multiplicateur est conçu, et une comparaison est faite entre l'adoption et la non-adoption de la conception de pipeline.
Conception générale d'un multiplicateur
Introduction
Peut-être quelqu'un demandera-t-il : utiliser directement le signe de multiplication*pour effectuer la multiplication de deux nombres, n'est-ce pas plus rapide et plus simple ?
Si vous avez ce doute, cela signifie que votre compréhension des langages de description matérielle est encore insuffisante. Comme mentionné précédemment, Verilog décrit des circuits matériels. Lorsque l'on utilise directement le signe de multiplication pour effectuer le processus de multiplication, le compilateur mappe cette expression de multiplication vers un multiplicateur par défaut lors de la compilation, mais sa structure est inconnue.
Par exemple, dans la conception FPGA, un cœur IP peut être appelé directement pour générer un multiplicateur hautes performances. Lorsque la largeur de bits est faible, le résultat peut être produit en un cycle ; lorsque la largeur de bits est grande, il peut également être produit de manière pipeline. Sous réserve que les exigences puissent être satisfaites, vous pouvez l'utiliser avec prudence*ou appeler directement l'IP pour effectuer l'opération de multiplication.
Mais l'IP de multiplicateur présente aussi de nombreux défauts, tels que des limitations de largeur de bits, un timing inconnu, etc. En particulier, l'utilisation du signe de multiplication peut enfouir un grand danger caché pour l'incertitude de la conception numérique.
Dans de nombreux cas, la multiplication par une constante est implémentée sous la forme d'un décalage et d'une addition, par exemple :
Exemple
A = (A<<1) + A ; // correspond à A * 3
A = (A<<3) + (A<<2) + (A<<1) + A ; // correspond à A * 15
Un registre à décalage et un additionneur peuvent réaliser l’opération de multiplication par 3. Mais multiplier par 15 nécessite 3 registres à décalage et 3 additionneurs (bien sûr, multiplier par 15 peut aussi être réalisé par décalage et soustraction).
Parfois, un circuit numérique ne peut pas effectuer l’addition de plusieurs variables simultanément dans un seul cycle. Par conséquent, en conception numérique, l’opération d’addition la plus sûre consiste à n’additionner que 2 éléments de données en même temps ; la pire conception consiste à additionner 4 éléments de données ou plus en même temps.
Si la conception contient une opération qui additionne 4 éléments de données en même temps, alors cette partie de la conception est dangereuse et peut provoquer des violations de timing.
À ce stade, un multiplicateur pipeline avec des paramètres de conception configurables et un timing contrôlable devient nécessaire.
Principe de conception
Semblable à la multiplication décimale, le processus de multiplication de 13 par 5 est illustré ci-dessous :
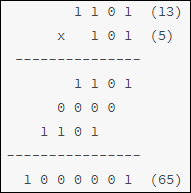
On peut en déduire que le multiplicande est décalé et accumulé en fonction du bit correspondant du multiplicateur, ce qui achève ainsi le processus de multiplication.
En supposant qu’une seule accumulation puisse être effectuée par cycle, le nombre minimal de cycles d’horloge pour une multiplication est exactement la largeur de bits du multiplicateur. Par conséquent, il est recommandé d’utiliser le nombre ayant la plus petite largeur de bits comme multiplicateur, afin que la période de calcul soit plus courte.
Conception du multiplicateur
Étant donné que chaque opération de multiplication ne peut produire qu’un seul résultat (conception non pipeline), le code de conception est le suivant.
Exemple
#(paramètre N=4,
paramètre M=4)
(
input clk,
input rstn,
input data_rdy , // validation de l'entrée de données
input [N-1:0] mult1, // multiplicande
input [M-1:0] mult2, // multiplicateur
output res_rdy , // validation de la sortie de données
output [N+M-1:0] res // résultat de la multiplication
);
//calculer le compteur
reg [31:0] cnt ;
// compteur de cycles de multiplication
wire [31:0] cnt_temp = (cnt == M)? 'b0 : cnt + 1'b1 ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
cnt <= 'b0 ;
end
else if (data_rdy) begin // commencer le comptage lorsque les données sont activées
cnt <= cnt_temp ;
end
else if (cnt != 0 ) begin // empêcher que la durée d'activation de l'entrée soit trop courte
cnt <= cnt_temp ;
end
else begin
cnt <= 'b0 ;
end
end
//multiplier
reg [M-1:0] mult2_shift ;
reg [M+N-1:0] mult1_shift ;
reg [M+N-1:0] mult1_acc ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
mult2_shift <= 'b0 ;
mult1_shift <= 'b0 ;
mult1_acc <= 'b0 ;
end
else if (data_rdy && cnt=='b0) begin // initialisation
mult1_shift <= {{(N){1'b0}}, mult1} << 1 ;
mult2_shift <= mult2 >> 1 ;
mult1_acc <= mult2[0] ? {{(N){1'b0}}, mult1} : 'b0 ;
end
else if (cnt != M) begin
mult1_shift <= mult1_shift << 1 ; // multiplicande multiplié par 2
mult2_shift <= mult2_shift >> 1 ; // décaler le multiplicateur vers la droite pour faciliter le contrôle
// vérifier si le bit correspondant du multiplicateur est 1 ; si c'est 1, accumuler
mult1_acc <= mult2_shift[0] ? mult1_acc + mult1_shift : mult1_acc ;
end
else begin
mult2_shift <= 'b0 ;
mult1_shift <= 'b0 ;
mult1_acc <= 'b0 ;
end
end
//résultats
reg [M+N-1:0] res_r ;
reg res_rdy_r ;
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
res_r <= 'b0 ;
res_rdy_r <= 'b0 ;
end
else if (cnt == M) begin
res_r <= mult1_acc ; // sortir le résultat à la fin des cycles de multiplication
res_rdy_r <= 1'b1 ;
end
else begin
res_r <= 'b0 ;
res_rdy_r <= 'b0 ;
end
end
assign res_rdy = res_rdy_r;
assign res = res_r;
endmodule
testbench
Exemple
module test ;
paramètre N = 8 ;
paramètre M = 4 ;
reg clk, rstn;
//horloge
always begin
clk = 0 ; #5 ;
clk = 1 ; #5 ;
end
//réinitialisation
initial begin
rstn = 1'b0 ;
#8 ; rstn = 1'b1 ;
end
//pas de pipeline
reg data_rdy_low ;
reg [N-1:0] mult1_low ;
reg [M-1:0] mult2_low ;
wire [M+N-1:0] res_low ;
wire res_rdy_low ;
// utiliser une tâche pour un stimulus périodique
task mult_data_in ;
input [M+N-1:0] mult1_task, mult2_task ;
begin
wait(!test.u_mult_low.res_rdy) ; //pas l'état de sortie
@(negedge clk ) ;
data_rdy_low = 1'b1 ;
mult1_low = mult1_task ;
mult2_low = mult2_task ;
@(negedge clk ) ;
data_rdy_low = 1'b0 ;
wait(test.u_mult_low.res_rdy) ; //tester l'état de sortie
end
endtask
//pilote
initial begin
#55 ;
mult_data_in(25, 5 ) ;
mult_data_in(16, 10 ) ;
mult_data_in(10, 4 ) ;
mult_data_in(15, 7) ;
mult_data_in(215, 9) ;
end
mult_low #(.N(N), .M(M))
u_mult_low
(
.clk (clk),
.rstn (rstn),
.data_rdy (data_rdy_low),
.mult1 (mult1_low),
.mult2 (mult2_low),
.res_rdy (res_rdy_low),
.res (res_low));
//fin de simulation
initial begin
forever begin
#100;
if ($time >= 10000) $finish ;
end
end
endmodule // test
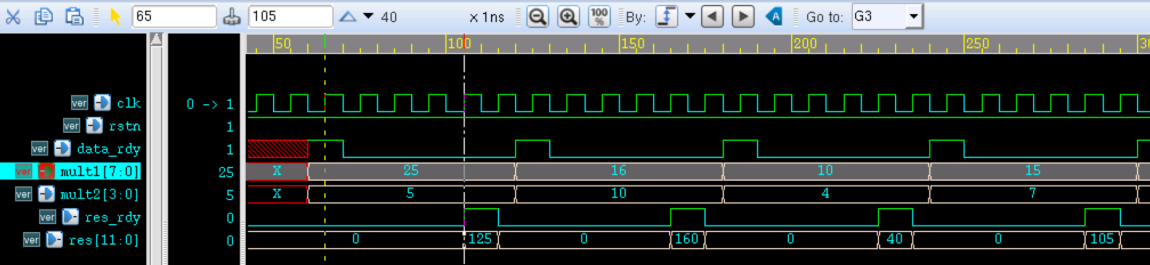
Les résultats de la simulation sont les suivants.
Comme on peut le voir sur la figure, les deux éléments de données d'entrée obtiennent le résultat de multiplication correct après un délai de 4 cycles. En incluant le temps de latence de l'entrée des données intermédiaires, le calcul de 4 multiplications prend environ 20 cycles d'horloge.
Conception d'un multiplicateur pipeline
Ensuite, les états intermédiaires du processus d'exécution de la multiplication sont sauvegardés pour permettre un fonctionnement en pipeline. Le code de conception est le suivant.
Le fichier de code pour un processus de calcul d'accumulation unique est le suivant (mult_cell.v):
Exemple
#(paramètre N=4,
paramètre M=4)
(
input clk,
input rstn,
input en,
input [M+N-1:0] mult1, // multiplicande
input [M-1:0] mult2, // multiplicateur
input [M+N-1:0] mult1_acci, // résultat d'accumulation précédent
output reg [M+N-1:0] mult1_o, // valeur sauvegardée après décalage du multiplicande
output reg [M-1:0] mult2_shift, // valeur sauvegardée après décalage du multiplicateur
output reg [N+M-1:0] mult1_acco, // résultat d'accumulation actuel
output reg rdy );
always @(posedge clk or negedge rstn) begin
if (!rstn) begin
rdy <= 'b0 ;
mult1_o <= 'b0 ;
mult1_acco <= 'b0 ;
mult2_shift <= 'b0 ;
end
else if (en) begin
rdy <= 1'b1 ;
mult2_shift <= mult2 >> 1 ;
mult1_o <= mult1 << 1 ;
if (mult2[0]) begin
// accumuler si le bit correspondant du multiplicateur vaut 1
mult1_acco <= mult1_acci + mult1 ;
end
else begin
mult1_acco <= mult1_acci ; // conserver si le bit correspondant du multiplicateur est 1
end
end
else begin
rdy <= 'b0 ;
mult1_o <= 'b0 ;
mult1_acco <= 'b0 ;
mult2_shift <= 'b0 ;
end
end
endmodule
Instanciation de niveau supérieur
Plusieurs instanciations de module réalisent plusieurs accumulations. Le fichier de code est le suivant (mult_man.v) :
Exemple
#(paramètre N=4,
paramètre M=4)
(
input clk,
input rstn,
input data_rdy ,
input [N-1:0] mult1,
input [M-1:0] mult2,
output res_rdy ,
output [N+M-1:0] res );
wire [N+M-1:0] mult1_t [M-1:0] ;
wire [M-1:0] mult2_t [M-1:0] ;
wire [N+M-1:0] mult1_acc_t [M-1:0] ;
wire [M-1:0] rdy_t ;
// La première instanciation est équivalente à une initialisation ; l'instruction generate ne peut pas être utilisée
mult_cell #(.N(N), .M(M))
u_mult_step0
(
.clk (clk),
.rstn (rstn),
.en (data_rdy),
.mult1 ({{(M){1'b0}}, mult1}),
.mult2 (mult2),
.mult1_acci ({(N+M){1'b0}}),
//sortie
.mult1_acco (mult1_acc_t[0]),
.mult2_shift (mult2_t[0]),
.mult1_o (mult1_t[0]),
.rdy (rdy_t[0]) );
// Les instanciations multiples de modules utilisent l'instruction generate
genvar i ;
generate
for(i=1; i<=M-1; i=i+1) begin: mult_stepx
mult_cell #(.N(N), .M(M))
u_mult_step
(
.clk (clk),
.rstn (rstn),
.en (rdy_t[i-1]),
.mult1 (mult1_t[i-1]),
.mult2 (mult2_t[i-1]),
// Le résultat d'accumulation précédent est utilisé comme entrée pour l'accumulation suivante
.mult1_acci (mult1_acc_t[i-1]),
//sortie
.mult1_acco (mult1_acc_t[i]),
.mult1_o (mult1_t[i]), // transfert d'état de décalage du multiplicande
.mult2_shift (mult2_t[i]), // transfert d'état de décalage du multiplicateur
.rdy (rdy_t[i]) );
end
endgenerate
assign res_rdy = rdy_t[M-1];
assign res = mult1_acc_t[M-1];
endmodule
testbench
Ajoutez la description de simulation suivante au banc de test de l'exemple de conception de multiplicateur non pipeliné afin d'obtenir les résultats de simulation de l'opération de multiplication pipelinée.
Les 2 canaux de données sont fournis en entrée en continu et en série, et un module d'auto-vérification est inclus pour déterminer automatiquement l'exactitude des résultats de multiplication.
Exemple
reg [N-1:0] mult1 ;
reg [M-1:0] mult2 ;
wire res_rdy ;
wire [N+M-1:0] res ;
//pilote
initial begin
#55 ;
@(negedge clk ) ;
data_rdy = 1'b1 ;
mult1 = 25; mult2 = 5;
#10 ; mult1 = 16; mult2 = 10;
#10 ; mult1 = 10; mult2 = 4;
#10 ; mult1 = 15; mult2 = 7;
mult2 = 7; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 1; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 15; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 3; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 11; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 4; repeat(32) #10 mult1 = mult1 + 1 ;
mult2 = 9; repeat(32) #10 mult1 = mult1 + 1 ;
end
// décaler les données d'entrée pour faciliter la vérification ultérieure
reg [N-1:0] mult1_ref [M-1:0];
reg [M-1:0] mult2_ref [M-1:0];
always @(posedge clk) begin
mult1_ref[0] <= mult1 ;
mult2_ref[0] <= mult2 ;
end
genvar i ;
generate
for(i=1; i<=M-1; i=i+1) begin
always @(posedge clk) begin
mult1_ref[i] <= mult1_ref[i-1];
mult2_ref[i] <= mult2_ref[i-1];
end
end
endgenerate
// auto-vérification
reg error_flag ;
always @(posedge clk) begin
# 1 ;
if (mult1_ref[M-1] * mult2_ref[M-1] != res && res_rdy) begin
error_flag <= 1'b1 ;
end
else begin
error_flag <= 1'b0 ;
end
end
//instanciation de module
mult_man #(.N(N), .M(M))
u_mult
(
.clk (clk),
.rstn (rstn),
.data_rdy (data_rdy),
.mult1 (mult1),
.mult2 (mult2),
.res_rdy (res_rdy),
.res (res));
Résultats de simulation
Les résultats de simulation des premières dizaines de cycles d’horloge sont les suivants.
Comme on peut le voir sur la figure, le signal de vérification du résultat de simulation error_flag reste à 0, ce qui indique que la conception du multiplicateur est correcte.
Les données sont saisies en série en continu sous la commande de l’horloge. Après un retard de 4 cycles d’horloge, les résultats de sortie de multiplication sont également émis en continu à chaque cycle d’horloge sans retard supplémentaire, réalisant ainsi un fonctionnement en pipeline.
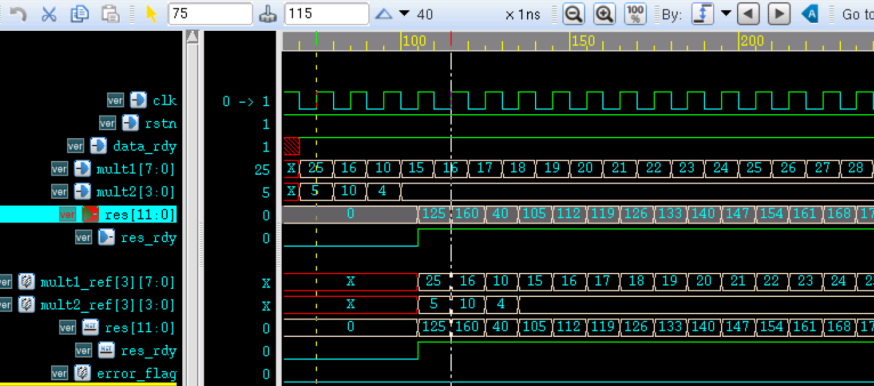
Par rapport aux multiplicateurs généraux qui n’utilisent pas de pipeline, l’efficacité de multiplication est grandement améliorée.
Cependant, les ressources de registres utilisées par le multiplicateur pipeline sont également environ 4 fois celles du précédent multiplicateur sans pipeline.
Par conséquent, le choix d’adopter ou non une conception en pipeline dans une conception numérique doit être mis en balance en termes de ressources et d’efficacité.
Téléchargement du code source
Téléchargement